本文转载自机器之心。
近期,Meta Muse、OpenAI Dot 等产品相继发布,让 Personal Agent(个人智能体)再次成为大模型领域的热点。与传统对话助手不同,这类 Agent 不再满足于被动回答,而是结合个人背景、历史记忆和应用上下文,主动推进任务并持续跟进长期目标。一个更主动、能长期陪伴用户的 AI 助手,正在逐步走向现实。
但长期记忆只是 Personal Agent 的起点。记住用户做过什么,不等于知道用户此刻需要什么。真实场景中,用户很少明确说出每个需求:做菜时反复看步骤、操作软件卡壳、任务中途改变计划,这些细微的行为和环境变化都可能暗含新的协助需求。如何从持续变化的环境里捕捉这些信号,读懂用户尚未表达的意图,并判断何时、如何介入,是 Personal Agent 落地真实世界必须跨越的坎。
针对这一问题,Google 等研究团队提出了 StreamVibe,专注于动态环境下的主动式视频智能体。通过持续观察视频流和交互过程,Agent 既能识别用户的显式请求,也能挖掘隐藏在行为中的潜在意图,并随任务推进同步更新对目标的理解。研究还构建了覆盖显式、隐式和动态演变需求三类场景的评测与训练体系,推动 Agent 从被动等待指令向主动理解、适时介入、灵活调整的智能伙伴演进。
现实交互中的用户意图会持续变化
“水开了提醒我”与“帮我把这道菜做好”,对助手的要求完全不同。前者给出了明确的触发条件;后者只交代目标,助手必须结合正在发生的事,判断何时介入、给出什么帮助。
真实任务中还会持续产生新信息。用户可能已经完成某一步,刚才还管用的建议转眼就成了重复提醒;也可能临时改需求,原来的计划随即失效。即使有完整历史,助手也要分得清:哪些要求依然有效、哪些步骤已经完成、眼下出现的新情况到底意味着什么。
StreamVibe 因此把主动视频交互嵌入到持续变化的用户—助手—环境关系里。模型既要吃透当前视觉证据,也要结合历史对话和用户的新反馈,不断刷新对任务与意图的判断。
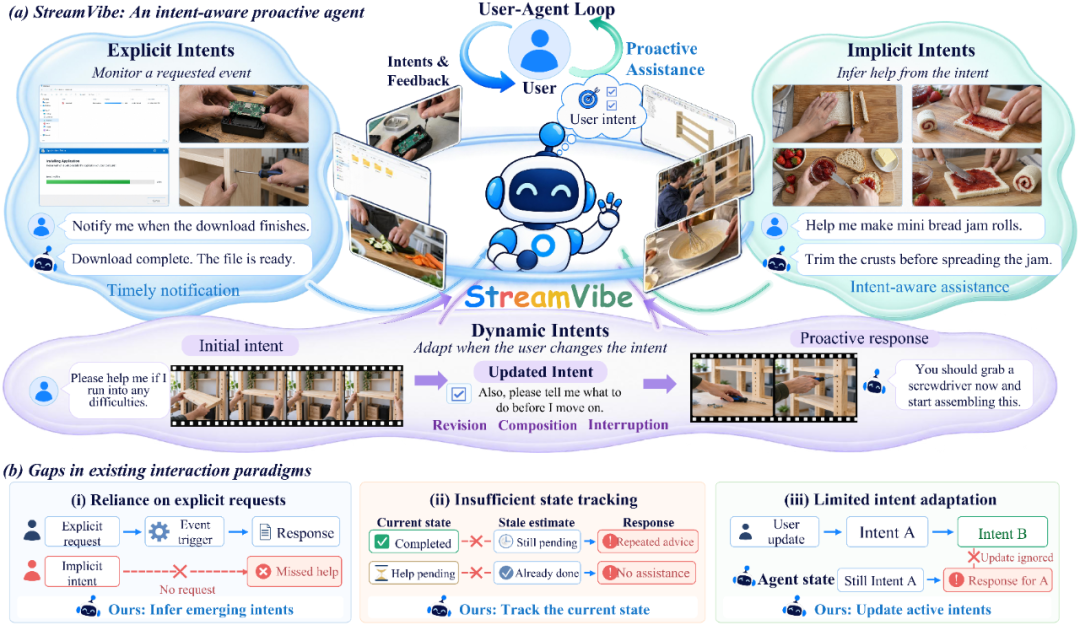
图 1:StreamVibe 研究概览。上方展示显式、隐式与动态意图下的持续交互,下方归纳对明确请求的依赖、状态跟踪不足与意图更新困难。
这也对 Personal Agent 提出了更具体的能力要求:既要记住过去,也要持续从新交互中获取证据,形成对当前任务的有效理解。
把三类用户意图放进同一套评测
研究团队构建了 StreamVibe-Bench,同时覆盖物理现实活动与数字界面任务,并依据意图明确程度和变化方式划分为三个层次。
显式意图由用户直接指定事件或条件,例如“水烧开时告诉我”,涵盖单次事件、状态转换和重复事件。隐式意图只给总体目标,例如“帮我完成这道菜”,助手需要根据过程推断何时帮助,涉及指导、学习、监测与工具使用等场景。
动态意图则进一步纳入任务过程中的变化:Revision 修改既有要求,Composition 叠加新目标或约束条件,Interruption 插入必须马上处理的问题。助手在更新任务状态的同时,还要继续维护仍然有效的需求。
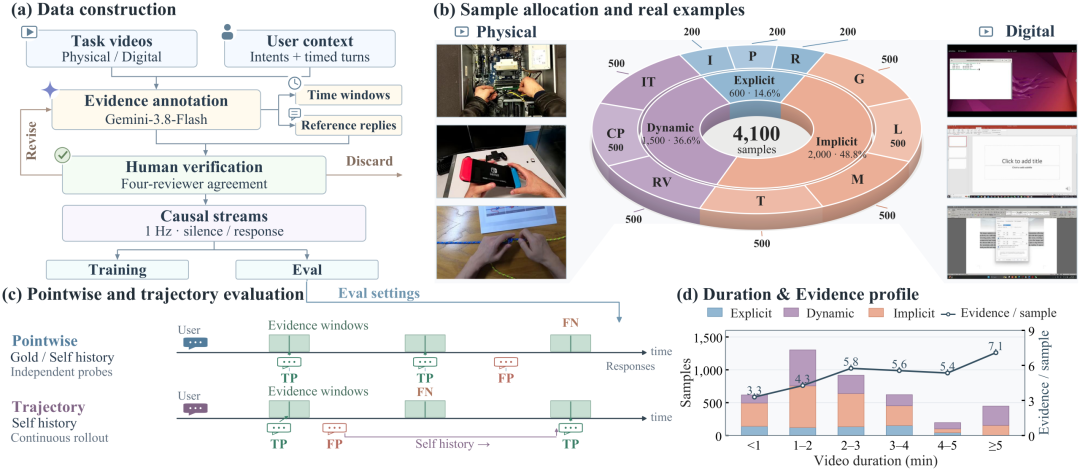
图 2:StreamVibe-Bench 的构建与统计,包含候选帮助点标注、人工核验、三类意图与场景分布,以及逐点和轨迹评测。
整个基准包含 4,100 个评测样本、20,546 个帮助点和 183.4 小时视频,三类意图样本量分别为 600、2,000 和 1,500。每个候选帮助点都带有响应时间窗口和参考回答,需经四位评审独立核验并全部通过才予以保留。
评测既考察单个时刻的局部判断,也考察完整视频流里的持续交互。后者要求模型承接自己的历史输出继续运行,能暴露重复提醒、漏答、错误累积和意图跟踪失误等问题。
让模型学习主动回应并持续跟踪任务
StreamVibe 将问题拆成互相配合的两个层面:先训练模型判断何时、如何提供帮助;运行时再根据新观察与反馈,持续更新意图、任务进度和相关记忆。
策略学习采用两阶段训练。第一阶段是自适应流式监督微调,根据训练分布平衡 silence 与 response 决策,同时学习回答内容,避免模型一直沉默或过度回应。第二阶段是局部轨迹强化学习,围绕帮助点构造短时间因果 rollout,利用 GRPO 联合优化回应时机、内容质量和连续交互的一致性。
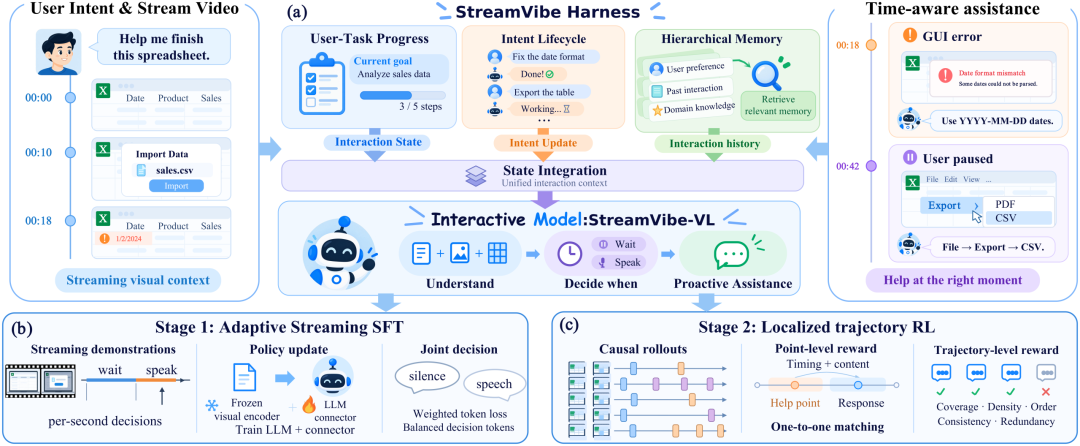
图 3:StreamVibe 方法框架。推理时持续维护当前状态与相关记忆;训练时结合自适应流式 SFT 和局部轨迹 RL。
训练数据包含 70K 条任务相关 SFT 样本和 15K 个 RL 种子任务,合称 StreamVibe-85K;SFT 另混入 768K 条通用流式视频样本。强化学习既评估单次回应的时机和内容,也约束整段输出中的遗漏、重复和不一致。
运行时,StreamVibe-Harness 保存当前活跃意图、任务与环境进度,以及已给出的回应。新信息到来后,各项要求可以独立新增、修订或结束;分层记忆保留近期细节、压缩较早历史,并按当前任务检索相关证据。
这些信息交给模型后,由模型决定是否回应以及回应的具体内容;交互结果再写回状态与记忆,用于后续决策。记忆与当下交互由此共同支撑对用户需求的持续理解。
实验结果
团队将 StreamVibe 与闭源模型、开源离线模型和开源流式模型进行了比较。主表在 ±2 秒的时间匹配容差下,同时报告回应时机与内容质量,并区分基于标准历史的逐点评测与使用自身历史输出的完整轨迹评测。
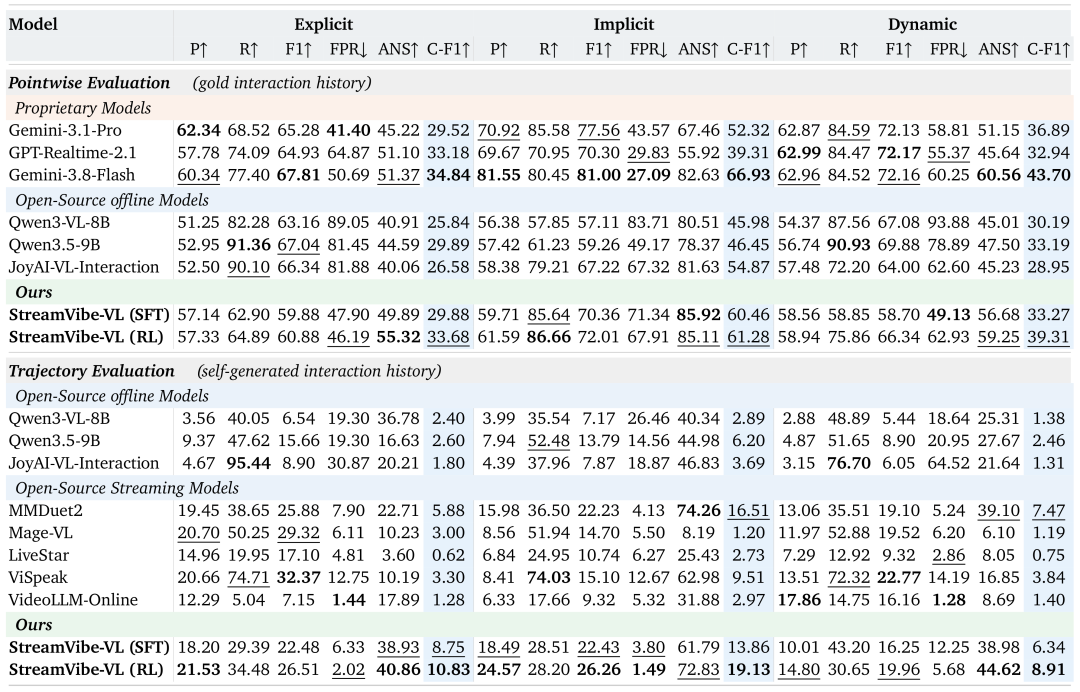
表 1:StreamVibe-Bench 的完整主实验结果,来自论文表 2。P、R、F1 衡量回应时机,FPR 衡量误触发,ANS 与 C-F1 衡量内容表现。
在完整轨迹评测中,StreamVibe-VL(RL)在三类意图上的 Content F1 分别为 10.83、19.13 和 8.91,均高于论文列出的开源基线;与 MMDuet2 相比,分数差分别为 4.95、2.62 和 1.44。
逐点评测中,模型在隐式意图上的 Content F1 达到 61.28,动态意图为 39.31。两种协议对应不同条件:逐点判断可使用标准历史,完整轨迹则必须承接自身输出,因此两类数值不能直接混用。
该能力也能迁移到外部主动交互基准:EgoProactive 的 Macro 分数从基座的 46.2 提升至 59.5,IPIBench 的 Understanding 分数从 9.8 提升至 20.4;同时,通用视频理解能力没有明显损失。
持续交互仍然是主要挑战
完整结果表也在提醒我们:局部判断正确,不代表助手能全程可靠工作。论文进一步分析了不同意图与任务类型、误触发、自生成历史和交互时长对模型表现的影响。
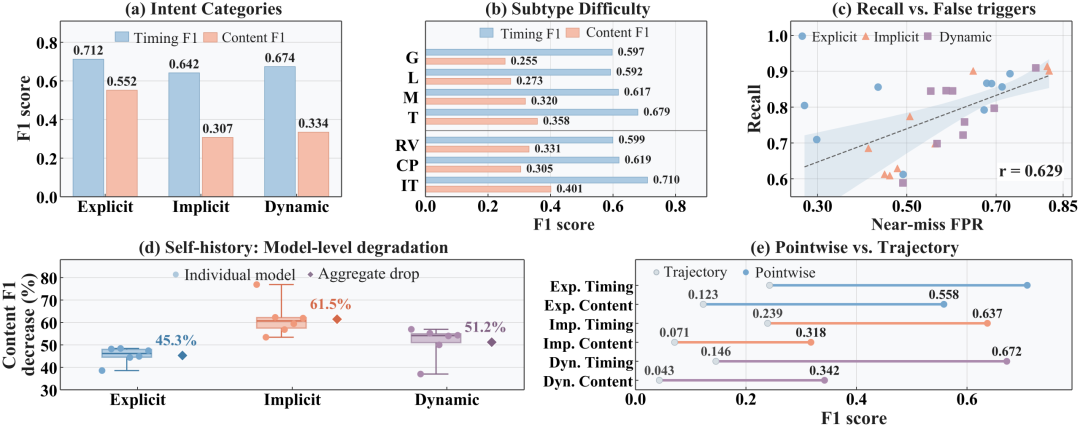
图 4:主动交互诊断结果,对应论文图 5。包含意图与子类型差异、召回与误触发的关系,以及自生成历史和完整轨迹对表现的影响。
首先,隐式与动态需求的内容质量还有明显提升空间。助手不仅要识别用户未说出口的需求,还要跟踪修订、叠加与中断带来的变化。其次,更高召回往往伴随更多误触发,说明在覆盖更多帮助机会与避免打扰之间,平衡依然很难拿捏。
自生成历史会进一步放大问题:先前错误可能影响后续判断,导致内容质量下滑。相较于只考察独立时刻的评测,完整轨迹更能暴露这种差距,也更贴近持续协助的真实要求。
策略学习与状态跟踪分别带来什么
论文通过训练与状态管理的对比,进一步区分了这两类改进的作用。SFT 让模型更容易发现帮助机会,但也可能增加不必要的回应;RL 进一步改善回应选择,降低误触发并提高回答质量。
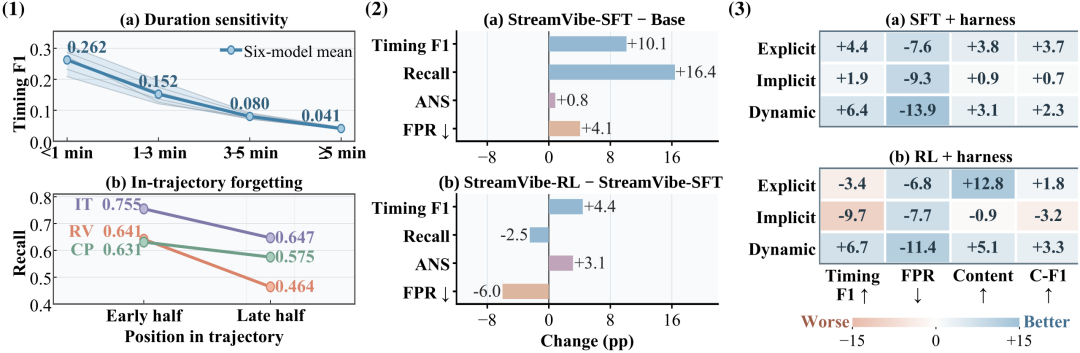
图 5:交互长度、策略学习与状态管理的影响,对应论文图 6。左列观察时长及动态意图前后半程差异,中列比较 SFT 与 RL,右列分析 Harness 的变化。
在策略固定时引入 Harness,论文显示不必要的回应进一步减少,动态意图的提升更明显。但不同指标之间仍有权衡,状态管理并不能让所有指标同步上升。
图中六模型均值还显示,视频越长,Timing F1 就越低;Revision 场景后半程的召回下降更为明显。这说明,当用户持续修改要求时,助手必须反复确认哪些意图仍然有效,而不是把历史原样保存起来。
对 Personal Agent 来说,这两条路径互为补充:策略学习提升对眼前证据的判断,状态与记忆管理则让后续决策始终围绕当前仍有效的需求展开。
结语
Personal Agent 要真正实现个性化,不只要记住用户的过去,更要在实际交互中持续理解当下需求。未来的 Personal Agent 应该形成“用户—环境—Agent”的持续交互闭环:从行为与反馈中了解需求,从环境变化中判断任务进展,并在交互中不断调整对意图的理解和协助方式。
StreamVibe 为这一方向提供了初步探索。借助交互策略学习与持续状态管理,Agent 能够跟踪任务进展,并依据需求变化调整协助策略。未来,如何把这一能力延伸到更长时间跨度、更复杂的真实场景,并充分利用交互过程中的用户反馈,仍有许多问题值得深挖。对这类 Agent 方向感兴趣的开发者,也可以在云栈社区关注后续的技术讨论。
 发表于 1 小时前
|
查看: 8|
回复: 0
 /1


