TPAMI 2026 · 已发表
论文题目: LargeAD: Large-Scale Cross-Sensor Data Pretraining for Autonomous Driving
期刊信息: IEEE Transactions on Pattern Analysis and Machine Intelligence,48(2): 1291–1308,2026
论文地址: arXiv:2501.04005
正式发表: DOI: 10.1109/TPAMI.2025.3617126
道路数据可以持续采集,但精细的三维标注却很难跟上这样的节奏。一段行车记录中,激光雷达会留下大量空间点,而训练感知模型还需要知道哪些点属于车辆、行人、道路或建筑。这些信息如果主要靠人工逐帧整理,数据规模越大,标注投入就越难承受。
图像领域已经积累了另一类资源:经过大规模训练的视觉基础模型,能够从照片中划分物体与场景区域。能否利用这些现成知识,让激光雷达模型先从未标注的道路数据中学习,再用较少标注适应具体任务?发表于 TPAMI 2026 的 LargeAD,正是围绕这一问题建立的跨传感器预训练框架。
从照片中的物体,找到点云里的对应区域
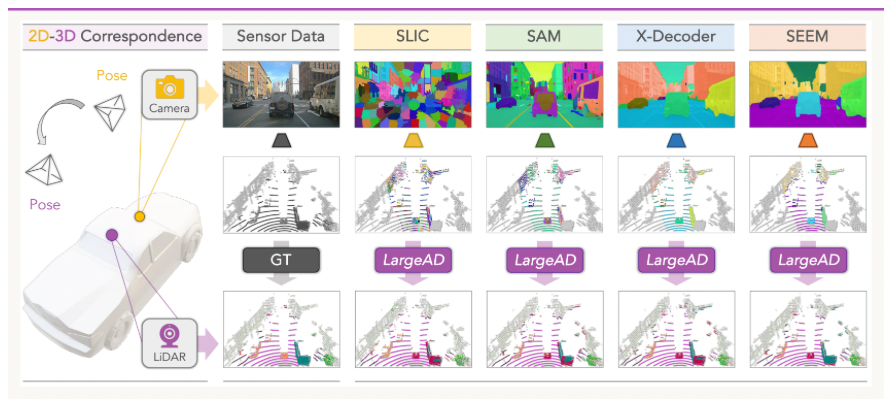
摄像头记录颜色、纹理和外观,激光雷达 (LiDAR) 记录物体表面的三维位置。同一辆车在两种数据中呈现得很不一样,但经过标定,可以把点云投影到对应图像上,建立两者之间的联系。
LargeAD 利用视觉基础模型 (Vision Foundation Model, VFM) 生成具有语义信息的图像区域,再将这些区域映射到点云中。方法希望学到的是:图像里属于同一物体或具有相近语义的内容,在三维表示里也能形成更合理的对应关系。
这里的区域划分非常关键。按照颜色、亮度等低层线索切分图像,可能把一辆车分成许多小块;若训练又把这些小块当作彼此不同的对象,就会让本来应该接近的表示互相排斥。基础模型提供的语义线索,有助于减少这种不必要的冲突。
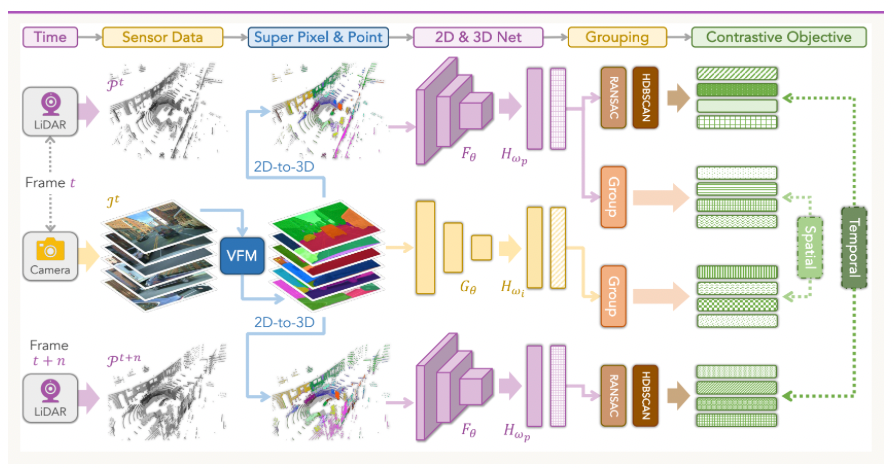
在具体训练中,LargeAD 通过对比学习 (Contrastive Learning),拉近对应图像区域与点云区域的特征。同时,它还结合相邻时刻的点云约束,让模型对同一物体的表示保持稳定,并让同一区域内的点形成更一致的特征。
这属于自监督预训练 (Self-Supervised Pretraining):训练信号来自已有模型、传感器对应关系与时间结构,预训练阶段不需要新增人工二维、三维语义标注。之后进行具体的分割或检测任务时,仍按相应实验设置使用标注数据。
少量标注下,预训练能带来多大帮助?
LargeAD 的实验覆盖线性探测、不同标注比例的微调,以及多个下游任务。线性探测 (Linear Probing) 固定预训练后的主干,只训练线性分类头,主要用来检查学到的特征是否已经具有可利用的信息。
在 nuScenes 验证集上,采用 ViT-B 图像编码器 与 MinkUNet 三维主干时,LargeAD 的线性探测结果为 47.84% mIoU。在使用 1% 标注数据进行微调的设置下,达到 48.37% mIoU;同一主表中的随机初始化结果为 30.30%。采用 ViT-L 图像编码器的配置,1% 标注微调结果进一步达到 49.21%。
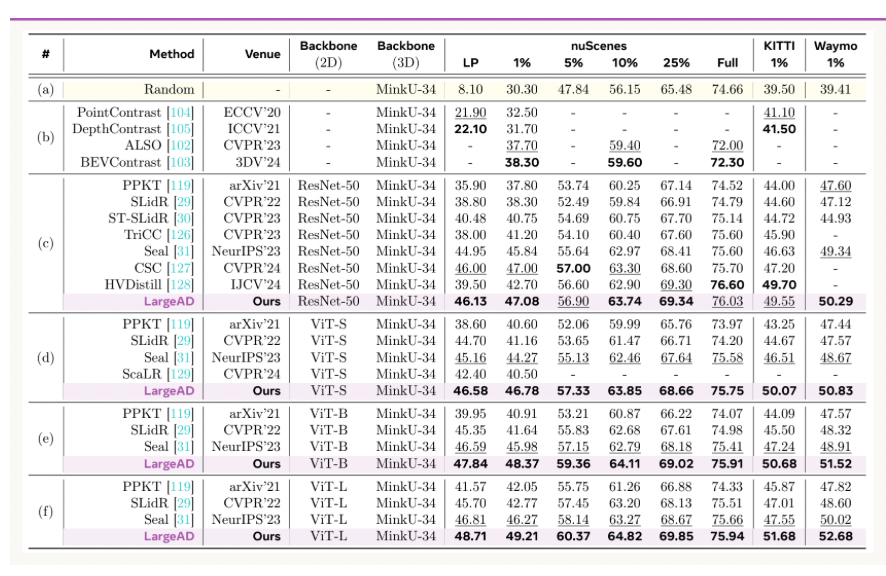
平均交并比 (Mean Intersection-over-Union, mIoU) 衡量不同类别的预测与真实标注重合得有多好。上述数字说明,预训练能够改善有限标注条件下的点云分割;“1%”指下游微调使用的标注比例,不能理解为整个训练流程只用了原来百分之一的数据或计算量。
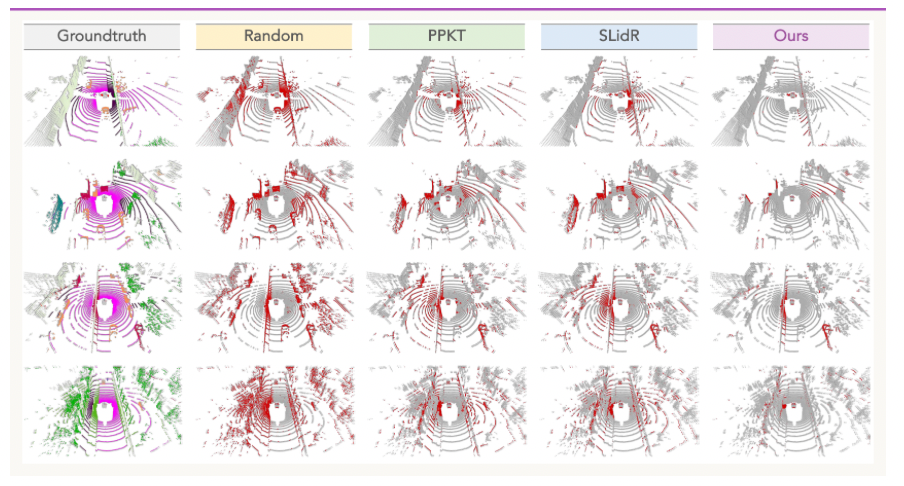
可视化也提供了直观参照。下面的结果来自 nuScenes 上使用 1% 标注数据微调的模型。预测正确的点用灰色表示,错误的点用红色表示,因此可以直接比较不同初始化与预训练方法留下的错误区域。
不同来源的数据,怎样一起发挥作用?
同样是道路点云,不同数据集的传感器、点云密度与数值分布也可能差别明显。只在一种采集条件中学习,模型容易适应那一套数据,却未必适合下一套设备。
LargeAD 将 nuScenes、SemanticKITTI 与 Waymo Open 的数据用于多来源预训练,并处理不同来源的特征分布差异。消融实验中,采用 ViT-B 时,相比仅在 nuScenes 预训练,三来源组合使 nuScenes 的 1% 标注微调结果由 45.98% 提升至 48.37%,SemanticKITTI 由 47.24% 提升至 50.68%,Waymo Open 由 48.91% 提升至 51.52%。
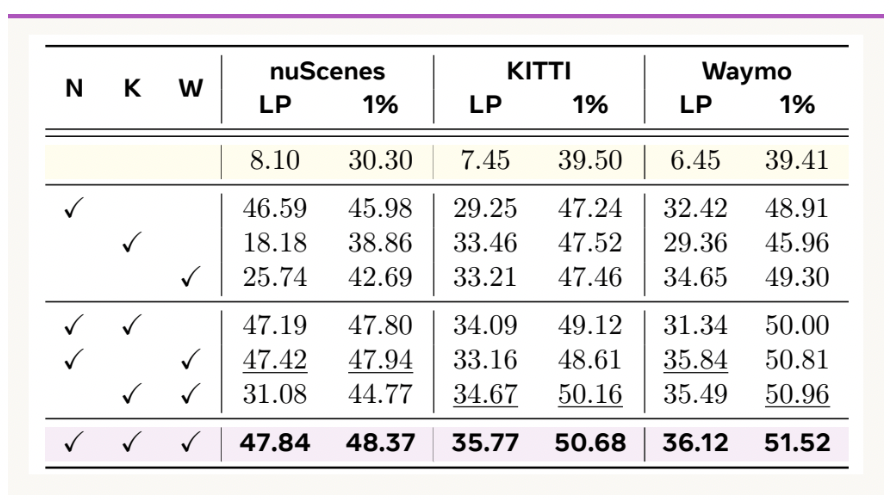
这组对照显示,数据来源的多样性确实能够改善学习到的表示。三个数据集在组合设置下都参与了预训练,因此这些结果反映的是多来源训练收益;跨到预训练之外的新数据集,则需要看另外的迁移实验。
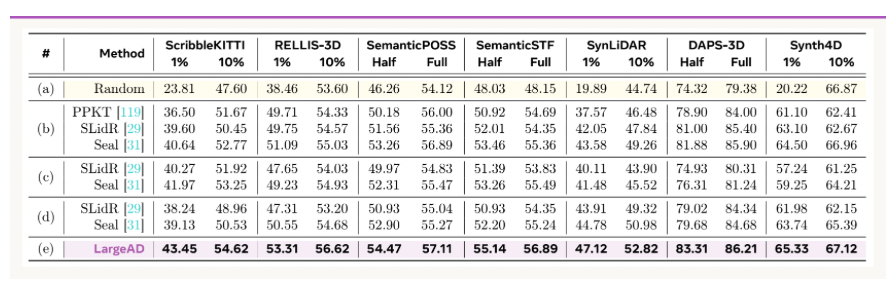
论文还在七个额外数据集上进行了下游微调,包含越野、动态目标、恶劣天气与合成环境等条件。评价协议和标注比例各不相同,但整体上检验了同一类预训练表示在不同数据条件中的适用性。
学到的表示,还能用于哪些感知任务?
自动驾驶感知不仅要区分点属于什么类别,还需要找出单个目标的位置与范围。LargeAD 将预训练表示用于三维目标检测和全景分割,进一步检查其用途。
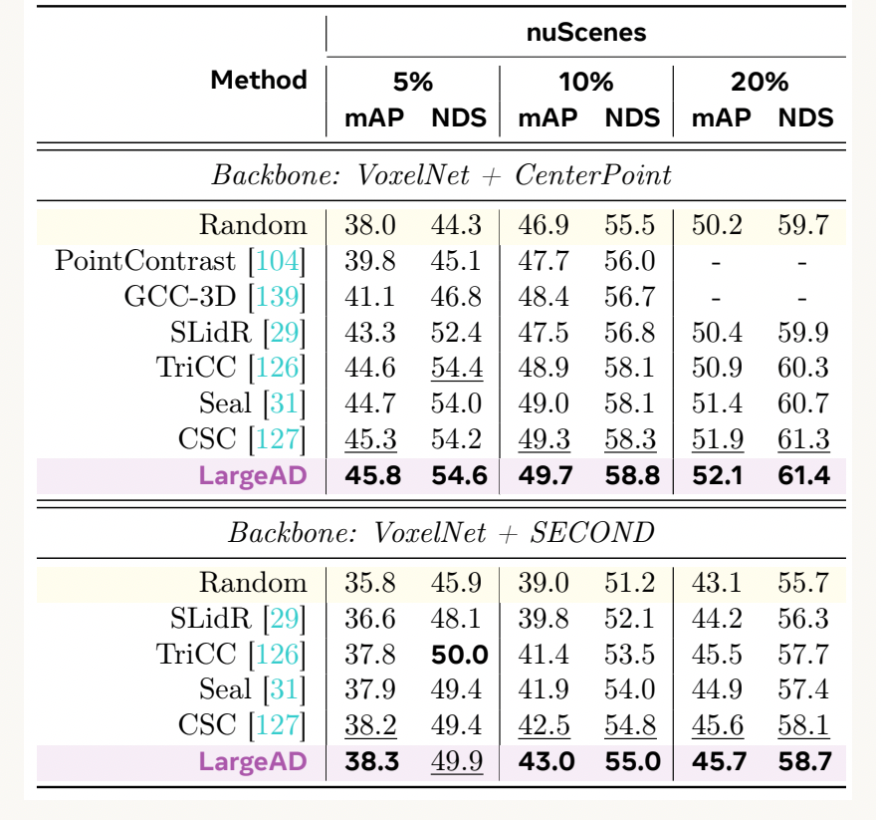
在 nuScenes 的三维检测实验中,采用 VoxelNet 与 CenterPoint、使用 5% 标注数据训练时,LargeAD 达到 45.8% mAP 和 54.6% NDS,随机初始化分别为 38.0% 和 44.3%。其中,mAP 衡量目标检测表现,NDS 是 nuScenes 的综合检测指标,与前面的分割 mIoU 不能直接比较。
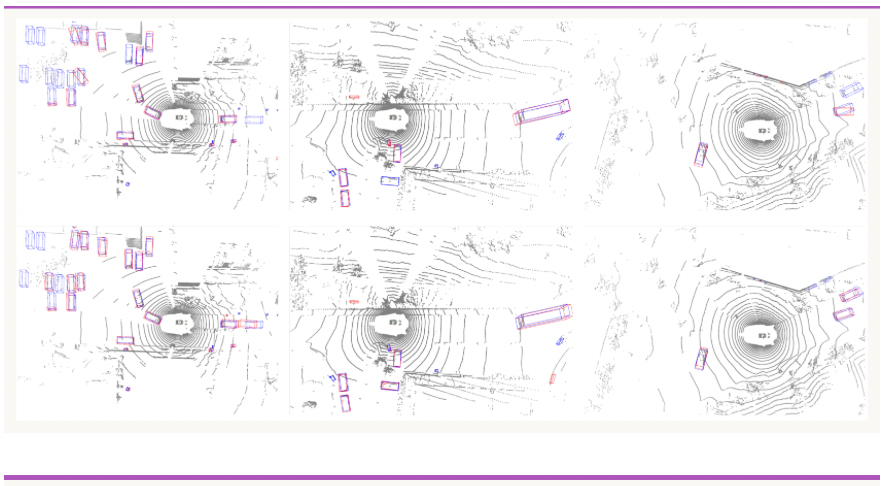
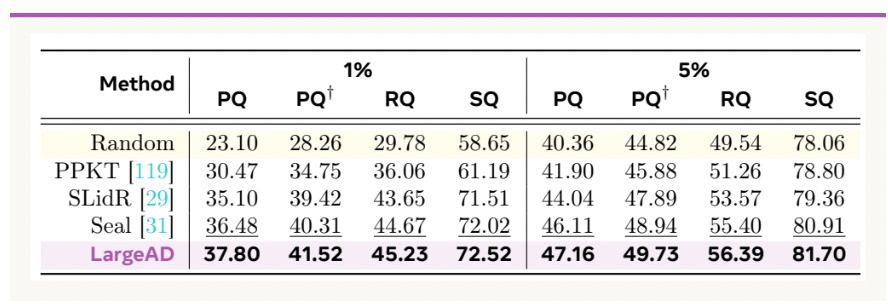
全景分割同时要求识别类别并区分不同实例。例如,场景中几辆车都属于“车辆”,也需要分别识别出来。采用 1% 标注数据的设置下,LargeAD 的全景质量 (Panoptic Quality, PQ) 为 37.80%,随机初始化为 23.10%。这说明预训练的帮助并不局限于单一分类目标。
基础模型的知识,怎样真正服务三维感知
LargeAD 的研究价值,在于把图像基础模型、时空对应关系与多来源道路数据组织成一套可扩展的预训练方法。对标注稀缺的三维感知任务而言,先从已有数据中获得有用表示,再用有限标注完成任务适配,是值得继续研究的方向。
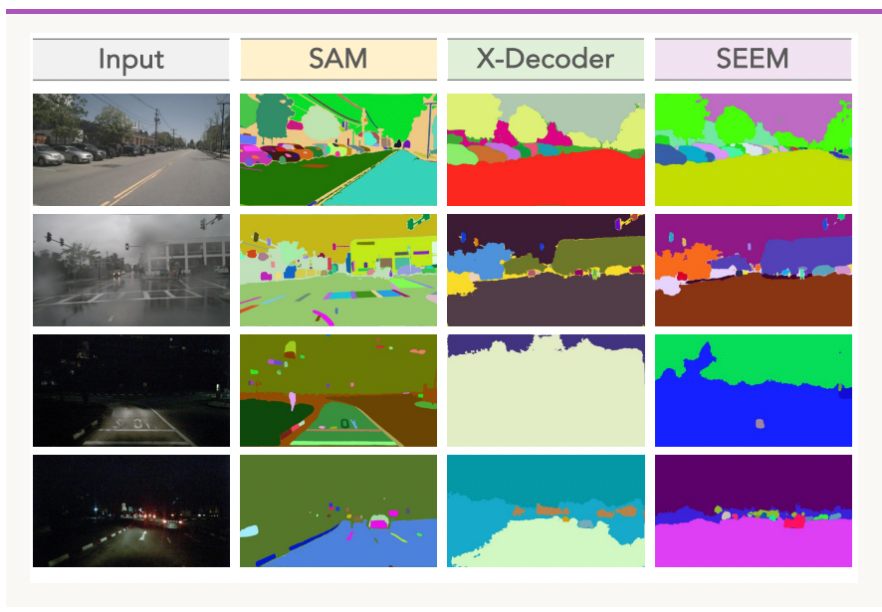
方法也受到上游质量的影响:基础模型在遮挡、夜间或恶劣天气下划错区域,错误可能进入后续学习;动态目标也可能影响跨帧聚类的一致性。论文给出了相关失败案例,展示这些问题仍然存在。
目前公开的结果主要支持三维感知与表示学习能力的改善,尚不能替代完整自动驾驶系统的闭环评估。对于希望研究少标注学习、图像到点云知识迁移或多来源预训练的团队,LargeAD 提供了论文、方法对照与预训练权重等可进一步查阅的资源。对自动驾驶感知与三维点云预训练感兴趣的开发者,也可以在 云栈社区 找到相关讨论与学习资源。
 发表于 1 小时前
|
查看: 6|
回复: 0
 /1


