LLM智能体如何在部署过程中,通过自身执行持续进化?
来自澳大利亚新南威尔士大学(UNSW)Artificer AI Lab 的研究团队,给出了一个新答案:不止于上下文、harness 和提示词,而是进入模型权重。
他们尝试让 LLM 智能体以冻结的初始自身充当教师,带着 hindsight(后见之明) 把经验自蒸馏进模型权重。
每个任务只执行一次,只有通过验证的经验才会触发更新;无需参考答案,也无需更强的教师模型。
该方法被命名为 ASCENT(Agentic Self-distillation for Cross-task EvolutioN at Test-time)。在 ALFWorld 和 WebShop 上,ASCENT 基于 Qwen3.5-4B 和 9B 的成功率均比基座模型高出 22 个点以上。
自进化智能体:经验大多存在「模型之外」
现有的自进化智能体(self-evolving agents)大多把反思、记忆或技能以文本形式存放在 harness(执行框架)里,模型本身保持冻结。
于是每一次提升都取决于两件事:能否检索到对的那条经验,以及冻结的模型能否在长程交互中真正照着执行。
而参数化的智能体学习,通常需要离线训练,或者对同一个任务进行多次尝试(multiple rollouts)。
由此,一个核心问题浮出水面:部署中的 LLM 智能体,能否一边工作、一边把自己通过验证的经验转化为权重更新;在线、持续地学习,每个任务只执行一次?
难在哪?每个任务只有一次机会,直接模仿或强化都会让策略崩溃
团队研究的这一设定,叫作在线智能体测试时训练(Online Agentic Test-Time Training,OaTTT)。难点在于:
- 单次尝试:和 harness 层面的自进化一样,任务流只过一遍,每个任务只执行一次,只在结束时得到一个成功/失败的验证信号,没有逐轮奖励。
- 噪声无法平均:每次更新只来自一条轨迹,其中的噪声无法被平均掉。
- 策略崩溃:直接模仿(RFT)或强化(REINFORCE)智能体自己生成的 token,会让策略崩溃——越来越偏离初始模型,无效动作越来越多,在任务流后半段的成功率甚至低于未训练的基座模型。
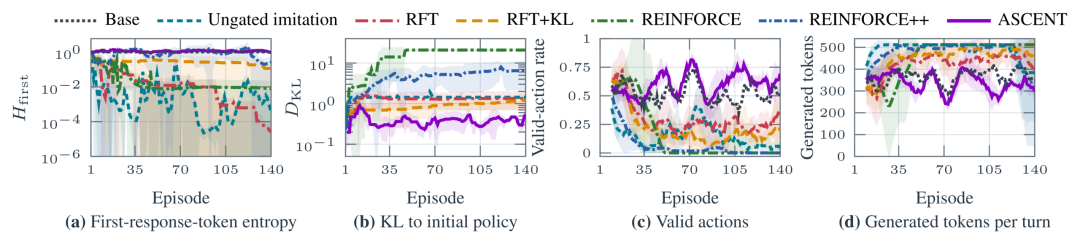
在线逐 episode 更新时的训练动态:直接模仿或强化的基线越来越偏离初始模型、有效动作率下降,ASCENT 最贴近初始模型,有效动作率保持不降
一句话:直接拿自己生成的 token 当目标,单条轨迹里的噪声会被一步步放大成过拟合和策略漂移。
ASCENT:只学通过验证的经验,用「hindsight」自蒸馏进权重
ASCENT 换了一个思路:把通过验证的经验及其 hindsight(后见之明)自蒸馏进权重。
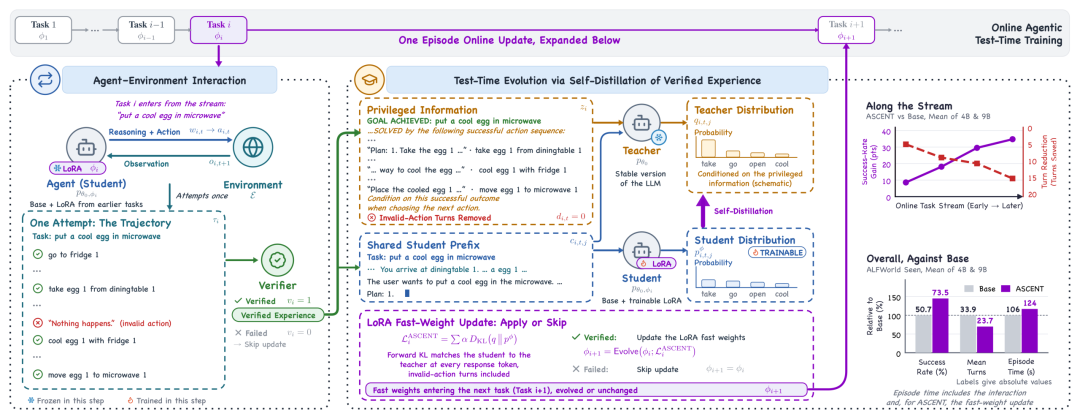
ASCENT 总览:每个任务只尝试一次,通过验证的轨迹成为冻结教师的特权信息,教师的软目标更新 LoRA 快权重,带到下一个任务
四个核心设计
它的设计可以拆成四个要点:
- 验证经验:只有通过验证的 episode 才触发更新,失败的直接跳过。团队也坦言,如果能把失败也利用起来,或许会更好,但暂时发现数据稀释的时候不方便用。
- Hindsight teacher:教师是 LLM 的一个稳定版本,也就是它冻结的初始自身。教师把整条成功轨迹作为特权信息(privileged information)读入(“目标已达成,以下是成功的动作序列……”),再沿着智能体自己生成的回复,在每个位置给出完整的下一个 token 分布。
- 自蒸馏:学生(基座+LoRA快权重)用前向 KL 向这些软目标靠拢。教师更认可的候选 token 概率上升,教师不认同的 token 概率下降,而不是简单地让自己生成的 token 变得更可能。
- 动作有效性过滤:环境没有执行的无效动作轮次,会从教师看到的轨迹中去掉,得到更干净的 hindsight;但学生仍在这些位置上训练,因此无效动作会被压低。整个过程不需要逐轮奖励,也不需要信用分配(credit assignment)。
为什么教师要冻结
为什么教师要冻结?一个跟着学生变化的教师,会把学生的漂移当作后续任务的目标再喂回来。实验中,一个快速跟随学生的指数滑动平均(EMA)教师,成功率从任务流前段的 48.6% 跌到后段的 2.9%。随策略同步更新的(on-policy)教师当然更理想,但在在线场景中,很难把握它与稳定性之间的平衡。
能力不断累积
更新后的模型带到下一个任务,能力不断累积。无需参考答案,无需更强的教师模型,推理时也无需检索记忆。
上下文自适应(in-context adaptation)与权重能否共同进化?可以。初步实验中,把 ASCENT 加到两种上下文自适应方法(ACE、MemP)上,两者都得到了提升。
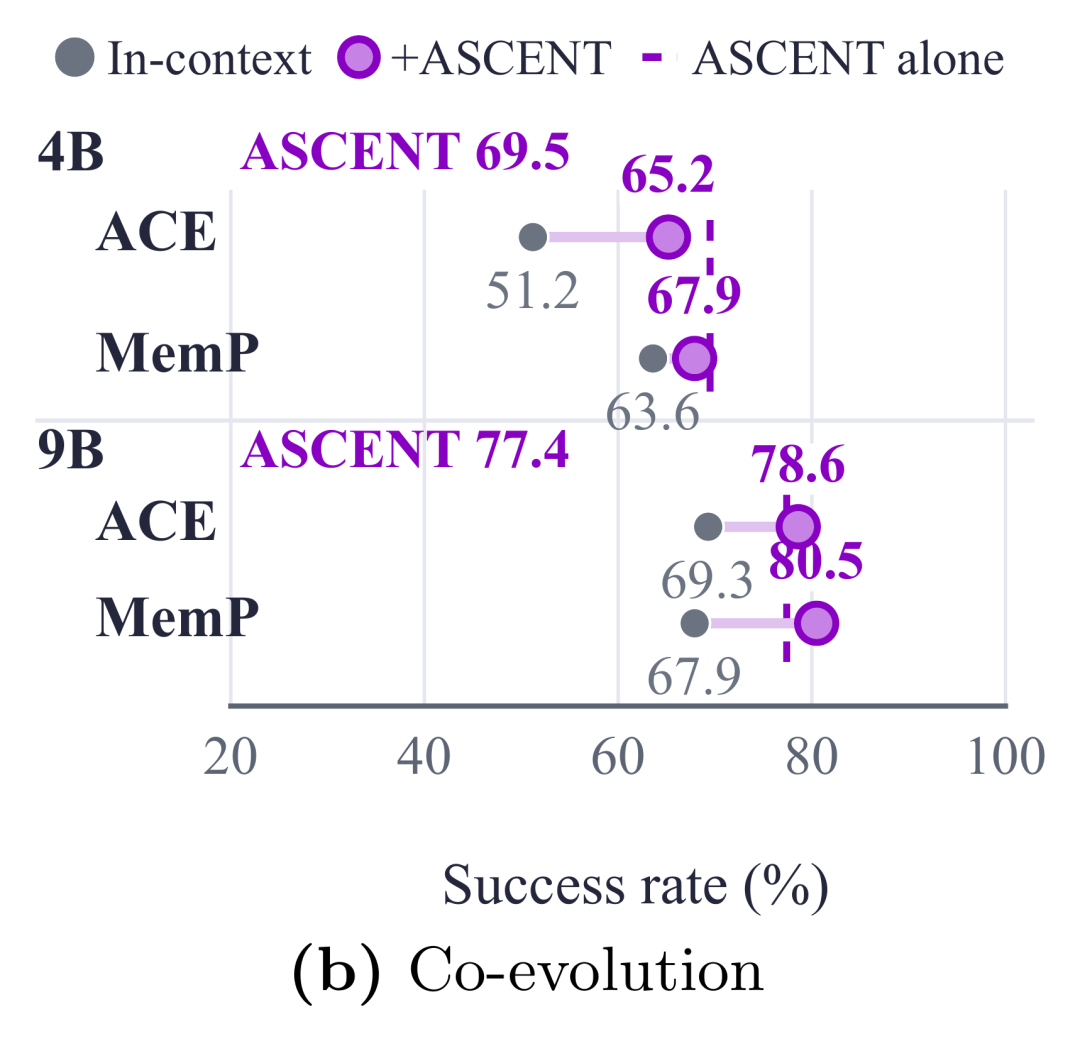
初步共同进化:把 ASCENT 加到 ACE、MemP 上,两种上下文自适应方法都得到提升(虚线为 ASCENT 单独的成功率)
实验:ALFWorld、WebShop 成功率都提升超 22 个点
实验设置
团队在 Qwen3.5-4B/9B 上,与 12 种在线和离线自进化方法(MemP、ACE、ReasoningBank、GEPA 等)比较,覆盖三个长程智能体基准:
- ALFWorld:文本形式的家务任务,需要在房间里寻找、清洗、加热、冷却并放置物品。
- WebShop:在一个有 118 万件真实商品的模拟网店中,搜索并购买符合指令的商品。
- AppWorld:交互式编程,调用 9 个日常 App 的 457 个 API 来完成任务。
主要结果
在 ALFWorld 和 WebShop 上,两个模型规模的成功率都比基座模型高出 22 个点以上:ALFWorld 46.4→69.5(4B)、55.0→77.4(9B),WebShop 17.8→41.9(4B)、17.2→41.5(9B)。在这两个基准上,ASCENT 都是所有对比方法中最好的,交互轮数也最少。
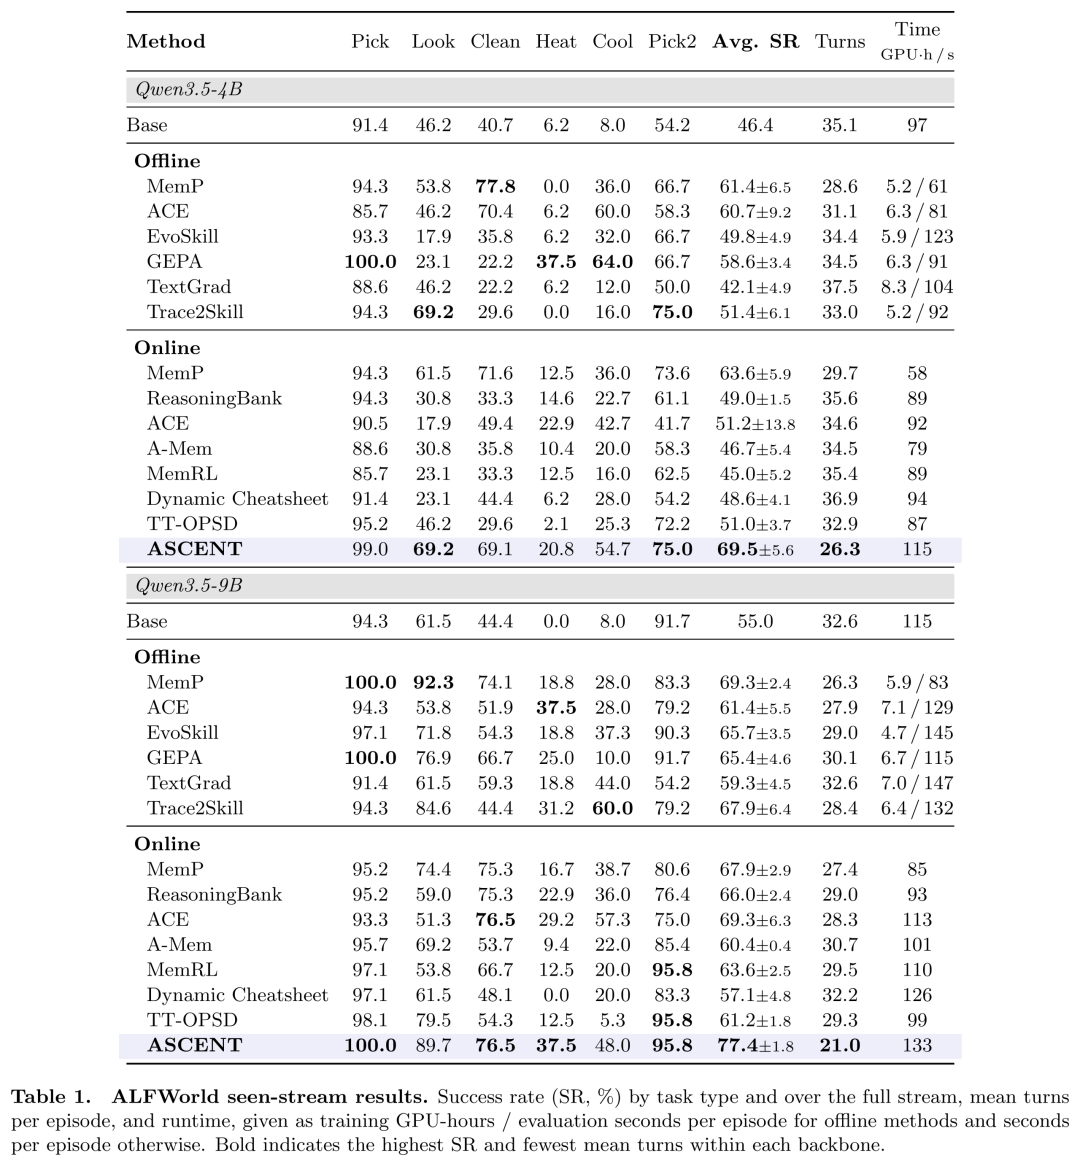
ALFWorld 任务流上的成功率与平均交互轮数对比(加粗为最优)
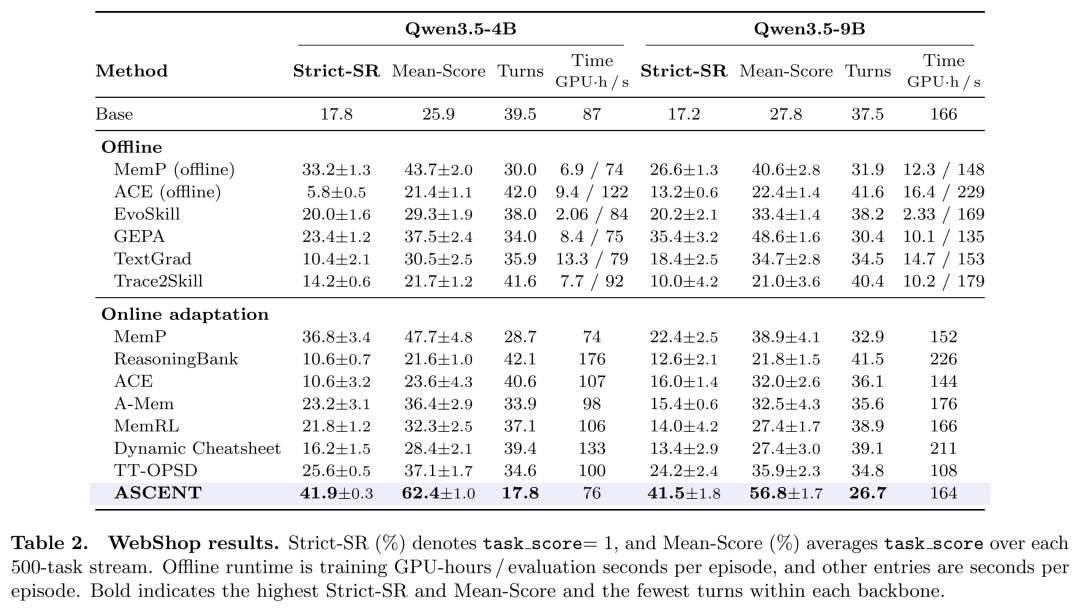
WebShop 上的 Strict-SR、Mean-Score 与交互轮数对比(加粗为最优)
- 越往后收益越大:收益和交互效率都随任务流推进而增大。
- 轮数更省:在基座模型也能解出的任务上,ASCENT 在 64%(4B)和 67%(9B)的任务上用的轮数更少。
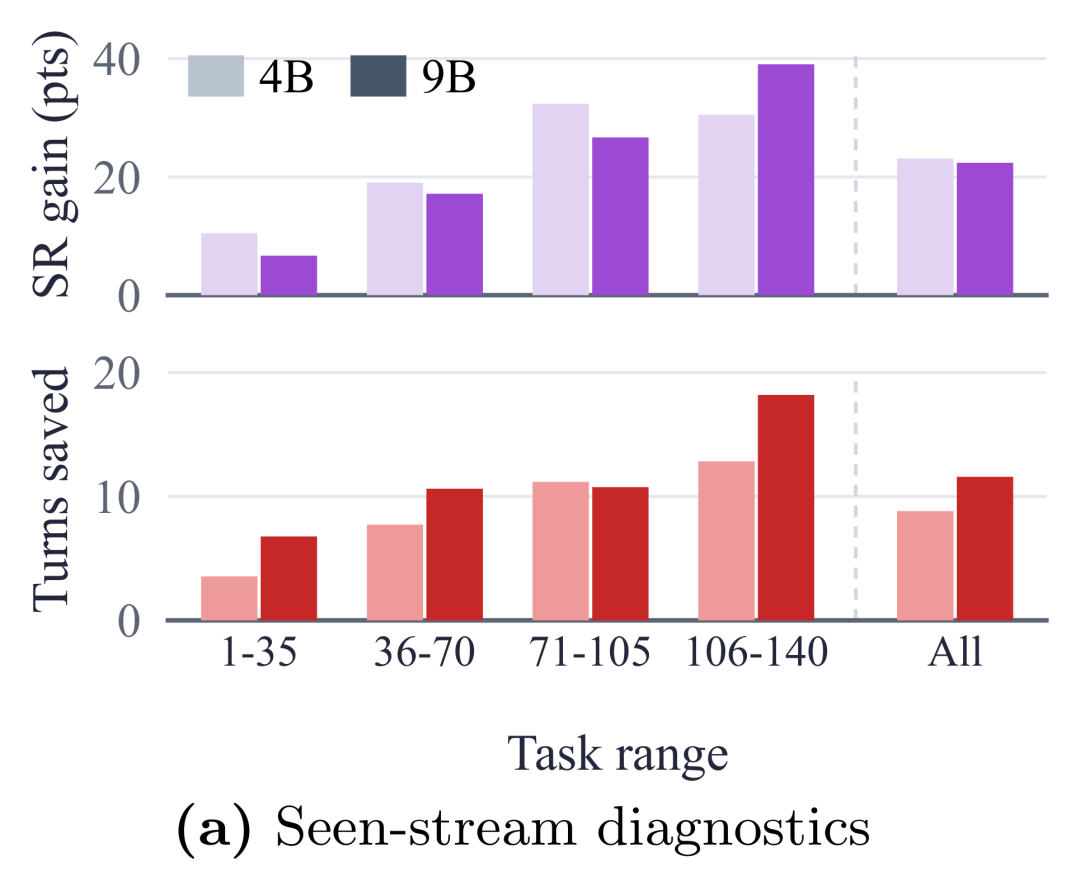
随任务流推进,ASCENT 相对基座的成功率提升(上)和节省的交互轮数(下)都在增大(浅色 4B,深色 9B)
- 迁移到新房间:迁移到未见过的 ALFWorld 房间(权重冻结),成功率 43.3→62.7(4B)、49.3→88.8(9B)。
- 交互式编程:AppWorld(4B,Test-Normal)任务完成率 20.2→26.2。
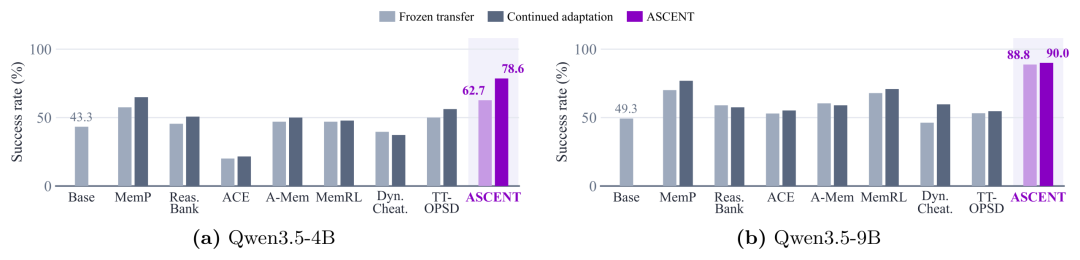
迁移到未见过的 ALFWorld 房间:浅色为冻结权重直接迁移,深色为继续在线学习,ASCENT 分别达到 62.7/78.6(4B)和 88.8/90.0(9B)
一个例子:把冷却过的鸡蛋放进微波炉
更有意思的是一个例子:“把一个冷却过的鸡蛋放进微波炉”(put a cool egg in microwave)。
基座模型和几种上下文自适应方法都耗尽了 50 轮:有的检索到一条“生鸡蛋放进微波炉可能会爆炸”的记忆,被带偏了方向;有的上下文里明明有正确的规则,却始终没有执行“冷却”这一步。
ASCENT 没有检索任何记忆,用 20 轮完成了任务。它的权重此前吸收过两个同类任务的经验:冷却番茄后放进垃圾桶、冷却盘子后放进柜子。物体和目的地都不同,但 “找到→冷却→放置”的结构是一样的。
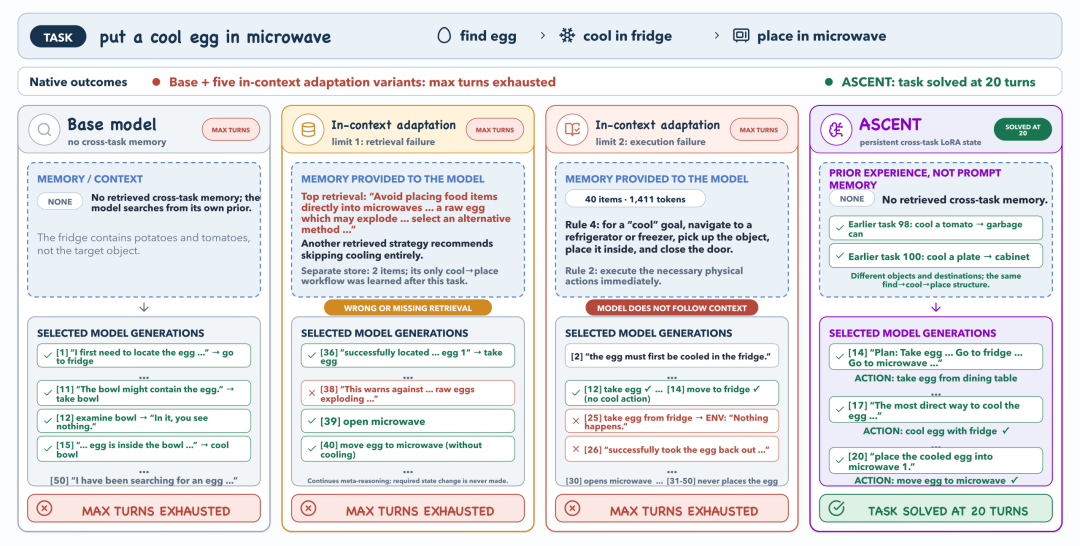
案例:基座模型与上下文自适应方法耗尽 50 轮,ASCENT 不检索任何记忆,20 轮完成任务
消融实验
消融实验进一步拆解了特权信息的组成:动作(action)、推理–动作回复(reasoning–action response)和环境观察(observation),并分别对比用与不用动作有效性过滤。
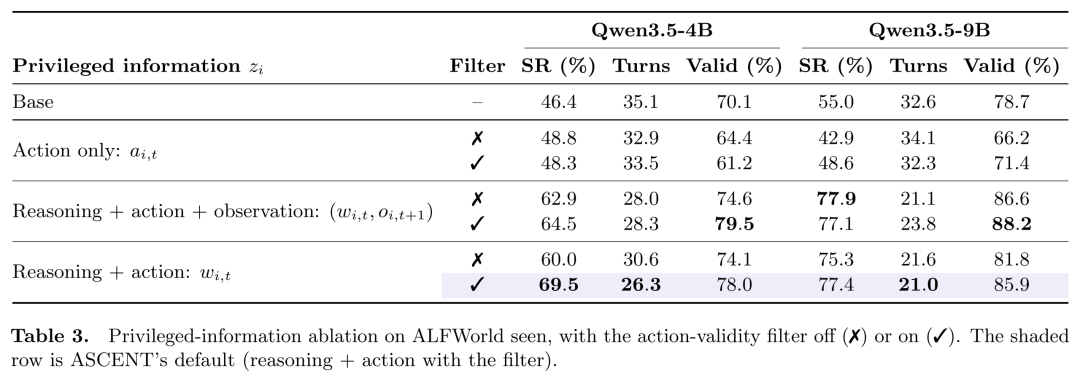
特权信息消融:不同组成、是否过滤下的成功率、交互轮数与有效动作率(阴影行为 ASCENT 的默认设置)
- 推理最关键:特权信息里最关键的是推理过程,只给动作的 hindsight,效果接近甚至低于基座模型;加入推理后,成功率和交互效率都稳定提升。原因可能在于,推理解释了每一步动作为什么这么做(比如服务于哪个子目标),而且学生生成的 token 大多是推理,动作只是一条很短的指令,只给动作的 hindsight 能覆盖到的训练位置很少。
- 小模型更需要精简、过滤过的特权信息:在 4B 上,更短(只含推理与动作、不含观察)且经过过滤的特权信息效果最好,交互轮数也最少;特权信息含推理时,过滤在这个规模上帮助最大。在更强的 9B 上,提供完整轨迹(含观察)同样表现很好,可能得益于更强的通用语言能力;此时过滤对成功率影响不大,但仍能提高有效动作率。不加过滤时,观察可能通过显示哪些动作被环境判为无效而起作用;过滤去掉这些轮次后,观察的额外作用就不大了。ASCENT 的默认设置(推理+动作,加过滤)在 9B 上表现相当,交互效率略好。
- 完整轨迹更好:用完整轨迹作为 hindsight,明显优于只看当前一轮的教师(TT-OPSD)。
- 散度可替换:把前向 KL 换成反向 KL 或 Jensen–Shannon(JS)散度,ASCENT 在两个模型规模上仍然优于基座。
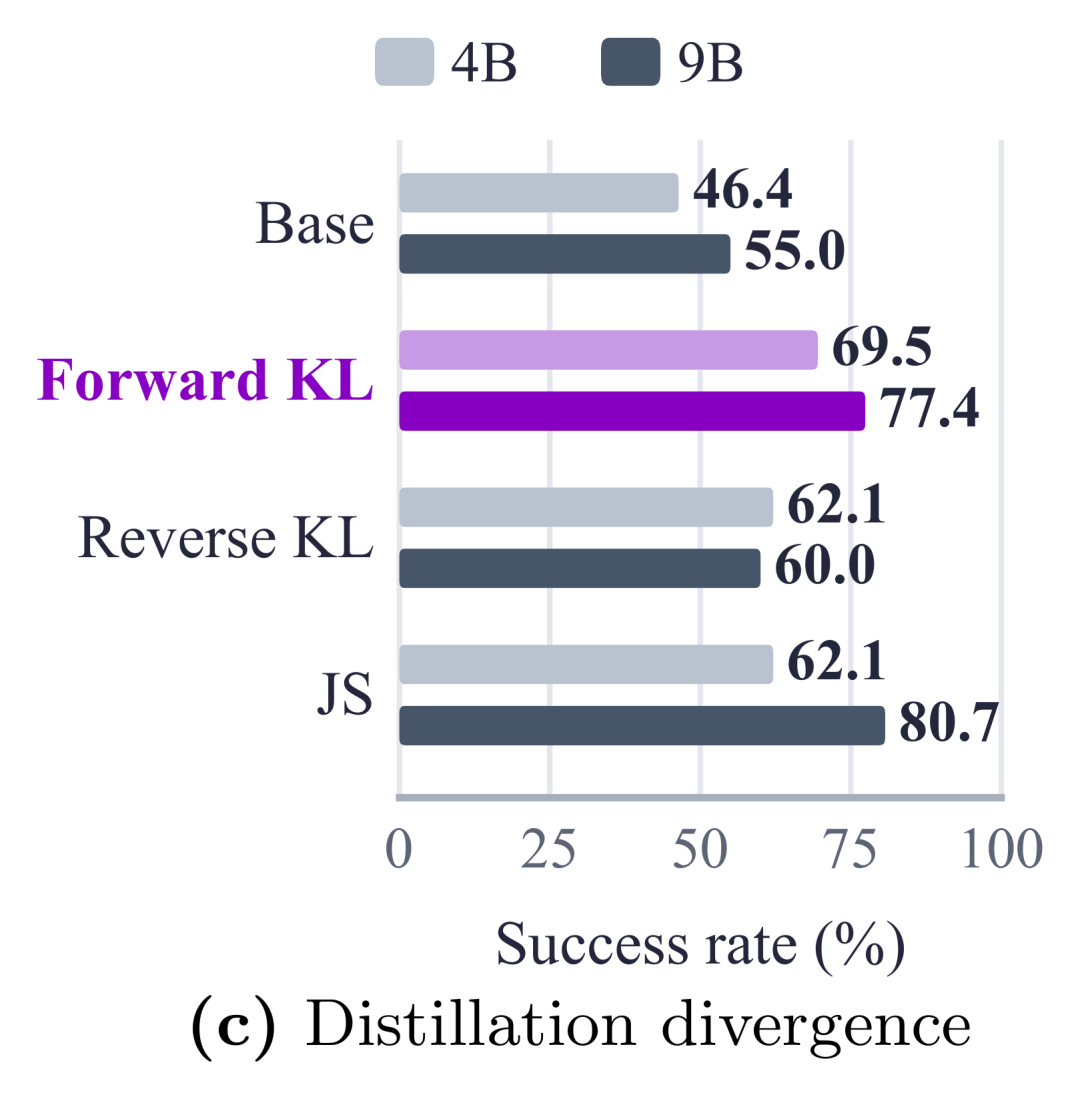
蒸馏散度消融:把前向 KL 换成反向 KL 或 JS 散度,ASCENT 在两个模型规模上仍优于基座
为什么这件事重要?
AI 系统可以在多个层面上自我提升:权重、外部记忆、执行框架(harness)。
ASCENT 作用在权重这一层:部署中的智能体每完成一个通过验证的任务,就把经验沉淀进自己的参数,而初步实验显示,它还能和上下文自适应方法一起进化。
论文也指出,这种在线进化展现出一种潜力:为不同的环境或用户接入各自进化出的快权重,得到环境专属、用户专属的智能体。
正如方法名 ASCENT(攀升)所寓意的那样——每一个通过验证的任务,都是向上的一步;经验一步步攀升进权重。
论文地址: https://arxiv.org/pdf/2610.05303
项目主页: https://artificer-ai-lab.github.io/ASCENT/
团队主页(UNSW Artificer AI Lab): https://donggong1.github.io/
 发表于 4 小时前
|
查看: 5|
回复: 0
 /1


