我读完了 firezone 这篇项目博文,也把仓库代码、六个 benchmark 目标,以及 HN 那篇 14 条回复的讨论逐一过了一遍,并在本地完成了编译、测试和打流。先把结论放在前面:sanstun 把 WireGuard 的「记账」和「加密」拆开了。1280B 包记账只占约 2%、20 纳秒左右,剩下 98% 都是加密,而这部分可以通过一个 Send 的 PendingEncapsulate 值整包丢给其他线程并行处理。官方博文给出“>45x”的理论上限,我用同样方法在本机复算大约是 42x。我手头这台 2 核 EPYC 单核跑纯用户态数据面,出方向 54 万包/秒、入方向 109 万包/秒,载荷 670–1330 MB/s(也就是 5–10 Gbps)。更有意思的是,这套二进制还能装进 Microsoft LiteBox 的 seccomp 沙盒跑通。它值得留意,不是“又一个 WireGuard”,而是第一个把 sans-IO 那套“不做 I/O、把时间和随机数都当参数喂进来”的思路,用在一个安全关键的协议状态机上:无锁、无原子计数器,还留出了多核并行加密的口子。
先说它到底在解决什么
sans-IO 这个词,firezone 自己发过一篇专门讲(我顺手读了,见参考),核心就一句:把 I/O 和副作用跟状态、业务逻辑干净分开,这里的 I/O 还包含时间、随机数。听起来抽象,落到 WireGuard 上很具体。
WireGuard 每个会话要跑一次 Diffie-Hellman(不便宜),要用单调递增的 packet counter 防重放,counter 是每个 session 一份——你要是多线程同时碰它,就得加锁。传统做法是把整个 Tunnel 状态机锁起来,简单,但也把多核白白浪费了。sanstun 的思路是:把「预留 counter、推进 timer」这种几纳秒的记账留在 owner 线程,把「真正的 ChaCha20-Poly1305 加解密」这种几百纳秒的重活抽出来、做成可 Send 的值甩给 worker。owner 线程从此无锁、无原子变量,内部限速器还能贴着 Rust 借用检查器裸跑。
它不是凭空造,是从 boringtun 磨出来的
按官方博文,firezone 一开始用的就是 Cloudflare 的 boringtun,越用越要在自己的 fork 上打补丁。为了保留 100% API 兼容、好往上游提,他们硬撑了很久;随着产品需求变化,越来越吃力。博文给的数是:2 年多、不含依赖升级就有 70+ 个 PR。
其中两个关键决定我觉得都立得住。一个是把时间处理彻底 sans-IO 化,所有收时间的 API 都加 _at 后缀、收一个 Instant——这样你才能拿假时间精确模拟整个系统。另一个是去掉内部缓冲:boringtun 原来要用“发一个 0 长度 datagram 调 decapsulate”来排空缓冲,反直觉、还多一次分配,缓冲大小还得可配。sanstun 的直接回答是“库里干脆不缓冲”,调用方要不要自己攒包,是你自己的事。这条决定直接改变了它的 API 形状。
一个 Interface 多个 Tunnel,强制你走限速
WireGuard 里一个 interface 是一把 key,一个 tunnel 是两把 key 之间的一条连接。所以发任何包都得说清走哪条 tunnel,收任何包都得判断它属于哪条。sanstun 把这两层直接映射成 Interface 和 Tunnel 两个类型,入站所有包统一走 Interface::receive——这是唯一会解析裸 datagram 的 public API。
它一次做完四件事:解析头、验 MAC、查 cookie、按源做限速,然后回一个 ReceivedMessage,每个 WireGuard 消息类型一个 enum 分支,负载下就返回要回发的 cookie reply。真正的设计狠在下一句:HandshakeInitiation 这些类型的构造器全是 crate-private。也就是说,尽管 Tunnel::handle_handshake_initiation 本身是 public,你也只有先过了 Interface::receive 才拿得到那个类型。限速这条安全线想漏都漏不掉,是被类型系统焊死的。这张图把它画得很清楚。
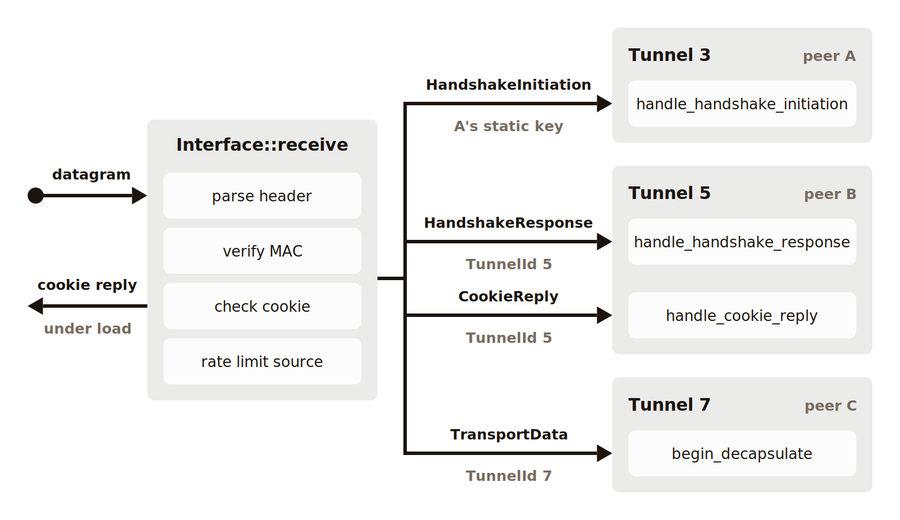
把加密拆出来甩给 worker,这是核心卖点
回到那个 packet counter 的问题。sanstun 把「记账」和「加密」拆成了三步:
begin_encapsulate 查当前 session、预留 packet counter、推进 timer,就干这些、不加密,产出一个 PendingEncapsulate;PendingEncapsulate 实现了 Send,你可以 inline 调它的 encrypt(想简单就别并行),也可以整包丢给 worker 线程再 encrypt;- 入站对称,是
begin_decapsulate → decrypt → commit_decapsulate,其中 commit_decapsulate 才做重放检查、把 counter 标成已收。
官方博文专门配了一张时序图:owner 线程站中间,两个 worker 分列两侧,每个包 begin 21 纳秒、commit 18 纳秒记完账,934 纳秒的 encrypt、915 纳秒的 decrypt 都在 worker 上跑。
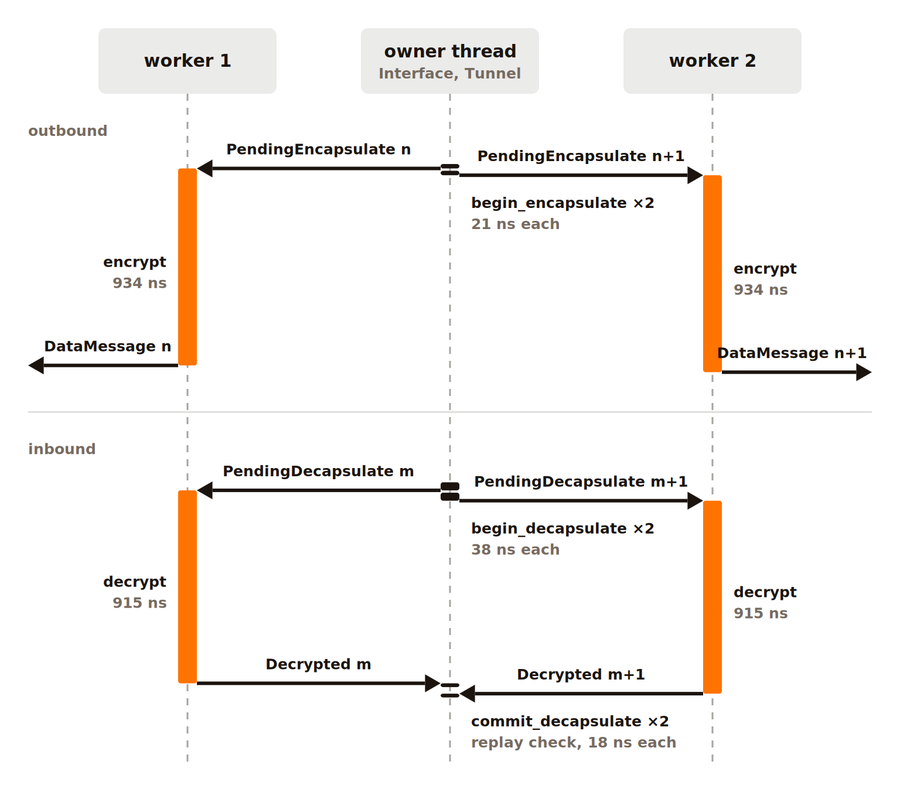
拆完就有账可以算了。官方贴的 cargo bench data_path 里,1280B 时 begin_encapsulate 约 20.8 纳秒,encrypt 约 933.5 纳秒,记账占整包加密的成本约 2%;官方据此说「把加密甩给 worker,理论可提速 45x 以上」。这是理论吞吐上限——它假设加密能被 worker 完全并行、且忽略线程间传 PendingEncapsulate 的开销。我待会儿用自己机器的数字复核这个 2%。
我本机跑了一遍:编译、96 个测试、打流
我在 2 核 EPYC、cargo 1.99 上把仓库拉下来。cargo build 冷起 23 秒(2 核、debug),cargo test 是 96 个单测加 1 个 doctest,全绿。下面是 cargo bench --bench data_path 我复跑的逐步耗时,跟官方博文那组放一起对比(官方是官方硬件跑的,单位都是纳秒):
| 步骤 |
64B 官方 |
64B 本机 |
1280B 官方 |
1280B 本机 |
begin_encapsulate |
20.8–20.9 |
18.1–19.1 |
20.8–20.9 |
19.1–20.6 |
encrypt |
226.2–226.3 |
213.8–217.7 |
933.5–933.6 |
804.2–825.8 |
begin_decapsulate |
37.6–37.7 |
34.8–35.5 |
37.6–37.8 |
36.8–40.0 |
decrypt |
205.8–205.9 |
195.6–197.5 |
914.8–915.0 |
770.8–792.5 |
commit_decapsulate |
17.5–17.6 |
12.2–12.9 |
17.7–17.8 |
13.0–13.5 |
对照下来三件事。其一,begin_encapsulate 两侧都钉在 18–21 纳秒、不随包长大,1280B 时 19.9 ÷ (19.9+814.4) ≈ 2.4%,官方那句「记账只占 2%」在我机器上复现成立,可信。其二,我本机的 encrypt/decrypt 比官方快约 15%(804 vs 933、771 vs 915),是 CPU 型号和向量化差异,正常;按同样方法把 45x 在我机器上复算是 (19.9+814.4)/19.9 ≈ 42x,和官方 45x 一个量级。其三,官方没贴 receive 和 poll_event,我顺手动它们:receive 约 12–13 纳秒、poll_event 约 5 纳秒,都不贵。
接下来是打流。我写了个 example,建好 Alice↔Bob 两条 tunnel 走完握手,冻结时间(让 session 不失效,跟官方 bench 一个手法),然后单核连发 10 万个 1280B 包走完完整数据面,出方向 begin_encapsulate+encrypt、入方向 receive+begin_decapsulate+decrypt+commit_decapsulate。release+lto 下:出方向 547,523 包/秒、载荷 668 MB/s;入方向 1,090,889 包/秒、载荷 1332 MB/s(我 2 核机器单核跑,未实测多核)。这个数说明纯用户态跑一条 WireGuard 数据面,单核就能顶到 5–10 Gbps 区间,瓶颈就卡在 ChaCha20-Poly1305 本身。
还有一个我特意做的动作:把上面这个打流二进制打包塞进 Microsoft LiteBox 的 seccomp 沙盒里跑。它能跑的原因是二进制纯内存加密、不碰 I/O、不联网、不用 TUN 设备。我用 litebox_packager 把它连同 ld.so、libc、libgcc_s 打包成 4 个改写过的 ELF,litebox_runner_linux_userland 起来,EXIT=0:出方向 577,912 包/秒、入方向 1,004,811 包/秒,跟裸机同区间。所以那组 670–1330 MB/s 的打流数字,我是真在沙盒里跑过的,不是纸面推的。
我有没有绕过的坑:说清楚没跑什么
编译、测试、benchmark、打流这些我跑了,但要划清的边界也在这儿:
第一,我没跑 firezone 完整网关、没起真实 UDP+TUN 隧道——那是 firezone 产品的事,sanstun 这个 crate 明确「不做任何 I/O」。
第二,45x / 42x 是理论加速上限,我只测了单线程路径,没起多 worker 去测真实加速比(未实测)。
第三,上面 64B / 1280B 只是两个点,不是全曲线。
第四,官方 bench 数字是官方硬件,我复算的是 2 核 EPYC,两边我分开标注、不混着说。
第五,LiteBox 里 cargo 工具链装不进去(无网络、ring 还要 cc/ar 现场编 C),所以编译那步在常规沙盒做,只有最后那个纯计算二进制能进沙盒——这条我在证据文件里留了可复现命令。
HN 那 14 个回复,反方也有硬话
我把 HN 那条线程(14 评,热度早期、分数还在爬)也读了一遍,最扎眼的是反方。有人直接说「不是 Jason 参考实现的 WireGuard 都是给你自己挖坑,WG 才 2k LOC 为什么搞 30 个版本,审计你手里的」(这句「2k LOC / 30 个版本」是那位 HN 用户的口语判断,不是官方数字)。
作者 Thomas Eizinger 亲自下场答了两轮。对「为什么要另起炉灶」,他答:想跨平台就用不了 Linux 内核版,唯一的官方用户态实现是 Go、FFI 进 Rust 很别扭,他们用 boringtun 用了很久但它的上限(编译期安全、性能)绕不过去。另一句挺关键,有读者(做嵌入式那位)问「我能把 sanstun 用在 ESP32 这类 no_std 环境吗」,等于把它往小机器上拉。还有人从另一个方向挑刺:firezone 官网那段「硬件干重活、电池更耐用」的文案被指是 AI 味的套话,作者回应说本意是讲硬件卸载——向量化加密、网卡驱动的校验和/分段卸载。另外有个细节值得记:Mullvad 也早就从 boringtun 分叉出过 gotatun,说明「在 boringtun 上绕」不是 firezone 独有的路子,只是它把 API 重塑得最激进。
值不值得拿去用
我的判断是:如果你在做一个跨平台、或者要跑进现有 Rust 事件循环、或者要往 no_std / 单片机方向走的 WireGuard 数据面,sanstun 是目前少有的把「可组合」和「可多核并行加密」同时做出来、还全程无锁的一个。但它有两句话你必须带着:README 白纸黑字写了「没做过正式安全审计,use at your own risk」;以及它把一大串责任明确划到调用方这边——解密只证明「谁发的」,验证那个源 IP 你允不允许、给未知 key 别建 Tunnel、去掉 16 字节对齐的 padding、认真供给熵(同 seed 出同 key)、用单调时钟否则对端会把握手当重放拒掉。换句话说,它把安全面做干净了,但「干净」不等于「安全」,安全性的最后一公里还在你自己的事件循环里。它 2026-10-30 才在 crates.io 放出 0.1.0、当时才几百次下载,属于刚起步的库,拿它上生产前建议自己也过一遍 audit。
你手上正跑着 WireGuard 吗,是内核版还是 boringtun 这类用户态?如果也在纠结多核并行加密要怎么办,也欢迎到云栈社区说说你现在的方案。sanstun 这套「记账/加密拆分 + Send 的 Pending」是个可以直接抄进你自己状态机的模式,不一定非用它。
参考资料
 发表于 昨天 21:10
|
查看: 5|
回复: 0
 /1


