本文第一作者为纽约大学计算机科学博士生 Jack Lu,研究工作完成于他在英伟达实习期间。本文由英伟达资深研究科学家、Alpamayo 研究技术负责人 Yan Wang,以及英伟达自动驾驶研究负责人、斯坦福大学副教授 Marco Pavone 共同指导。
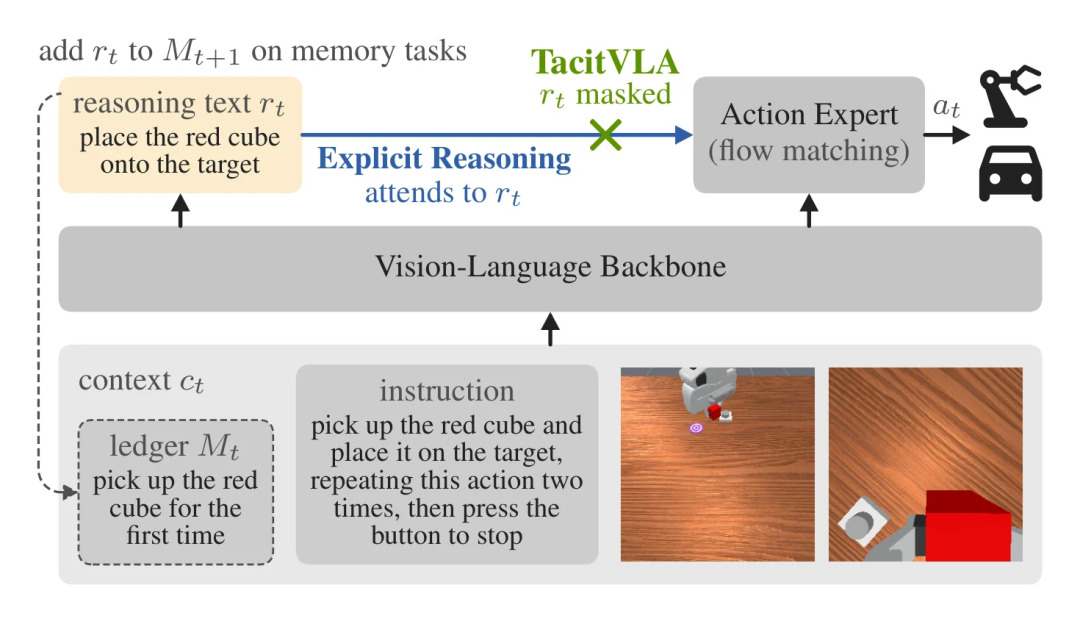
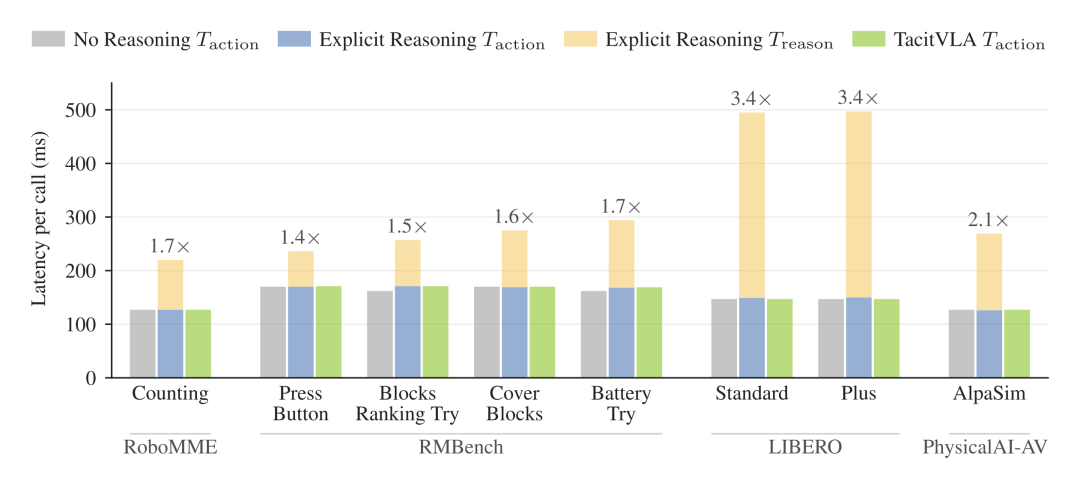
目前,多数视觉-语言-动作(VLA)模型遵循"先推理、再行动"的流程。模型在输出动作之前,会先生成一段简短的文字——可能是对场景的描述、一个执行计划,或者下一个待完成的子任务。这种方式虽然提高了机器人的成功率,代价却是速度明显变慢。推理文本必须逐个 token 自回归生成,动作只能等文本全部写完才能开始。论文中的实验数据显示,推理文本的生成时间最高可占单次模型调用耗时的 70%。
英伟达、纽约大学、UC Berkeley、约翰斯·霍普金斯大学和斯坦福大学的联合研究团队,对推理的收益来源做了系统分析。他们得到一个关键结论:动作并不需要读取当前这一步生成的推理内容——模型在训练过程中学会写推理,本身就已经足够。基于这个发现,团队提出了 TacitVLA。它的训练方式与标准推理 VLA 无异,同样学习生成推理文本,但在部署阶段,动作输出从不等待这段文本完成。
在机器人操作与自动驾驶的四个 benchmark 上,TacitVLA 的成功率与显式推理策略相当,但推理延迟最高可降低 3.4 倍。在保持相同速度的前提下,它的成功率比不做推理训练的同一模型高出最多 17 个百分点。此外,在两个长程记忆 benchmark 中,TacitVLA 刷新了已发表方法的最佳成绩——RMBench 上提升 21 个百分点,RoboMME 计数任务上提升 16 个百分点。
推理文本的三种作用
在推理 VLA 中,生成的推理文本承担着三种角色。
第一,在训练阶段,它是监督目标。学习生成这段文本的过程,会逐步塑造 action expert 所依赖的视觉-语言 backbone。
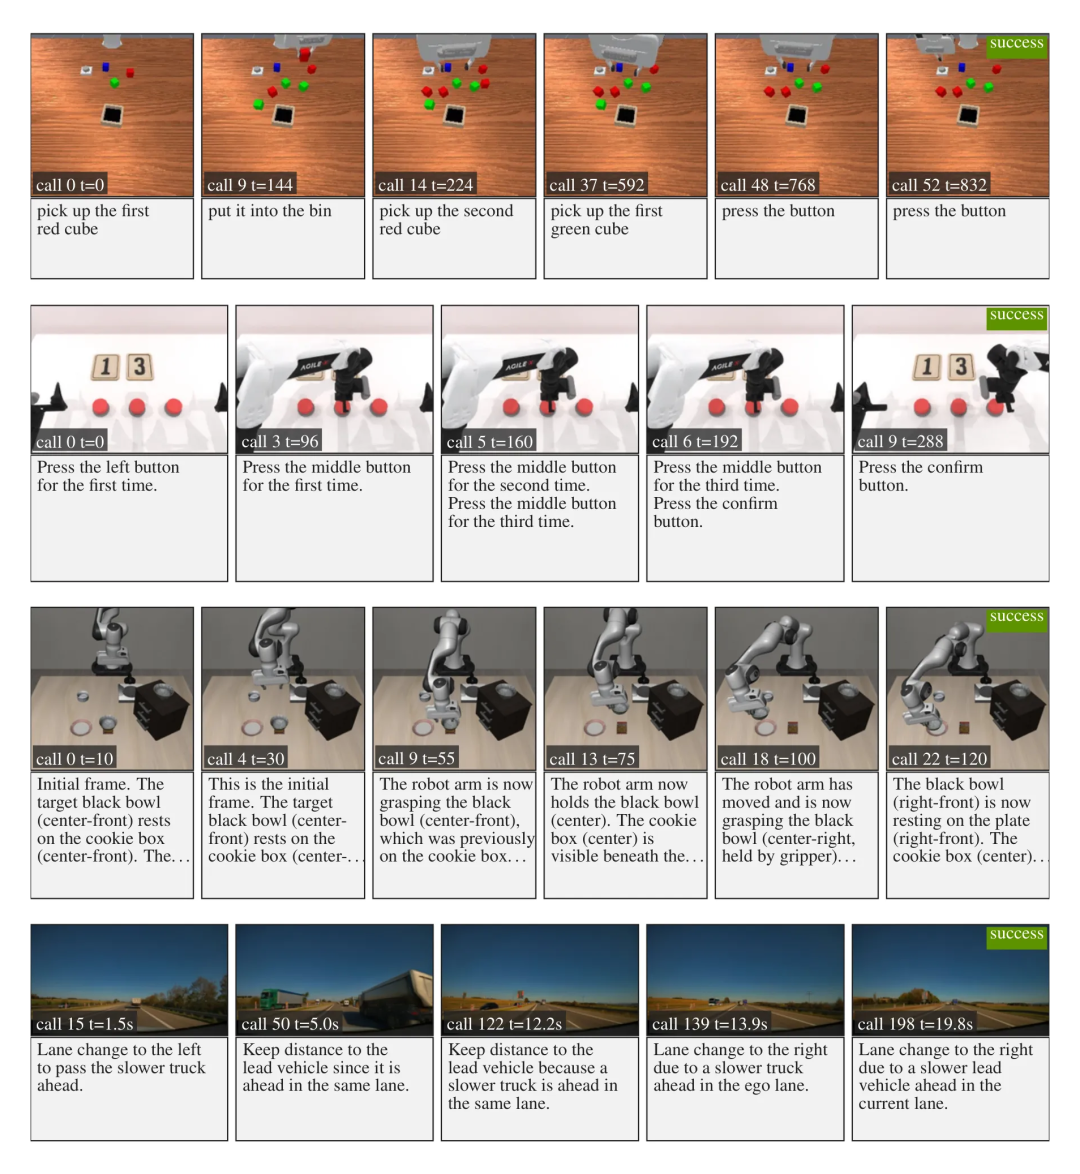
第二,在长程任务中,它充当记忆。假设机器人需要多次按下按钮,摄像头无法直接拍到已经按了几次,但一份记录已完成子任务的日志就可以承载这类信息。
第三,在部署阶段,文本成为 action expert 的输入。action expert 需要读取当前这一步刚写出的推理内容,动作因此被迫等待。TacitVLA 的设计保留了前两种作用,将第三种去掉了。
方法
近期推理 VLA 模型大多共享同一种结构:视觉-语言 backbone 负责生成推理文本,基于 flow matching 的 action expert 通过注意力机制读取 backbone 的信息并输出动作。团队在每个 benchmark 上,都用这一结构在相同数据上训练出三个策略作对比。
在 Explicit Reasoning 策略中,action expert 会读取刚刚生成的推理内容,这与 embodied chain-of-thought 的做法一致。TacitVLA 则使用完全相同的训练序列、损失函数、prompt 和优化器,唯一的区别在于 attention mask 上的一处改动——它让 action expert 看不到推理 token。No Reasoning 则是同一结构在不含推理文本的数据上训练得到的模型。
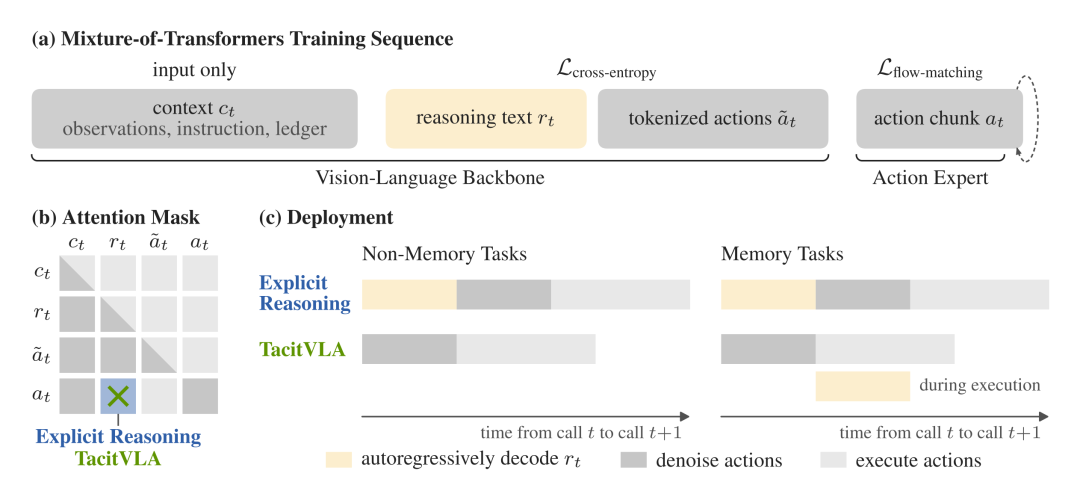
这样的设计将推理可能带来帮助的两条途径清晰分开了。
第一条途径来自学习写推理:这个过程本身可能训练出更好的 backbone。第二条来自读取推理:推理内容可能为 action expert 提供有用的额外输入。Explicit Reasoning 同时获得了这两种效果,No Reasoning 两者皆无。TacitVLA 只保留第一种,而第一种在部署时完全不占用额外时间。
到了部署阶段,如果推理文本对当前任务没有用处,TacitVLA 会直接跳过生成。但在记忆任务中,每个新的子任务仍需要写入日志,供后续步骤读取。因此 TacitVLA 会先计算动作,再在机器人执行这个动作的同时写日志。在两个记忆 benchmark 上,每次调用中的日志都能在动作执行完成之前写完,所以没有引入任何额外延迟。
实验结果
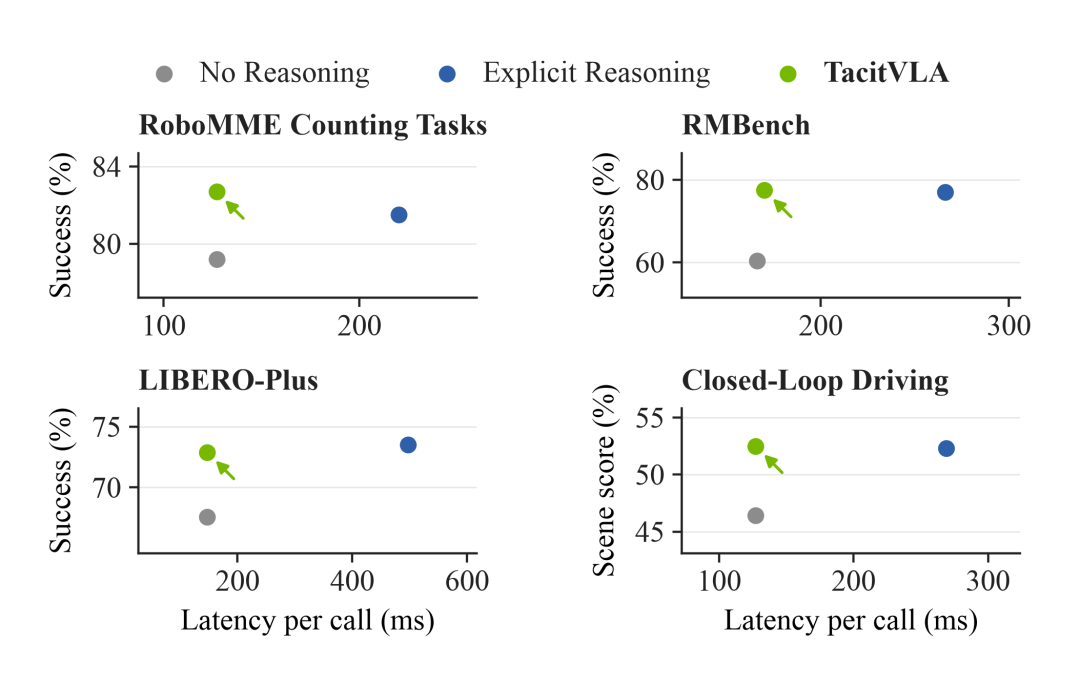
在全部四个 benchmark 上,TacitVLA 的成功率与 Explicit Reasoning 保持在同一水平,均超过 No Reasoning,同时维持了与 No Reasoning 相当的推理速度。
提升最显著的是记忆类 benchmark。在 RMBench 的四个任务上,TacitVLA 的平均成功率为 77.5%,与 Explicit Reasoning 的 77.0% 基本持平,而此前已发表的最好成绩只有 56.5%。相对 No Reasoning(60.4%)的进步,主要来自 Press Button 任务——这个任务中,按钮点击次数只能记录在日志里。在该任务上,No Reasoning 的成功率只有 7.7%,TacitVLA 则达到 74.3%。
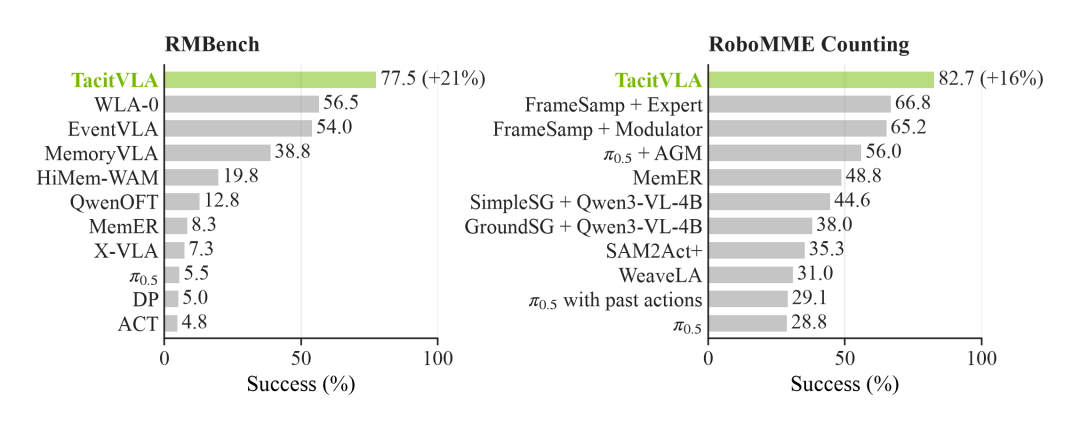
在 RoboMME 上,当使用全部 16 个任务训练时,TacitVLA 的总体成功率为 48.1%,此前的最好结果是 44.5%。在计数任务子集上,TacitVLA 达到 82.7%,此前最好为 66.8%。如果只用计数任务训练,成功率进一步提升至 89.5%,超过了该 benchmark 给出的人类参考成绩 88.5%。值得强调的是,在人类参考设定中,操作者只负责选择高层步骤,具体动作由 oracle planner 执行;而 TacitVLA 的每一个动作都由模型自己完成。
推理的收益不仅仅局限在记忆任务上。LIBERO-Plus 以零样本方式测试七类扰动,两个推理策略在这一 benchmark 上取得了仅用 LIBERO 数据训练的已发表策略中的最高分:Explicit Reasoning 为 73.5%,TacitVLA 为 72.9%,No Reasoning 为 67.6%。
在标准 LIBERO 上,TacitVLA 的成功率达到 98.6%,与已发表的最好结果持平。在公开的 AlpaSim 挑战赛场景中进行闭环驾驶测试时,TacitVLA 的场景得分为 52.5%,Explicit Reasoning 为 52.3%,No Reasoning 为 46.4%。这一成绩与 Alpamayo-R1 仅相差 2.5 分。需要说明的是,Alpamayo-R1 是一个使用四个摄像头输入的 10B 参数模型,而 TacitVLA 的参数量不到它的一半,摄像头也只使用了两个。
在单张 H100 GPU 上,TacitVLA 在 LIBERO 上输出一个动作需要 147 ms,而 Explicit Reasoning 需要 495 ms,前者快了 3.4 倍。在自动驾驶场景中,两者的延迟分别为 127 ms 和 269 ms。在记忆任务上,Explicit Reasoning 慢了 1.4 到 1.7 倍。TacitVLA 则在执行动作期间写日志,日志写入最多只占用执行时间的 23%。
总结
这项研究的实验覆盖了机器人操作与自动驾驶,也涵盖了需要记忆和不需要记忆的任务。在所有设定中,推理带来的收益都通过推理文本上的训练传递给了动作输出。在记忆任务里,收益还通过之前写入的日志传递。而读取当前这一步生成的推理,只会让策略变得更慢,并不会带来更高的成功率。
TacitVLA 不需要引入额外的模型,也不需要额外的调度器。任何采用同类结构的推理 VLA,只要在训练时通过 attention mask 让 action expert 无法看到推理 token,就能转化为 TacitVLA。对 VLA 与推理优化相关技术细节感兴趣的读者,也欢迎到云栈社区继续讨论。
 发表于 23 分钟前
|
查看: 5|
回复: 0
 /1


