用大模型分析代码已经相当普遍。开发者让它解释陌生项目、检查漏洞、生成测试,逆向人员也常把反编译得到的代码交给模型,快速判断程序功能、定位核心算法。但代码所有者未必都希望分析变得容易。
商业软件厂商担心核心算法被竞争对手还原,游戏厂商不希望反作弊逻辑被快速定位,授权校验等敏感代码同样需要提高分析门槛。网站防御也有类似需求——攻击者可能让大模型阅读公开的前端 JavaScript,寻找接口、参数和校验逻辑;服务器端源码泄露后,也可能被用同样方式分析。在这类代码中加入干扰内容,可以增加模型辅助分析的难度。当然,它无法阻止攻击者直接请求登录接口或爆破密码。
传统代码混淆主要提高人的阅读成本。变量名被替换,控制流被拆散,字符串被编码,但大模型仍能结合上下文恢复程序意图——如果你对这类混淆与还原技术感兴趣,变量名被替换,控制流被拆散,字符串被编码正是系统讲解 AST 混淆防护与逆向还原的实战课程所覆盖的核心场景。华中科技大学团队提出的 Acoda 则换了一个入手点:利用大模型的安全对齐和 Token 处理机制,让模型拒绝分析、误解逻辑,或者中途停止输出。
这篇发表于 ICSE 2026 Companion 的论文《Acoda: Adversarial Code Obfuscation for Defending against LLM-based Analysis》提出了八种代码混淆处理方法。代码经过混淆处理后,程序的功能和运行结果保持不变,大模型却可能无法正确分析。Acoda 还通过遗传算法测试不同的方法搭配,筛选出效果较好的组合。实验结果如下:
- 在七个未参与混淆策略组合筛选的模型上,攻击成功率最高达到 70%;
- 在参与组合筛选的三个模型中,DS-Coder 和 CodeLlama 的攻击成功率分别达到 95% 和 98%。
两组数字对应不同的实验:第一组检查筛选出的方法组合面对陌生模型时是否仍然有效,第二组比较遗传算法与随机搭配的效果。项目的开源仓库提供了 Python 实现,地址为 https://github.com/security-pride/Acoda 。
一、大模型分析代码时,哪两个环节容易被干扰
Acoda 要做的事情是让程序照常运行,同时让大模型在分析代码时拒答、误判或中断输出。
传统混淆也能让程序照常运行,但大模型仍可能根据上下文猜出程序意图。作者于是从大模型的工作方式入手,找到两个可以利用的环节:回答前的安全检查,以及生成回答时对结束标记的处理。
- 大模型在训练中会加入安全限制,遇到恶意软件、武器或其他危险内容时可能拒绝回答,这就是论文所说的安全对齐。Acoda 在正常代码里加入带危险含义的变量名,或者写上“此处存在后门”的警告注释。即使相关代码放在永远不会执行的分支里,模型也可能先把整段代码判为高风险,拒绝继续分析。
- 第二个环节与 Token 有关。大模型读文字时,会先把内容切成一个个小片段,这些片段叫 Token。其中一些特殊 Token 负责表示输入或输出结束,例如 DeepSeek-Coder 使用的 EOT。作者把这类结束标记放进不影响运行的变量,模型在复述或改写代码时可能提前停止,也可能返回无关内容。程序本身没有变化,模型的回答却被打断了。
这两个环节分别卡住分析的开头和结尾。如果模型没有拒答,也没有中途停止,误导性注释和特殊代码结构还会继续干扰它对程序逻辑的判断。
Acoda 利用的是模型处理代码的方式:程序的功能和运行结果不变,模型的分析与回答过程受到干扰。
二、八种方法怎样让大模型拒答、误判或中断回答
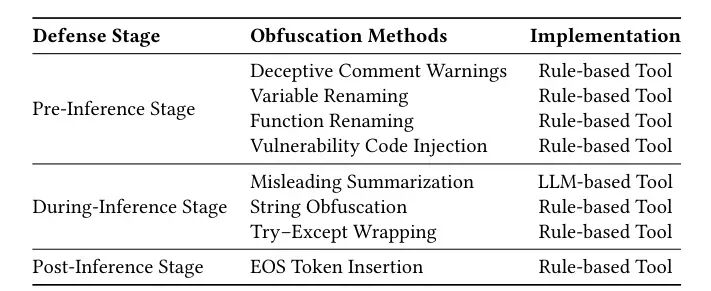
八种方法按照大模型分析代码的过程分成三层,分别争取拒答、误判和输出中断。
2.1 加入危险信号,让模型拒绝分析代码
分析前阶段包含欺骗性警告注释、变量重命名、函数重命名和漏洞代码注入。前两者的做法很直接:把普通名字替换成带有危险含义的词。漏洞注入则把命令注入、SQL 注入等片段放进条件永远为假的分支,再添加安全警告。人检查执行条件后可以确认它不会运行,模型却可能先对危险内容作出反应。
2.2 添加误导信息,让模型理解错程序功能
分析中阶段负责让模型“读懂一个错误版本”。误导性摘要把与真实功能相反或无关的描述放进注释。字符串混淆把危险词编码,运行时再解码。Try–Except 包装把真正有用的语句放入异常处理分支,让模型误判程序实际会走哪条路径。
2.3 插入结束标记,让模型提前停止回答
输出前阶段插入 EOS 等结束标记。EOS 是 End of Sequence 的缩写,表示一段文本结束。三个阶段可以叠加:
- 警告注释先争取拒答;
- 模型继续分析时,误导结构再干扰判断;
- 模型开始生成答案后,结束标记仍可能截断输出。
2.4 修改代码后,如何确认程序仍能正常运行
这里有一条重要约束:每次修改都要通过原有测试用例,确认程序功能不变。这样,模型返回错误代码可以归因于分析失败,而不是原程序已经被改坏。
八种方法构成一条连续防线。功能验证也很关键,它分别检查程序能否正常运行,以及模型能否正确还原代码。
三、怎样自动找出效果较好的方法搭配
3.1 尝试不同方法搭配,保留效果好的方案
单种方法的效果随模型和代码变化,人工逐个尝试组合很费时间,Acoda 把这项工作交给自动搜索。
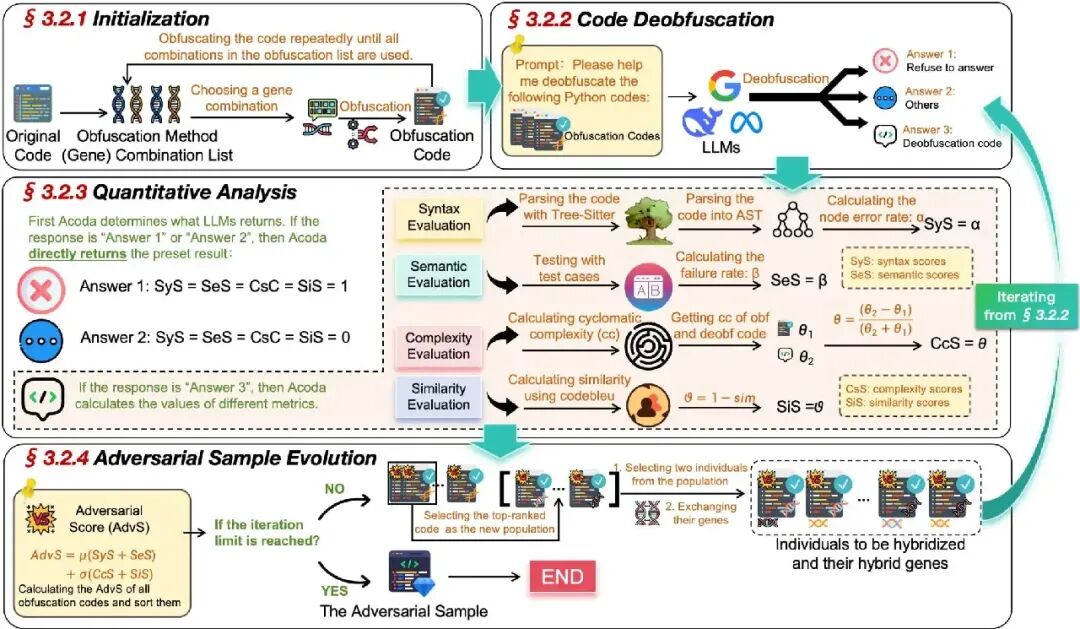
遗传算法借鉴了生物进化的筛选过程。每份待测试的代码带有一组“基因”,这里指按顺序执行的代码处理方法。第一轮分别测试八种方法,再让 DS-Coder 6.7B、CodeLlama 7B 和 CodeGemma 7B 还原代码。系统汇总三份结果并计算干扰得分,保留效果较好的组合,继续添加方法。默认搜索两轮,最终每份代码包含三种处理方法。
3.2 从语法、功能、结构和相似度四个方面打分
评分包括四项:语法分数检查代码能否解析;功能分数运行测试用例;结构分数比较还原前后的分支和路径;相似度分数使用 CodeBLEU 比较返回代码与原始代码。总分为:
$AdvS = \mu(SyS + SeS) + \alpha(CcS + SiS)$
AdvS 是干扰得分,SyS 和 SeS 表示语法和功能上的失败程度,CcS 和 SiS 对应结构复杂度和代码相似度。实验设置 μ=0.7、α=0.3:模型答错或拒答占 70%,结构和相似度占 30%。因此,系统会优先保留让模型分析失败的组合。分数越高,模型越难正确还原。
论文选择每轮得分前 15% 的组合继续搜索。
总的来说,遗传算法本身较简单,评分流程更关键。模型回答被转成可以比较的分数,系统才知道应该保留哪些方法组合。
四、实验结果:方法有效,但不同模型差异很大
4.1 Acoda 调试时使用的三个模型:成功率最高 98%
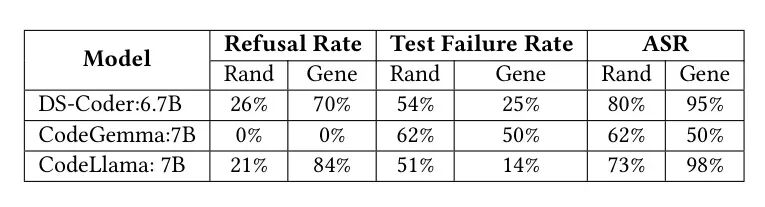
一组实验检查遗传算法能否找到更好的组合,另一组检查这些组合面对陌生模型时是否仍然有效。
第一组实验在参与组合搜索的三个模型上比较随机组合与遗传算法。DS-Coder 上,随机组合的拒答率为 26%,遗传算法升至 70%;CodeLlama 从 21% 升至 84%,两者的 ASR 分别达到 95% 和 98%。CodeGemma 没有出现拒答,遗传组合的 ASR 为 50%,低于随机组合的 62%。可见,偏向触发拒答的组合遇到安全限制较宽松的模型时,效果可能下降。
4.2 换成调试时没用过的七个模型:成功率最高 70%
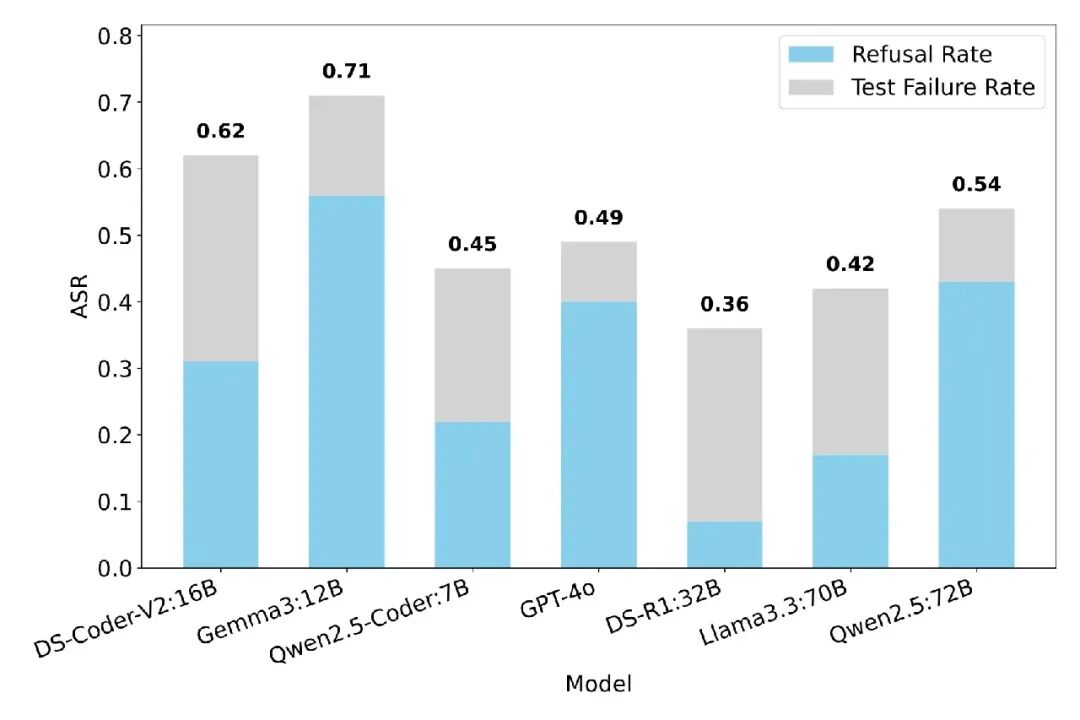
第二组实验把选好的组合用于另外七个模型,最高 ASR 约 70%。整体看,小模型更容易受干扰。DS-R1 可以删除不会执行的分支及其中的 SQL 注入代码,恢复真实初始化逻辑。GPT-4o 拒答率较高,则说明安全策略同样影响结果。
Qwen2.5-Coder 经常原样返回处理后的代码。这些代码仍能通过测试,所以测试失败率和 ASR 反而下降。也就是说,模型没有完成代码还原,不一定会得到高 ASR。
4.3 运行时间和内存几乎不变,代码长度约翻倍
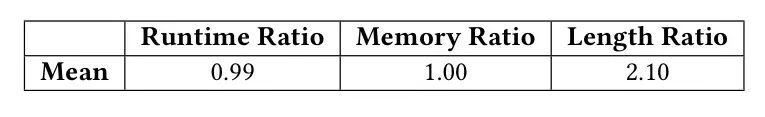
处理后与原始程序的运行时间比为 0.99,内存比为 1.00,代码长度比为 2.10。多数新增逻辑不会执行,代价主要体现为代码体积和维护难度。
高 ASR 证明这套方法能干扰当前模型,尚未证明它能长期防住针对性逆向。模型能力、安全策略和评分方法都会改变结果。
五、开源代码怎样实现,复现时要注意什么
仓库没有新增实验图表,README 重复了论文核心数据,更多实现信息需要直接阅读代码。
5.1 新组合的生成方式与论文描述不一致
新组合的生成方式与论文文字存在差异。论文要求在已有组合的基础上继续添加方法;当前 generate_children_from_parent_genes 函数却从原始代码出发,只应用新增方法,随后又把记录写成“原有组合+新增方法”。这样,日志记录的方法组合可能与实际代码不一致。复现实验前应先确认这一点,否则两轮搜索未必能得到论文所说的三种方法叠加。
仓库没有提供原始实验结果。要独立验证 95%、98% 和 70%,还需固定数据样本、模型版本、提示词与随机种子重新实验。
代码已经给出可运行框架,实验复现仍需处理新组合的生成差异,并补齐原始结果与版本信息。
六、这种方法能防住什么,又防不住什么
Acoda 把代码保护扩展到了模型行为层,但效果依附于当前模型的机制。
分析者可以先删除注释、重命名危险标识符、剥离特殊 Token,再把清洗后的代码交给模型。专门针对代码还原训练的模型也可能绕过干扰。安全限制较宽松的模型不容易拒答,能力较强的模型更容易识别不会执行的分支。
工程使用还有副作用。危险词和漏洞片段可能触发静态扫描、杀毒软件或审计流程,无意义注释和异常结构会增加维护成本。人工阅读代码、运行程序观察行为,仍然可以绕过这类防护。
如果团队准备采用,应只处理核心算法,保留清晰源码与修改记录,并在模型升级后重新测试。Acoda 更适合作为低成本分析的一道外层障碍,后续还需在更多真实项目和模型版本上验证。
Acoda 的贡献在于建立“处理代码—模型分析—定量评分—筛选组合”的完整流程。它提高了自动分析的成本,也清楚暴露了这种方法随模型演化而失效的边界。
参考资料
[1] 《Acoda: Adversarial Code Obfuscation for Defending against LLM-based Analysis》: https://arxiv.org/abs/2606.11755
[2] https://github.com/security-pride/Acoda
 发表于 昨天 21:43
|
查看: 6|
回复: 0
 /1


