一行看似被注释掉的文字,为什么还能打印 Hello?关键在于:Java 会先处理源码中的 Unicode 转义,再识别注释。代码生成器如果把外部文本直接写入注释,就可能让原本的数据变成可执行语句。
原始材料引用了开发者 Emad Khair 于 2026 年 11 月 8 日在 octri.dev 发布的工程文章。开篇程序很简单:一个类、一个看起来为空的 main 方法,以及一行说明性注释。材料记载,用 javac 编译并运行后,屏幕上出现了 Hello。
这不是编译器缺陷,而是 Java 语言规范规定的行为。真正需要追问的是:那行注释从哪里来?开发者通常不会主动这样写,但代码生成器可能把规范文件中的描述当作普通文本,原样抄进源码。下面围绕源码、规范、原始材料记录的复现结果与证据边界,梳理生成器应承担的转义责任。
一、打印 Hello 的源码与事实核查
先区分四件事:源码展示了什么、规范规定了什么、原始材料记录了什么测试结果,以及哪些信息仍然缺失。这样才能判断现象本身与实际影响范围。
1.1 一段看起来什么都不会做的代码
原文给出的源码如下。第三行是双斜杠行注释,其中包含一个 Unicode 转义序列。
class Example {
    public static void main(String[] args) {
        // Description: \u000a System.out.println("Hello");
    }
}
按日常阅读习惯,双斜杠后面的内容属于注释,程序应该没有输出。但在 Java 中,\u000a 会在注释识别之前被转换为换行符 LF。因此,经过 Unicode 转义处理后,源码相当于:
class Example {
    public static void main(String[] args) {
        // Description:
        System.out.println("Hello");
    }
}
行注释到行终止符为止。换行出现后,打印语句脱离注释,成为 main 方法中的可执行代码,运行结果为:
Hello
这段源码是原文的核心演示,也是原始材料所记录的本地复现对象。
1.2 JLS 如何规定处理顺序
Java 语言规范 SE 21 第 3.2 节把源码到 token 的转换分为三个依次执行的词法步骤。第 3.3 节明确指出,编译器先在原始输入中识别 Unicode 转义,再将符合规则的序列转换为对应字符。
这里的 Unicode 转义并不只在字符串字面量中生效。它发生在更早的源码处理阶段,因此也会影响看起来位于注释中的文本。
第 3.4 节将 LF 定义为行终止符,并规定行终止符会结束 // 形式的注释。把相关规则连起来,顺序就是:
- 处理符合资格要求的 Unicode 转义。
- 识别行终止符。
- 将字符流归约为输入元素,识别 token,并丢弃空白与注释。
注释在第三步才被识别,而 \u000a 在第一步就已经变成了换行符。原文称这一现象在 OpenJDK 21 上得到复现,与上述规范一致。
规范还规定了反斜杠是否有资格开启 Unicode 转义,也就是 eligible 规则。对于由普通原始输入组成的连续反斜杠,可以通过前面连续反斜杠的奇偶性判断;涉及由 Unicode 转义产生的字符时,还要考虑规范中的补充条件。这个细节决定了示例何时成立,不能省略。
1.3 原始材料记录的 javac 复现与边界
原始材料记载了三项本地测试,使用环境自带的 javac。材料没有给出该环境的具体编译器版本,因此这里保留测试结果,同时区分作者报告的环境与规范依据。
| 测试用例 |
源码关键行 |
运行结果 |
说明 |
| 标准 LF 转义 |
// D: \u000a System.out.println("Hello"); |
打印 Hello |
注释被换行截断,语句执行 |
| CR 转义变体 |
// D: \u000d System.out.println("CR_PRINTED"); |
打印 CR_PRINTED |
CR 同样属于行终止符 |
| 双反斜杠 |
// D: \\u000a System.out.println("SHOULD_NOT_PRINT"); |
无输出 |
第二个反斜杠不具备开启 Unicode 转义的资格 |
第三项展示了 eligible 规则的作用。对于源码中的 \\u000a,第一个反斜杠后面紧跟另一个反斜杠,并未形成 Unicode 转义;第二个反斜杠前有一个连续反斜杠,因此不具备开启转义的资格。
结果是,整个序列保持为普通注释文本,没有产生新的行终止符。这个现象有明确的成立条件,并非任意带反斜杠的文本都会触发。
1.4 已知结论与证据缺口
原文把重点放在生成器的责任上,没有将现象直接归因于某款产品。评估影响时,也应保留这条边界。
两项信息仍然缺失。第一,原文没有点名具体是哪款 SDK 生成器存在这类问题,而是使用 a code generator 泛指,因此无法据此判断现实中的受影响产品与规模。
第二,原文作者提到的私有复现环境与完整测试脚本没有随文公开。对于 Java 之外的语言,下面以相应官方文档描述的机制为依据,不把未公开的测试过程当作独立验证结果。
二、影响范围:文本进入哪种语言的哪个位置
判断这类问题,不能只看语言名称或某个版本号。更直接的办法是检查两个条件:外部文本是否进入源码生成流程,以及它最终被写入了什么语法位置。
同一份描述字段,放进不同位置,可能得到完全不同的结果。
2.1 关键在于目标语法位置
触发问题通常需要两个条件同时成立:
- 外部来源的文本进入源码生成流程,例如 OpenAPI 规范中的
description 或 example 字段。
- 生成器把文本直接写入具有特殊语法含义的位置,例如 Java 行注释、Ruby 双引号字符串或 Go 反引号字面量,且没有正确处理目标上下文。
缺少其中任何一个条件,上面的触发链就不完整。一份 description 即使包含 \u000a,只要生成器针对目标位置正确编码,阻止它改变注释或字符串边界,就不会按前述方式成为可执行语句。
同样,Ruby 双引号字符串中的 #{...} 具有插值含义。生成器若把来自规范的文本原样放进去,其中符合语法的表达式便可能被求值。
因此,安全边界不能只靠检查文本内容来确定,还必须看生成器如何选择和处理写入位置。
2.2 从 OpenAPI 描述到生成源码
原文使用一段 OpenAPI 文档说明这道边界。下面是其中的路径片段:
paths:
  /users:
    get:
      summary: List users
      description: Returns the users available to the caller.
在这份 YAML 文档里,description 是字符串数据。解析器不需要理解 Java 注释定界符,也不会处理 Ruby 字符串插值。
生成器读取该字段后,可能为客户端方法生成下面这样的文档。以下是方法模板片段,方法体逻辑省略:
/**
 * Returns the users available to the caller.
 */
public List<User> listUsers() {
    // ...
}
这个功能很实用:调用方可以在 IDE 中悬停查看方法说明。风险来自转换过程中跨越的语言边界。
在 OpenAPI 文档里,这些字符是数据;进入源码后,它们就处于目标语言的语法环境中。编译器不知道字符来自规范文件,只会按目标语言的规则解释它们。生成器必须确保描述仍然只是描述,不会改变周围程序。
三、根本原因:Unicode 转义先于注释识别
Java 示例可以完全用语言规范中的处理顺序解释,无须假设任何特殊的编译器实现。
3.1 词法转换的三个步骤
从词法处理的角度看,三个阶段承担不同职责。
第一步处理 Unicode 转义。符合资格要求的 \u000a 在这一阶段变成真正的 LF 字符。
第二步识别行终止符。CR、LF 和 CRLF 都属于 Java 的行终止形式,其中 CRLF 作为一个行终止符处理。
第三步识别输入元素与 token,并丢弃空白和注释。到这一步,编译器才根据已经完成前两步处理的字符流判断注释边界。
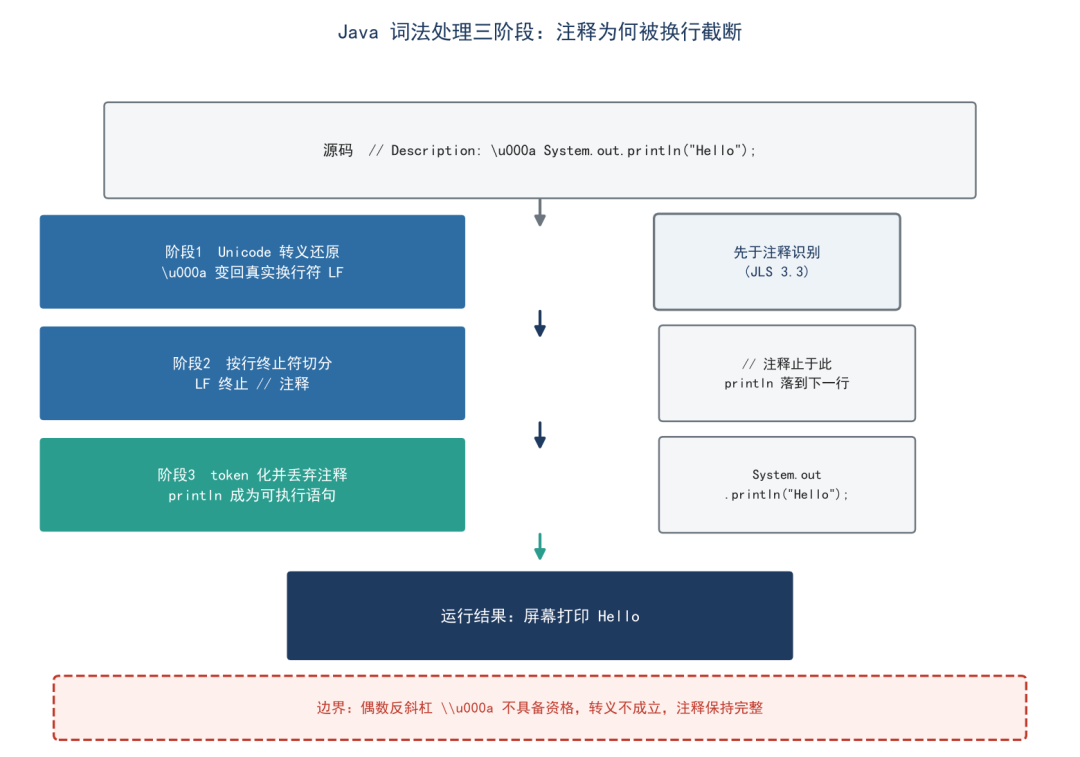
问题就出在顺序上。人读源码时,往往先看到 //,再把这一物理行剩余的内容归入注释。编译器则先转换 Unicode 转义,在识别注释之前就已经生成了换行符。
因此,不能因为一段文字在编辑器里位于 // 后面,就认定其中所有字符都会始终保持注释文本的身份。判断依据应当是完成前置词法处理后的字符流。
3.2 eligible 规则与连续反斜杠
并非所有看起来像 \u 的文本都会被转换。只有具备资格的反斜杠才能开启 Unicode 转义。
对于由普通原始输入构成的连续反斜杠序列,可以回看当前反斜杠前面连续反斜杠的数量:偶数时具备资格,奇数时不具备资格。规范还对最近输出字符由 Unicode 转义产生的情况作了补充规定,完整实现应遵循该规则,而不能只机械计算原始文本中的反斜杠数量。
这解释了前面的双反斜杠用例。\\u000a 中,第二个反斜杠前有一个连续反斜杠,不能开启 Unicode 转义,所以不会生成换行符,注释保持完整。
但不能由此推导出“任何位置都多加一个反斜杠就安全”。如果文本随后又经过模板、序列化或其他转义层,最终源码中的反斜杠数量可能变化。可靠的做法是明确最终输出位置,再由负责该位置的编码组件生成合法表示。
四、同类陷阱:七种语言的语法边界
Java 示例揭示的是一类共同问题:外部文本进入源码后,会受到目标位置的语法规则约束。不同语言的触发机制不同,生成器需要分别处理。
下面按原文涉及的语言与上下文整理边界清单。这些行为不能一概视为任意代码执行;有些会改变值,有些导致编译或文档构建失败,有些则让文档内容参与测试。
| 语言 |
源码位置 |
可能触发的行为 |
| Java |
行注释 |
合格的 Unicode 转义在 token 化之前被转换,可能生成行终止符 |
| PHP |
行注释 |
PHP 结束标签可以终止当前代码块 |
| Ruby |
双引号字符串 |
#{...} 中的表达式被求值 |
| Ruby |
块注释 |
符合位置要求的行首 =end 结束 =begin 注释 |
| Kotlin |
字符串字面量 |
${...} 被作为模板表达式求值 |
| Python |
三引号文档字符串 |
与起始定界符匹配的三引号可能提前结束字符串 |
| Go |
原始字符串字面量 |
反引号结束字面量 |
| Java |
Javadoc 注释 |
不符合要求的 HTML 可能触发文档校验错误 |
| Rust |
文档注释 |
符合条件的代码围栏会被提取为文档测试 |
4.1 PHP 的结束标签
PHP 官方手册的注释章节给出过一个直接展示边界行为的示例:
<h1>This is an <?php # echo 'simple';?> example</h1>
<p>The header above will say 'This is an  example'.</p>
这里使用井号单行注释,后面紧跟 PHP 结束标签 ?>。如果按“井号之后整行都是注释”来理解,就容易误以为结束标签也不会生效。
实际行为是:simple 不会输出,但 ?> 会结束当前 PHP 代码块,后续内容按代码块之外的文本处理。单行注释无法阻止这个边界切换。原文作者称在 PHP 8.5 上复现了同样的行为;这一版本信息属于作者报告。
它与 Java 示例的机制不同。Java 依赖前置 Unicode 转义处理,PHP 依赖代码块结束标签,但两者对生成器提出了同样的要求:不能假设写入注释的外部文本天然不会影响文件解析。
4.2 Ruby 的插值
假设 OpenAPI 字段包含如下示例值:
example: 'Result: #{1 + 1}'
预期保留的字面值是 Result: #{1 + 1}。如果生成器直接用 Ruby 双引号字符串包装它:
EXAMPLE = "Result: #{1 + 1}"
EXAMPLE 的实际值就会变为:
Result: 2
Ruby 官方文档明确说明,双引号字符串允许通过 #{...} 插入其他值。文档也说明,可以通过转义 # 或使用单引号字符串禁用这种插值。具体采用哪种形式,仍需同时处理引号、反斜杠等字符,确保完整保留原值。
这个例子的问题很隐蔽:源码语法正确,程序正常运行,值却变了。插值表达式还可能带有副作用,因此影响并不局限于把示例中的算式提前计算出来。
编译通过只能证明生成代码符合语法,不能证明生成器保留了输入的含义。
4.3 Rust 的文档测试
Rust 的 rustdoc 支持提取并执行文档中的代码示例。下面这段代码展示了文档测试的形成方式:
/// Adds two numbers.
///
/// ```rust
/// assert_eq!(2 + 2, 4);
/// ```
pub fn add(a: i32, b: i32) -> i32 {
    a + b
}
rustdoc 手册说明,在没有其他语言标记或控制属性时,文档代码块默认按 Rust 代码处理。运行下面的命令,会提取相应示例并作为文档测试处理:
rustdoc --test
手册还提供了不同的控制方式:
ignore:让 rustdoc 忽略相应示例。no_run:编译示例,但不运行。text:将代码块标记为普通文本,而不是 Rust 代码。
OpenAPI 的 description 经常包含 Markdown。如果生成器把其中用于展示的代码围栏直接写进文档注释,这些内容便可能参与文档测试。
是否允许外部描述中的示例执行,应由生成器明确决定。仅供展示的文本不应因为继承了 rustdoc 的默认行为,就意外变成可运行测试。
4.4 其他语言的边界
Go 的原始字符串字面量由反引号包围。输入中的反引号如果未经处理,就会提前结束字面量。最终结果取决于后续字符,常见表现是生成代码无法编译。
Python 的三引号文档字符串同样有定界符边界。输入中若出现与外层定界符匹配的三引号,就可能提前结束字符串。除此之外,Python 3.13 对非 raw 字符串中无法识别的转义,例如 \d,会给出 SyntaxWarning;具体构建流程如何处理警告,还取决于工具配置。
Javadoc 则有另一层规则:注释内容会进入文档处理流程。某些不完整或不合法的 HTML 标签会触发校验错误,使文档生成失败,即使 Java 源码本身仍可编译。
这些问题往往在下游暴露。构建日志指向生成后的源文件,开发者看到的是注释、字符串或文档中的错误,根因却发生在更早的“规范文本转源码”环节。
五、修复位置:上下文感知的 emitter
理解这些边界后,很容易想做一个通用清洗函数:删除几个危险字符,然后在所有模板里复用。但不同语言、不同位置的规则并不相同,这种做法很难同时保证安全与保真。
5.1 通用清洗函数为何失效
Java 行注释与 Javadoc 块注释的规则不同,Ruby 单引号与双引号字符串的规则不同。PHP 注释受结束标签影响,Go 原始字符串使用反引号,Rust 文档又支持可执行代码围栏。
即使在同一门语言中,一个值在注释里不会产生问题,也不代表它可以直接写入字符串字面量。编码策略必须与目标位置绑定。
另一类问题是数据被清洗过程破坏。原文给出了一个 Windows 路径示例:
example: 'C:\temp\logs'
如果为了避开转义问题直接删除反斜杠,生成结果即使不再触发语法错误,也已经不是原来的路径。引号、Unicode 字符、正则表达式和 Markdown 都可能遭遇类似损坏。
源码表示可以增加转义字符,也可以改用另一种字面量形式,但对于表示数据值的字段,求值或解码后必须得到原始输入。
5.2 按语言与位置划分 emitter
原文建议将源码输出拆分为按语言、按位置划分的 emitter。下面是概念接口名称,用于说明职责边界,并非某个现成库的 API:
writeJavaDocText(description)
writeJavaStringLiteral(value)
writePhpComment(description)
writeRubyStringLiteral(value)
writeGoStringLiteral(value)
writeRustDocumentation(description)
每个 emitter 接收一个值,输出适合特定语法位置的合法源码表示。它既要知道目标语言,也要知道目标位置是注释、字符串还是文档内容。
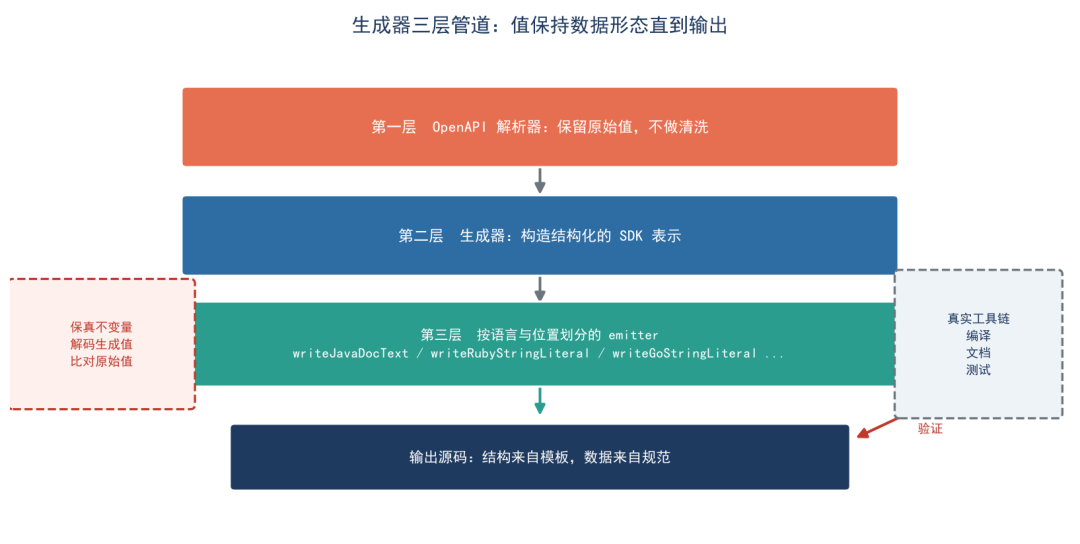
这种设计让生成链路更容易推理:
- OpenAPI 解析器保留原始值,不提前做面向某种目标语言的清洗。
- 生成器构造结构化的 SDK 表示。
- 最终输出时,由对应语言、对应位置的 emitter 编码。
- 使用保真检查和真实工具链验证产物。
生成器其他部分不必各自记住 Java 的 Unicode 转义顺序,也不必重复实现 Ruby 插值处理。相关规则集中在最终负责源码表示的组件中。
一个值保持结构化数据形态的时间越长,它被提前误当作源码语法的机会就越少。
5.3 用保真不变量约束输出
原文提出了一条适合写入测试的不变量:解码或求值生成后的值,再与规范中的原始值比较,两者应当一致。
文档字段不能完全照搬字符串字面量的比较方式,其等价要求是:描述完整保留在预期的注释或文档结构中,且不改变周围程序的含义。
这两种检查都比单看编译结果更接近生成器的真实职责。编译检查回答“源码是否合法”,保真检查回答“生成器有没有改变输入”。
两者结合,才能发现 Ruby 插值这类编译通过但值被改变的问题,也才能抓住清洗函数悄悄删除反斜杠的情况。模板负责程序结构,规范提供数据,生成器应维持两者的边界。
六、验证方法:让真实工具链参与测试
生成器的测试不应停在“字符串是否被替换进模板”。最终产物会交给编译器、解释器、文档工具和测试工具读取,这些工具也应参与验证。
6.1 编译通过不等于生成正确
单元测试可以确认描述被插入某个模板位置,真实工具链则能揭示插入后的语法与行为。但即使编译成功,也仍然需要检查值是否保持不变。
Ruby 插值就是典型例子:字符串合法,程序也可能正常运行,只有将结果与原始输入比较,才能发现语义变化。
同样的要求适用于默认值、枚举成员及其他生成的字面量。这些字段的正确性标准是生成源码所代表的值与规范提供的值一致,而不仅是语法检查通过。
6.2 测试矩阵如何构成
原文建议为每种支持的语言准备一组包含特殊但合法字段值的规范。测试输入至少覆盖:
- 包含注释终止符或其他边界标记的描述。
- 包含引号与插值标记的示例。
- 包含反斜杠的默认值。
- 包含代码围栏的 Markdown。
- 包含 Unicode 转义序列外观的文本。
生成 SDK 后,再按照目标语言的正常开发流程验证:
| 验证环节 |
主要检查目标 |
| 编译或语法检查 |
注释、字符串和其他语法边界是否被破坏 |
| 文档构建 |
Javadoc 等文档校验是否失败,文档内容是否按预期保留 |
| 运行测试 |
是否发生意外插值、求值或示例执行 |
| 原始值比对 |
是否出现静默的数据变化、字符丢失或错误转义 |
这些环节互相补充。只看编译结果,可能漏掉静默插值;只比较生成文本,又可能漏掉真实工具对文档和源码的特殊解释。
6.3 各语言的重点检查项
Java 要覆盖 token 化之前的 Unicode 转义,尤其是能够改变行注释边界的 LF、CR,以及连续反斜杠的资格规则。
Ruby 与 Kotlin 要验证来自规范的文本不会被意外当作插值表达式求值。PHP 要检查生成的注释是否可能被结束标签切换解析模式。
Go 要检查原始字符串中的反引号边界,Python 要检查文档字符串定界符与转义处理。Rust 则需要明确文档示例的处理策略:允许执行的按预期执行,仅供展示的保持展示。
这些检查项看似零散,实际都在验证同一件事:一条描述从 YAML 进入多种目标语言后,是否仍然停留在预期的数据位置。
生成器支持的语言越多,需要维护的字符串形式、注释定界符和文档约定就越多。测试应让最终读取产物的工具参与,而不只是验证生成器内部的字符串处理逻辑。
七、结束语
一段看似无害的 Java 注释能打印 Hello,原因是 Unicode 转义发生在注释识别之前。类似边界也存在于 PHP、Ruby、Kotlin、Go、Python 和 Rust 中,只是触发方式与后果各不相同。
对代码生成器而言,可靠的处理方式是尽量保留原始数据,在最终输出时按语言和位置编码,再用真实工具链与保真检查验证结果。这样,一条来自规范的普通描述才能留在它该在的位置,不会意外影响生成程序的语法、运行行为或文档测试。
八、参考
 发表于 3 天前
|
查看: 20|
回复: 0
 /1


