有网友分享了一段尴尬经历:自己摆烂半年,原本想着等公司裁员,拿一笔 N+1 后离职,结果打开绩效邮件一看,拿到的却是高绩效。
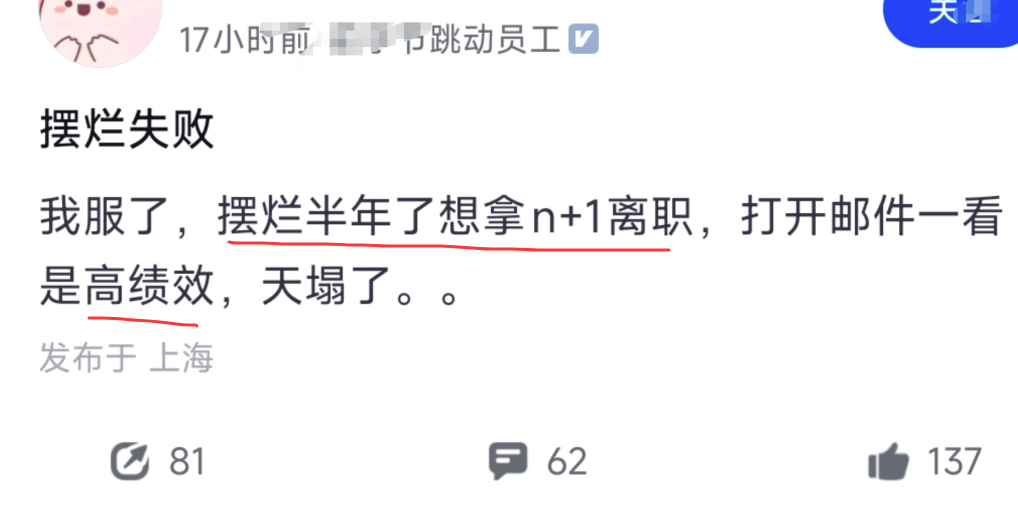
这事放在技术团队里挺有意思。一个开发者即使不再主动承担新需求,手里的核心系统依然稳定运行,线上故障也能及时处理,绩效未必会差。
但这也引出了一个值得复盘的工程问题:为什么有些 Java 系统,开发人员看起来没怎么干活,业务却依然能正常运转?
我在维护老系统时,遇到过一种典型情况:核心业务已经运行多年,需求变化不大,日常工作主要是处理告警、修复小问题,偶尔调整配置。系统表面上很平静,但这种平静往往建立在大量隐性经验之上。
订单服务中的隐性风险
比如一个订单服务,最初的实现可能非常简单:
@Transactional(rollbackFor = Exception.class)
public void createOrder(Order order) {
    orderMapper.insert(order);

    stockMapper.deduct(
        order.getProductId(),
        order.getQuantity()
    );

    paymentService.createPayment(order);
}
业务量小时,这段代码看起来没有问题。但随着业务增长,一些风险逐渐暴露:
- 库存扣减可能出现并发超卖。
- 支付服务超时可能导致事务长时间占用连接。
- 用户重复提交可能产生重复订单。
- 数据库回滚无法撤销已经成功的远程调用。
此前负责系统的开发者,可能已经通过线上经验知道哪些商品容易出现库存竞争、哪个支付接口偶尔超时,以及哪些异常需要人工补偿。
但如果这些知识只存在于某个人的脑子里,系统就存在维护风险。
从支付超时排查连接池耗尽
假设某天订单服务突然出现大量创建失败,监控显示接口 P99 延迟从 200 ms 上升到 3 s。
最开始我也会怀疑数据库,毕竟订单创建涉及多次 SQL 操作。先看慢 SQL:
SELECT *
FROM order_info
WHERE user_id = ?
ORDER BY create_time DESC
LIMIT 20;
执行计划正常,索引也没有明显问题。
再看应用日志:
2026-11-03 10:21:31 ERROR OrderService
payment request timeout
cost=3000ms
orderNo=202611030001

2026-11-03 10:21:32 ERROR HikariPool
Connection is not available
request timed out after 3000ms
这时才发现,问题并不在数据库查询,而是支付接口的同步调用拖长了整个事务。
数据库连接被长时间占用,连接池逐渐耗尽,最终连原本正常的查询也开始超时。
这就是典型的调用链问题:一个下游服务的异常,最终演变成上游服务的整体不可用。
缩短事务范围后,还要考虑补偿
第一步不是马上引入 MQ,而是先缩短事务范围,把远程调用从数据库事务中移出去:
public void createOrder(Order order) {
    order.setStatus("PENDING_PAYMENT");

    transactionTemplate.execute(status -> {
        orderMapper.insert(order);
        stockMapper.deduct(
            order.getProductId(),
            order.getQuantity()
        );
        return null;
    });

    try {
        paymentService.createPayment(order);
    } catch (Exception e) {
        log.error("创建支付单失败, orderNo={}",
            order.getOrderNo(), e);
        throw e;
    }
}
这里解决的是数据库连接被远程调用长期占用的问题,但也引入了新情况:订单和库存已经提交,支付单创建却可能失败。
因此,不能简单地认为事务拆开就万事大吉,还需要明确订单状态流转和补偿机制。
例如支付失败后,可以将订单标记为待补偿:
public void handlePaymentFailure(String orderNo) {
    int updated = orderMapper.updateStatus(
        orderNo,
        "PENDING_PAYMENT",
        "PAYMENT_FAILED"
    );

    if (updated == 0) {
        log.warn("订单状态已变化, orderNo={}", orderNo);
    }
}
这里使用条件更新,避免重复补偿覆盖已经发生变化的订单状态。上述方法只是状态更新示例,实际处理时还需要安排调用和后续补偿;支付超时也不一定意味着支付单未创建成功,需要先确认结果。
如果后续引入 MQ,还需要配合消息表、唯一业务键、消费幂等和定时补偿,不能仅仅依靠消息重试保证数据一致性。
稳定运行的 Java 服务需要沉淀什么
对于已经稳定运行的 Java 服务,我更关注几个具体方面:
| 检查项 |
需要沉淀的内容 |
| 核心业务 |
状态流转和业务规则 |
| 数据库 |
索引、事务边界、数据约束 |
| 外部依赖 |
超时、重试、熔断策略 |
| 并发处理 |
幂等、锁、条件更新 |
| 线上运维 |
告警阈值、故障处理手册 |
| 数据一致性 |
补偿任务、对账机制 |
尤其是核心业务状态,最好通过数据库约束和代码共同保证,而不是依赖开发人员记住操作顺序。
例如订单状态更新:
UPDATE order_info
SET status = 'PAID',
    update_time = NOW()
WHERE order_no = ?
  AND status = 'PENDING_PAYMENT';
通过条件更新控制状态流转,即使重复收到支付回调,也不会重复执行这次状态变更。如果回调还涉及其他业务操作,这些操作仍需分别保证幂等。
这类机制比单纯增加人工检查可靠得多。
回到开头那个拿到高绩效的网友:摆烂半年却拿到高绩效,可能是因为系统已经足够稳定,也可能是过去积累的工程机制发挥了作用。但稳定运行不等于没有技术债。真正需要警惕的是,系统离开某个熟悉它的人之后,还能不能正常运行。
 发表于 昨天 04:33
|
查看: 12|
回复: 0
 /1


