昨天,我分享了自己开发的一款 macOS 原生应用:Whisper Studio。
它最初的目标很简单:让录音转写更准确、更完整,同时保护隐私。
最近,我又对项目进行了几轮迭代。除了优化识别体验,还加入了本地 AI 校对、智能整理、说话人管理、专有词汇自学习等能力。
我也开始意识到:录音转写的终点,也许不是得到一份文字,而是真正理解声音里记录的信息。
从高精度转写开始
Whisper Studio 是一款基于 Mac 本地运行的 AI 录音转写应用,采用 SwiftUI 开发,底层使用 OpenAI 开源的 Whisper large-v3 模型,通过 whisper.cpp 和 Metal 调用 Apple Silicon GPU。
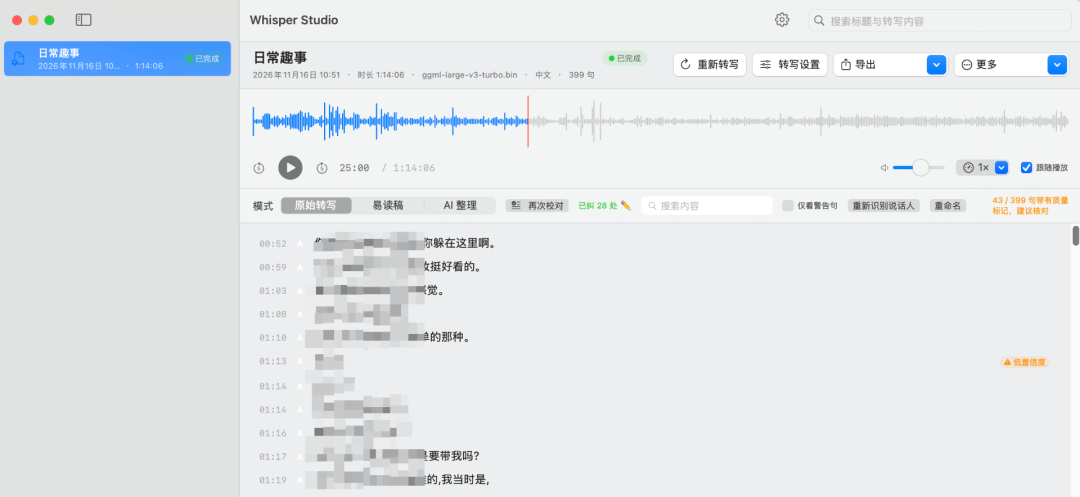
此前,我曾拿它与 OPPO 手机自带的录音转写功能进行实际对比。在测试过的中文对话中,Whisper Studio 的识别效果更好,之前在手机转写中遇到的漏句问题也有了很大改善,测试中几乎没有出现漏句。
这次优化后,性能也有明显提升:在我的测试中,1 小时的录音约 3 分钟就完成转写,多次测试没有异常退出。相比之下,OPPO 手机自带的转写功能有时会失败退出。实际速度和识别效果仍会受设备、模型及录音内容影响。
除了模型本身,我还针对长录音设计了 Silero VAD 语音检测、分块重叠、上下文衔接、幻觉标记以及 SQLite 断点续跑机制。
模型下载完成后,录音、转写和后续 AI 处理均可在本机离线完成,音频不需要上传到第三方服务器。准确、完整、私密,依然是这个产品最基础的追求。
使用本地模型进行处理,后续无需支付 Token 费用,当然,运行设备还是要消耗电力的。
从录音转写到 AI 整理
以前拿到录音转写稿后,还需要自己阅读几千行文字,或者复制到其他 AI 工具中整理。现在,这个过程直接集成到了 Whisper Studio。
新版本增加了三种内容视图:
- 原始转写:逐句保留识别文本与时间戳,方便回听核实。
- 易读稿:自动分段、整理标点,折叠部分重复内容,提高阅读体验。
- AI 整理:通过本地大模型理解录音,生成结构化文稿。
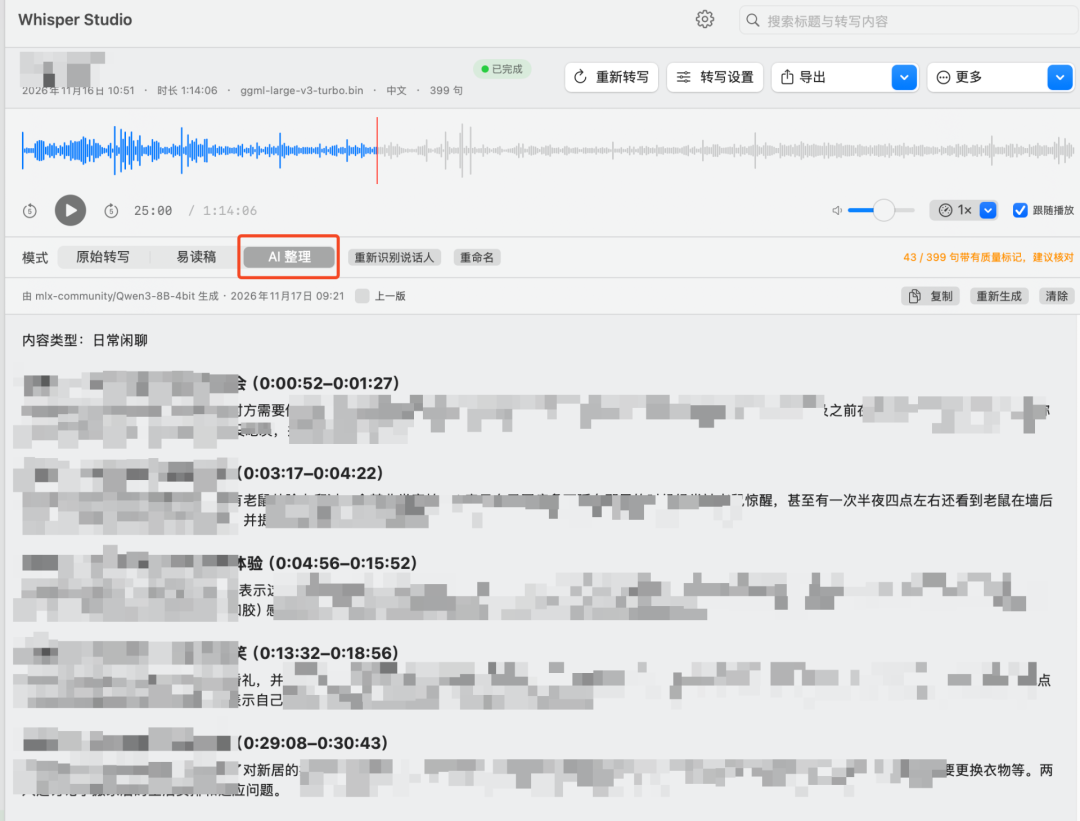
AI 整理采用 MLX 框架,支持 Qwen3 8B 等本地语言模型。后续还会增加更多本地端侧可以跑的小模型。
在我的测试中,8B 模型的总结能力已经相当不错,速度和质量比较均衡。我的机器也可以运行 20 多 B 的模型,但在测试的整理任务中,质量没有明显区别,速度则慢了一些,主要是 Token 生成速度下降了不少。
应用还会根据录音内容自动判断类型。如果是会议,就整理为摘要、讨论要点、决定与待办事项;如果是日常对话,则按照话题组织内容,保留事件、人物、时间以及值得关注的信息。目前来看,这些能力已经足够满足我的日常使用。
针对长达数小时的录音,我设计了分段提取、分层归并的处理方式,避免直接把全部转写文本一次性塞给语言模型。
整理稿可以重新生成,并保留上一版供对比。AI 整理稿与识别文本独立存储,不会因为重新整理而覆盖识别结果。
本地 AI 校对与专有词汇自学习
语音识别很容易遇到一种情况:整句话读起来很通顺,但其中某个词其实识别错了。同音字、近音字和专有名词,在中文口语中尤其容易出现这类问题。
这次新增的本地 AI 校对能力,会分批检查转写句子,让语言模型尝试找出明显错字,同时通过一系列约束降低误改风险。
例如,系统只允许短词等长替换,不随意扩写原句;对于不确定的人名、品牌和专业术语,则倾向于不修改。
经过 AI 校对的句子会显示标记。点击标记,可以对比识别文本与校对文本,必要时一键恢复。
这里还加入了一个我很喜欢的设计:专有词汇自学习。
当用户手动修正人名、产品名称或专业词汇时,系统可以提取部分修正词汇,积累到本地热词库,供后续语音识别参考。转写设置中也可以针对当前录音填写专有词汇提示。
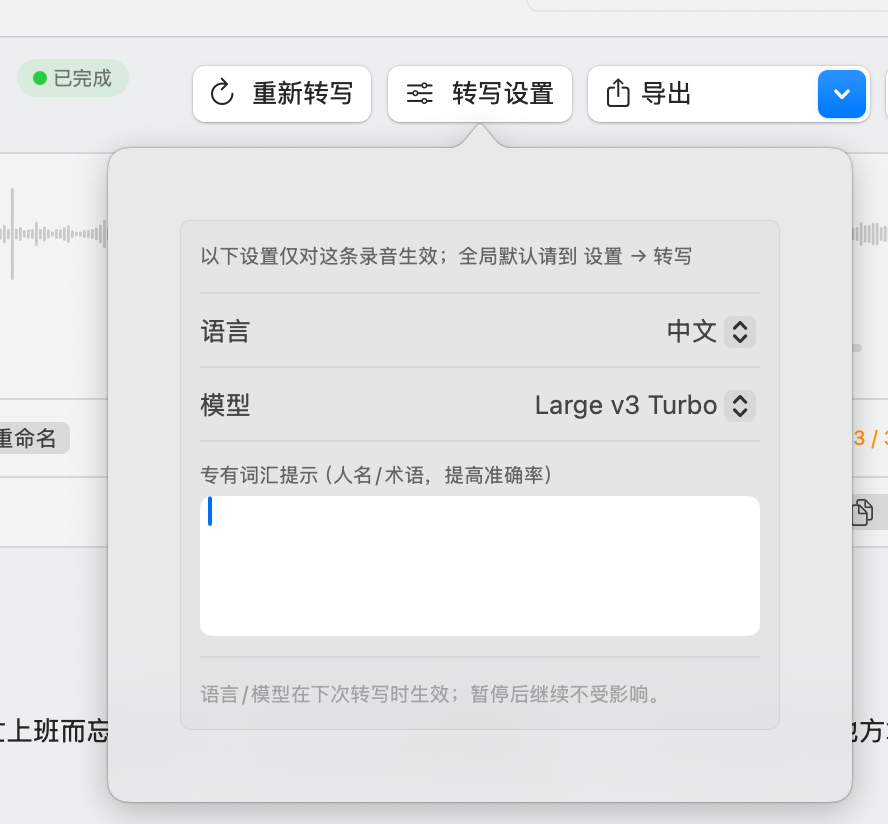
这样一来,应用不再只是每次独立处理录音,还能逐渐适应自己的使用场景。
当然,目前 AI 校对主要依赖文本上下文,并不是重新听音频,因此有歧义的修改仍然需要人工复核。
说话人管理与长录音体验
除了大模型能力,这次我也花了不少精力改善使用体验。
例如,两个人的对话可以自动尝试区分说话人 A、B。用户既可以点击标签修正,也可以自定义说话人姓名,修改后的称呼会同步应用到易读稿与导出内容。
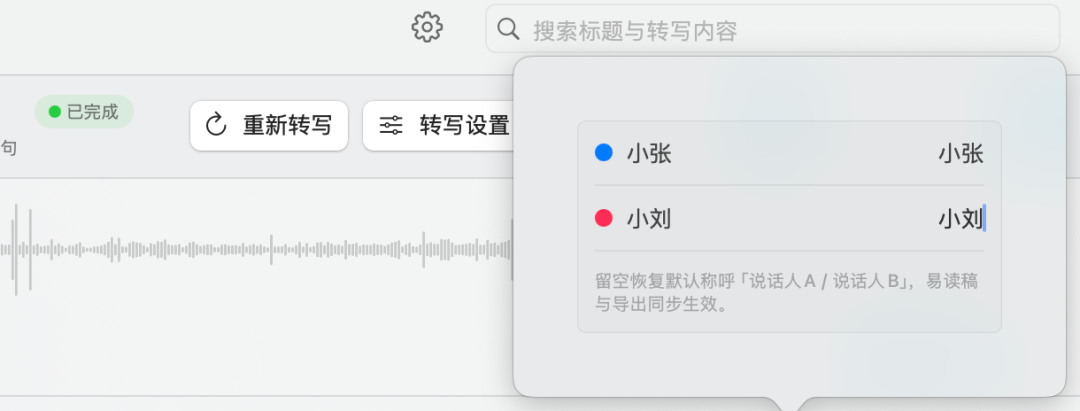
音频波形与逐句文本继续保持联动,点击任意一句便能跳转播放。新增的全文搜索与键盘快捷键,也让长录音的查找和校对更方便。
模型策略更加灵活:高精度模式继续使用 large-v3,同时在满足条件时,可以对超过 30 分钟的录音自动切换到 large-v3-turbo,换取更快的处理速度。
底层仍然保持一个原则:本地优先,数据可控,任务可靠。
录音、转写结果、AI 校对文本和整理稿分别管理;长任务按分块保存进度,异常退出后也会尽可能继续完成原来的工作。
接下来,希望 AI 能自己发现错误
虽然这次增加了 AI 校对,但我认为,高可靠录音转写仍有很大的改进空间。
当某句话被标记为低置信度时,系统能不能自动截取对应音频,换一种识别策略重新听一遍?
当两种转写结果不一致时,能不能给出候选词,让用户直接点击播放确认?
再进一步,每条 AI 会议结论能不能追溯到原始录音的具体时间?
这些都是我下一阶段重点思考的方向。从 Speech-to-Text,到 Speech-to-Verified-Text,再到真正理解录音内容的本地 AI 工作台,我希望 Whisper Studio 不仅能记录说过的话,还能帮助我们整理信息、发现问题、回顾重要内容。
而这一切,都可以在自己的 Mac 上完成。
好的 AI 工具,不应该只是模型能力的展示,还应该让技术融入日常工作与生活,在准确性、隐私和体验之间找到实用的平衡。
后续迭代方向
接下来的规划仍然围绕转写的核心需求:转得准、转得快、用起来轻松。我希望继续打磨这些能力,而不是一味增加功能。
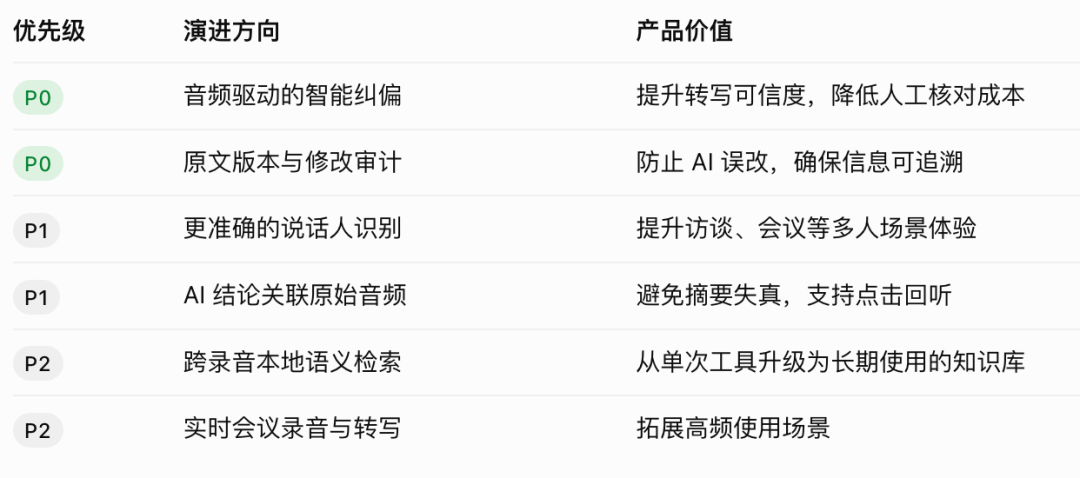
目前规划的方向包括音频驱动的智能纠偏、原文版本与修改审计、更准确的说话人识别、AI 结论关联原始音频,以及跨录音本地语义检索和实时会议录音转写。这些都是后续计划,具体实现仍需继续探索。
 发表于 昨天 04:10
|
查看: 8|
回复: 0
 /1


