前言
业务数据量涨到几个亿,单表查询开始变慢,你的第一反应是不是分库分表?
于是引入 ShardingSphere,把订单表拆成 64 片。结果分片规则要维护,跨片查询要自己拼,扩容要迁移数据,大表 DDL 还要担心主从延迟。
那么不分库分表,能解决问题吗?
可以,用 TiDB。
用了它,你不用再管分片规则,加机器就是扩容,跨库 JOIN 可以直接写,分析查询和交易查询还能共用同一个入口。
这篇文章就来聊聊 TiDB,希望对你有帮助。
一、TiDB 到底是什么?
有些小伙伴可能会问:“TiDB 不就是个国产分布式数据库吗?跟分库分表有什么区别?”
区别在于:分库分表是你在应用层“模拟”分布式,TiDB 是数据库本身“就是”分布式。
分库分表的本质,是在单机 MySQL 的上层加一层路由。
数据仍然存放在多个独立的 MySQL 实例里。跨片查询、分布式事务、全局一致性,都要你在应用层自己解决。
TiDB 是原生分布式数据库。
它的计算层和存储层是分离的,存储层本身就是多副本、强一致的。你写一条 SQL,TiDB 自己决定怎么拆、怎么算、怎么合并,不需要你告诉它“这个表分几片”。
一句话概括:TiDB 把“分布式”这件事从应用层收回了数据库层。你面对的是一个逻辑上完整的数据库,背后怎么分布,它自己管。
二、一张图看懂 TiDB 的架构
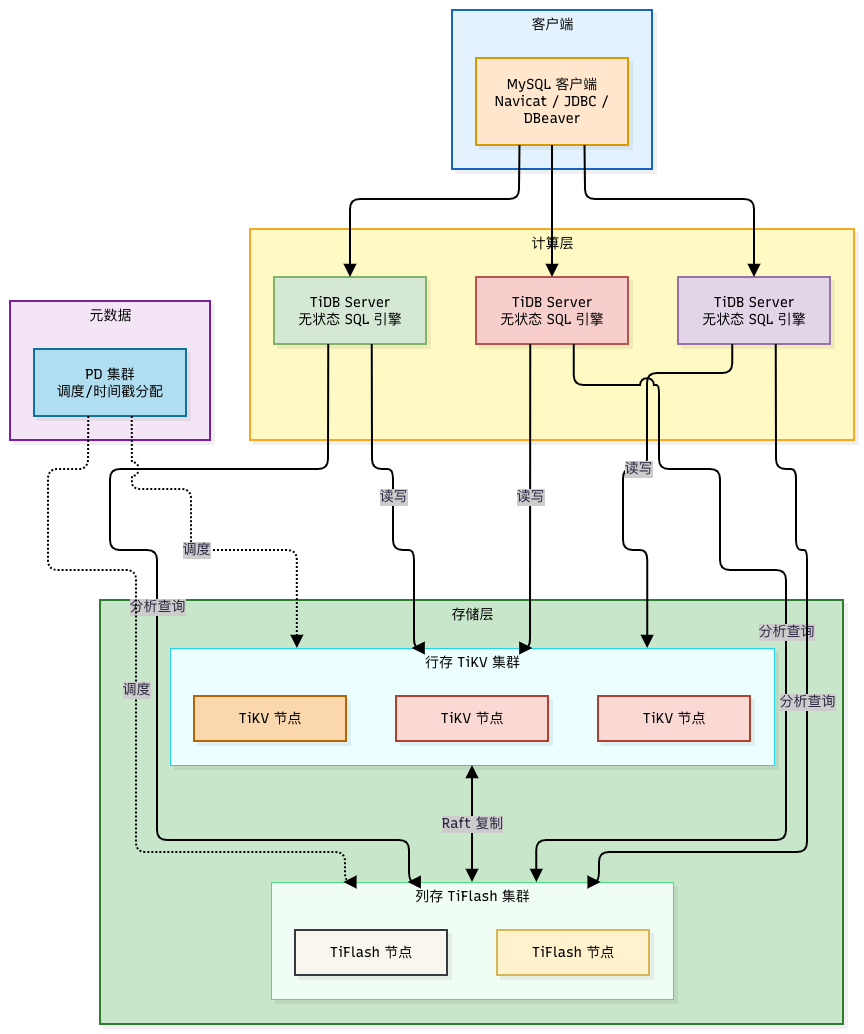
TiDB 的架构分为三层:
- 计算层(TiDB Server):无状态的 SQL 引擎,负责解析 SQL、生成执行计划、把请求发给存储层,再汇总结果返回。加机器就能提升计算能力,不需要停机。
- 存储层(TiKV + TiFlash):TiKV 是行存引擎,负责 OLTP 的高并发读写。TiFlash 是列存引擎,负责 OLAP 的复杂分析查询。两者自动同步,保持强一致。
- 调度层(PD):负责集群元数据管理、负载均衡和时间戳分配。Region 的调度、副本的分布,都由它决定。
三、底层原理
3.1 自动分片:Region 就是 TiDB 的“分片”
MySQL 分库分表,分片规则由你定义。TiDB 不需要,它自己分。
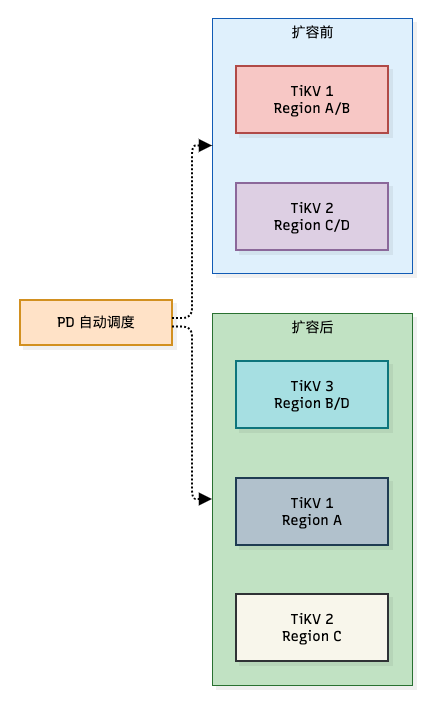
TiDB 把数据按 Key 的范围切成一个个 Region,默认每个 Region 大约 96MB。当 Region 变大或变热,PD 会自动把它分裂成两个,再调度到不同的 TiKV 节点上。
这意味着什么?
你不需要预判“这张表会涨到多大、该分几片”。TiDB 会根据实际数据量和访问压力自动调整。扩容只要加 TiKV 节点,PD 就会把 Region 迁移过去,数据自动均衡。
3.2 Raft 协议:强一致是怎么保证的
TiKV 的每个 Region 都有多个副本,通常是 3 个。副本之间用 Raft 协议同步。
写入一条数据时,Leader 副本先写,再同步给 Follower。多数派(2 个)确认之后,写入才算成功。 如果 Leader 挂了,Raft 会自动选出新的 Leader,数据不丢。
这就是 TiDB 高可用的基础。 单机故障时,Raft 自动切换,RTO 在秒级。你不需要像 MySQL 那样配置 MHA 和主从切换脚本。
3.3 HTAP:一套系统,两种负载
在 HTAP 上,TiDB 跟传统分库分表方案的差距最大。
分库分表之后要做实时分析怎么办?通常是把数据同步到 Hive 或 ClickHouse,T+1 出结果。同步链路越长,延迟越大,数据一致性也越难保证。
TiDB 的做法是:行存 TiKV 和列存 TiFlash 同时存在,TiFlash 通过 Raft Learner 实时从 TiKV 同步数据。 你写一条 SQL,TiDB 的优化器会自动判断:OLTP 查询走 TiKV,OLAP 查询走 TiFlash。
擎文集团的案例很典型。他们原来用 MySQL 分库分表,离线分析走 Hive,T+1 出结果。迁到 TiDB 之后,一套数据库同时支撑在线业务和实时分析需求,不用再维护同步链路。
四、从 MySQL 迁到 TiDB,要改什么?
4.1 连接串改一下
// 原来连 MySQL
String url = "jdbc:mysql://mysql-host:3306/mydb";

// 换成 TiDB
String url = "jdbc:mysql://tidb-host:4000/mydb";
端口从 3306 变成 4000,其他基本不变。
TiDB 兼容 MySQL 协议,JDBC 驱动、连接池配置和大部分 SQL 语法都不用动。
4.2 建表语句:AUTO_INCREMENT 的坑
TiDB 支持 AUTO_INCREMENT,但有一个细节要注意:如果表没有显式指定主键,TiDB 会用 _tidb_rowid 作为行标识。它和自增列共用一个分配器,可能导致 ID 跳号。
-- 建议:显式指定主键,并考虑用 AUTO_RANDOM
CREATE TABLE orders (
    id BIGINT PRIMARY KEY AUTO_RANDOM,
    user_id BIGINT,
    amount DECIMAL(10,2),
    created_at DATETIME
);
AUTO_RANDOM 是 TiDB 特有的,用来避免自增主键造成的写入热点。
如果表的写入量很大,建议用 AUTO_RANDOM,而不是 AUTO_INCREMENT。
4.3 查询:跨库 JOIN 直接写
分库分表时代,跨片 JOIN 要么在应用层拼,要么用广播表。
在 TiDB 里,你直接写:
SELECT o.id, u.name, o.amount
FROM orders o
JOIN users u ON o.user_id = u.id
WHERE o.created_at > '2026-01-01';
TiDB 自己决定怎么拆、怎么算、怎么合并。 你不需要关心数据在哪个 Region 上。
五、用 AI 帮你分析 TiDB 的慢查询
TiDB 的慢查询日志是结构化的,你可以把慢查询日志和 EXPLAIN 结果交给 AI,让它帮你分析“这条 SQL 为什么慢、该加什么索引”。
场景:一条查询在 TiDB 上跑得很慢,EXPLAIN 显示走了全表扫描。
第一步,把 EXPLAIN 结果贴给 AI。
“这是我的 TiDB EXPLAIN 结果。这条查询扫描了 200 万行,但只返回 10 行。帮我分析一下为什么没走索引,以及应该加什么索引。”
AI 会分析执行计划,发现查询条件用了 WHERE status = 'PENDING' AND created_at > '2026-01-01',但表上只有 created_at 的单列索引。它会建议你加一个联合索引 (status, created_at)。
第二步,让 AI 帮你验证。
“在 TiDB 里加联合索引需要注意什么?会不会影响写入性能?”
AI 会告诉你,TiDB 的 DDL 是在线的,不锁表,但加索引会消耗资源,建议在低峰期执行。它还可能提醒你:如果 status 的区分度很低,单独为它建索引的收益有限,可以评估只针对 status = 'PENDING' 的行建部分索引(partial index)是否适用于你所用的 TiDB 版本,以减少索引体积。
AI 不能替你做的事:判断“这个索引到底该不该加”。也许你的写入量很大,加索引的代价超过了查询优化的收益。AI 帮你理解执行计划,权衡由你来做。
六、优缺点
优点
1. 不用分库分表
Region 自动分裂、自动调度、自动均衡。扩容就是加节点,数据自动迁移,不需要维护分片规则。
2. MySQL 兼容,迁移成本低
JDBC 驱动、连接池和大部分 SQL 语法都不用改,业务代码改一个连接串就能跑。
3. HTAP,一套系统两种负载
TiKV 扛 OLTP,TiFlash 扛 OLAP,不用再搭一套同步链路到 Hive 或 ClickHouse。
4. 金融级高可用
Raft 多副本,多数派确认,自动故障转移。RTO 秒级,数据零丢失。
5. 在线 DDL,不锁表
亿行大表的 DDL 也能在线执行,不阻塞业务读写。
6. 真实大厂验证
Kimi.ai 用 TiDB Cloud 为 AI Agent 提供数据库基础设施,1 秒内创建隔离数据库。Flipkart 用 TiDB on Kubernetes 做到每秒 100 万查询。
缺点
1. 不是 100% 兼容 MySQL
存储过程、触发器、事件、自定义函数、全文索引、空间数据类型,TiDB 都不支持。如果你的业务重度依赖这些,迁移需要改造。
2. 运维模型不同
TiDB 的运维跟 MySQL 不一样,你需要理解 PD、Region、Raft 这些概念。虽然 TiUP 和 TiDB Operator 能简化运维,但学习成本依然存在。
3. 写入热点需要处理
自增主键在 TiDB 上容易产生写入热点,需要用 AUTO_RANDOM 或在业务层生成 ID 来分散写入。
4. 资源消耗比单机 MySQL 高
TiDB 是分布式系统,最小生产部署也需要多个节点。对于小数据量、低并发的场景,它的资源消耗不划算。
七、适用场景
| 场景 |
推荐程度 |
理由 |
| 数据量大、分库分表运维痛苦 |
✅✅✅ 强烈推荐 |
Region 自动分片,不用维护分片规则 |
| 需要 HTAP(交易+实时分析) |
✅✅✅ 强烈推荐 |
一套系统两种引擎,不用搭同步链路 |
| 金融级高可用要求 |
✅✅✅ 强烈推荐 |
Raft 多副本,自动故障转移 |
| AI Agent 的数据库基础设施 |
✅✅✅ 强烈推荐 |
Kimi.ai 已验证,1 秒创建隔离库 |
| 依赖存储过程/触发器/全文索引 |
⚠️ 需评估 |
TiDB 不支持这些特性 |
| 小数据量、低并发 |
❌ 不推荐 |
资源消耗不划算,MySQL 够用 |
八、写在最后
回到最初的问题:为什么越来越多人用 TiDB?
因为它把“数据量大了怎么办”这个问题,从“应用层怎么拆”变成了“数据库自己怎么分布”。
分库分表解决的是“单机撑不住”的问题,但它带来了新的麻烦:分片规则、跨片查询、分布式事务、扩容迁移。TiDB 把这些问题收回到了数据库层。你面对的是一个逻辑上完整的数据库,背后怎么分布、怎么复制、怎么调度,它自己管。
HTAP 是另一个让 TiDB 拉开差距的能力。
分库分表之后做实时分析,你要搭同步链路,还要维护两套系统。TiDB 的 TiFlash 让交易和分析跑在同一个入口,数据实时一致。
当然,TiDB 也有代价。
它不 100% 兼容 MySQL,存储过程、触发器、全文索引都不支持。运维模型也不一样,你需要理解 PD、Region、Raft。对于小数据量、低并发的场景,它的资源消耗不划算。
但对于“数据量大到 MySQL 撑不住、又不想维护分库分表”的团队来说,TiDB 是一个经过大规模验证、持续迭代、兼容 MySQL 的选择。
如果你想继续探讨分布式数据库的选型和落地,也可以到云栈社区和同行交流经验。
参考资源:
 发表于 6 小时前
|
查看: 2|
回复: 0
 /1


