一份没有上热搜的 PDF,悄悄把一个时代命题说透了。
2026 年 9 月,哈佛大学图书馆( Harvard Library )发布了一份只有 10 页的战略报告《 Advancing Open Knowledge 》。没有发布会,没有刷屏标题,但它干了一件很重的事:把六年前( 2020 年)的那套战略框架彻底重校准,而触发这次重写的唯一核心变量,是生成式 AI。
别小看一份图书馆文件。哈佛图书馆管的不是普通书架,而是囊括珍本、档案、全球学科文献与大学记忆的超大型知识系统,它的战略选择,往往是整个学术界的风向标。当年它押注开放获取,行业跟着松绑;今天它把 AI 写进方向性目标,等于给「知识底座该怎么建」定了个样板,也替所有做知识工程的人省了一次重新论证。
更值得玩味的是报告里的一句话:「我们的馆藏,是与新工具配对的必要数据。」在哈佛的叙事里,象牙塔里那些被策展、被溯源、被长期保存的文献,不再只是用来借阅的纸和库,它们是喂给 AI 的可信燃料。这不正是我们做知识图谱、做 RAG、做医疗知识库一直在追的那条主线吗——没有可信出处,再强的模型也只是精致地胡说。
这篇推文不聊论文,聊一份机构战略报告。因为它比很多技术博客都更早、也更权威地,把「知识底座」这件事讲明白了。
一、背景:六年前的框架,为什么现在要重写
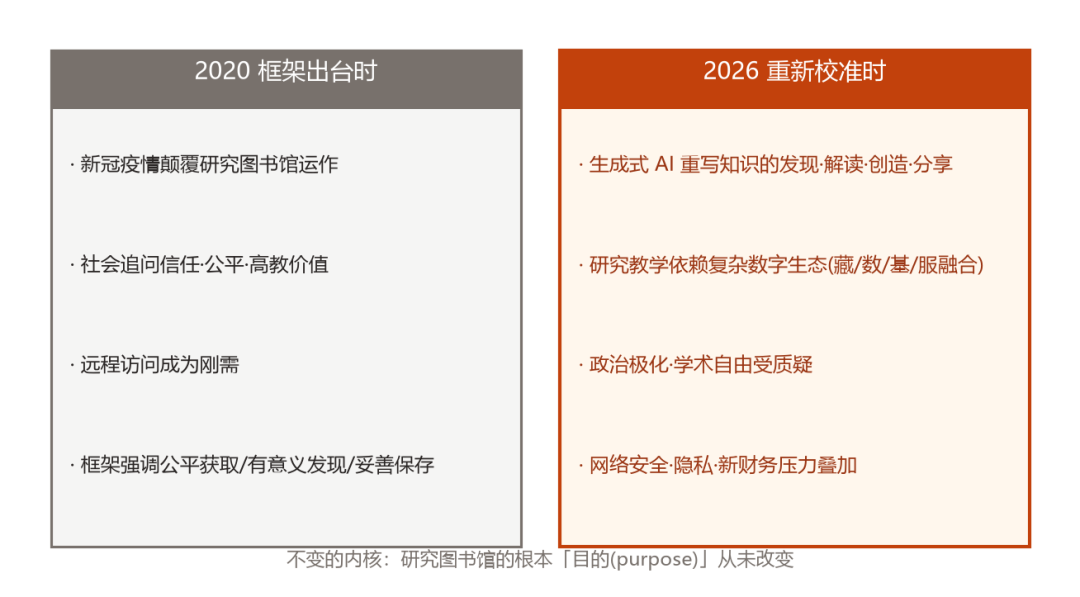
哈佛图书馆在 2020 年曾提出过一套战略框架《 Advancing Open Knowledge: A Discussion of Harvard Library's Strategic Directions 》,当时的出发点是公平获取、有意义发现与妥善保存。那套框架诞生在新冠疫情的动荡里,社会正在追问信任、公平与高等教育的公共价值。
六年过去,风景全变。报告毫不回避地写道:生成式 AI 正在从根本上改变知识被「发现、解读、创造与分享」的方式。与此同时,研究与教学越来越依赖复杂的数字生态,馆藏、数据、基础设施与服务之间的传统边界被抹平;高校还要在政治极化、学术自由受质疑、网络安全与隐私担忧、以及新的财务压力之间艰难行走。
但报告也留下了一句很稳的话:环境变了,研究图书馆的根本「目的( purpose )」没有变。它要做的,是在不丢失使命与价值观的前提下,把那套耐用框架更新到当下语境。这正是这份 2026 版报告的全部动机。
值得记一笔的是,报告专门说,过去几年的一个教训,是那套 2020 框架的「核心洞见与方向性目标」被证明既相关又有韧性,成了穿越变化的耐用框架。这套骨架经受住了疫情与 AI 两次冲击波。一个机构愿意在六年后回写而非推翻,本身就说明它的价值观经得起时间。
下面这张表,把两次出台时的「世界」摆在一起,差异一目了然。
| 维度 |
2020 框架出台时 |
2026 重新校准时 |
| 技术触发点 |
新冠疫情颠覆图书馆运作 |
生成式 AI 重写知识全链路 |
| 社会情绪 |
追问信任·公平·高教价值 |
政治极化·学术自由受质疑 |
| 基础设施 |
远程访问成为刚需 |
复杂数字生态(藏/数/基/服融合) |
| 新增压力 |
相对单一 |
网络安全·隐私·新财务压力叠加 |
| 框架内核 |
公平获取/有意义发现/妥善保存 |
同上,但全部围绕 AI 重排 |
二、框架:一份报告的结构,本身就是价值观
翻开报告,开头不是战略,而是使命与价值。哈佛图书馆先重申了自己的 Purpose :「我们为世界的向好而倡导好奇心( We champion curiosity for the betterment of the world )」;再列五项价值观:以好奇引领、寻求协作、拥抱多元视角、倡导开放、追求非凡。
这种「先讲为什么,再讲做什么」的写法,值得每一个做知识库产品的团队抄作业。报告随后给出六大板块:引言、学术共同体、信息环境、战略方向、组织、前路。其中真正扛事的是中间那块——三大战略方向。
报告自己说,这些方向性目标「既反映了哈佛图书馆作为世界顶尖研究图书馆的独特优势与责任,也驱动着我们与校内、同行机构及全球伙伴的持续协作,去支撑一个有韧性、包容且可持续的知识环境」。注意「协作」二字,它不是孤军作战的宣言,而是知识公地( knowledge commons )的共建书。
顺带说,这种「先价值观、后战略」的写法,刚好反衬出不少 AI 产品的通病:一上来就堆功能,却说不清为谁、凭什么、守什么。哈佛把 purpose 写在最前,等于先钉死了「为什么」,后面的采、用、存才不跑偏。做医疗知识库时我们也反复吃亏在这一点——没想清临床终点的产品,再花哨也落不了地。
三、方法:三大战略方向到底在指什么
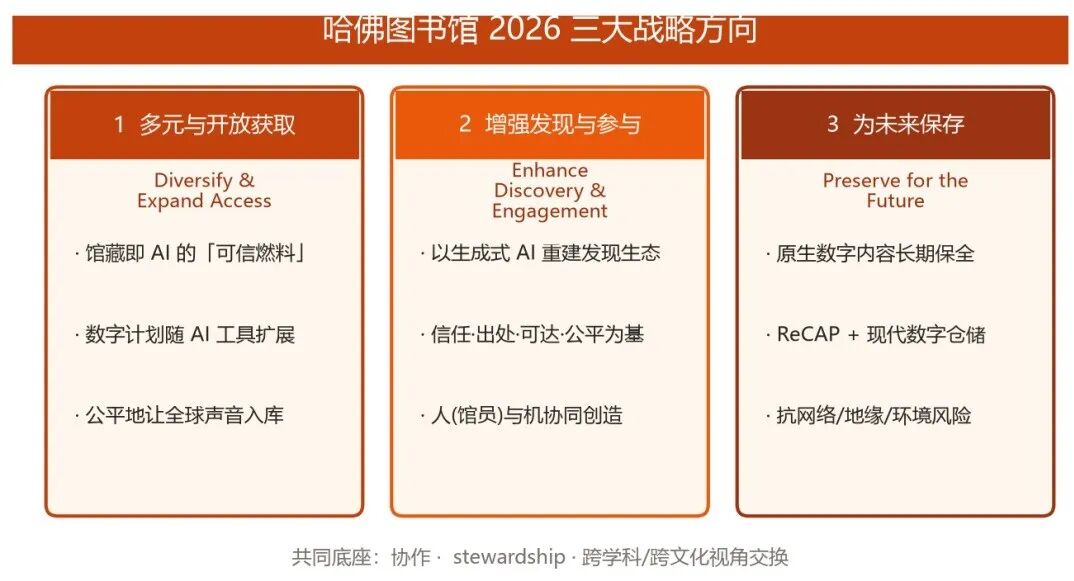
三大方向不是口号,每一条都对应着具体的动作。我用一张表把它压成骨架,方便对照。
| 战略方向 |
英文 |
核心动作 |
与 AI 的关联 |
| 多元与开放获取 |
Diversify and Expand Access |
持续建设反映未来研究需求的馆藏;最大化传播影响力 |
馆藏被定义为「与新工具配对的数据」,数字计划需随之扩容 |
| 增强发现与参与 |
Enhance Discovery and Engagement |
用生成式 AI 重建数字生态;馆员协助师生用 AI |
以信任·出处·可达·公平为基,人机协同创造知识 |
| 为未来保存 |
Preserve for the Future |
保全原生数字内容;ReCAP 与现代数字仓储 |
直面网络/地缘/环境风险,靠协作网络提升韧性 |
第一条讲供给侧:馆藏不只是资产,更是 AI 时代的可信语料。第二条讲发现侧:把 AI 嵌进研究发生的每一个地方,但必须扎根图书馆的价值观。第三条讲时间侧:今天生产出的数字内容,要让下一代也能用。
三条合起来,其实就是知识生命周期的「采、用、存」——而 AI 被放进了前两个环节的心脏位置。
这里有个容易忽略的细节:三条方向里,没有一条把 AI 当成「替代馆员」的借口。报告反复把「人(馆员与档案员)」放在发现与创造的核心,AI 是「被配对的新工具」,不是主角。这对担心被模型取代的知识工作者,是一颗定心丸,也是一句提醒:工具越强,人的策展与判断越值钱。
四、结果:几个被低估的关键事实
报告里散落着几个数字和判断,单独看平平无奇,连起来却很吓人。
其一,流量入口已经易主。 报告写道,哈佛图书馆系统里「 roughly half of the traffic 」现在来自商业搜索引擎。也就是说,用户常常在根本没意识到自己正在用图书馆时,就已经通过 Google 进了图书馆的资源。这对所有做知识服务的团队都是一记警钟:你的入口,可能早就不归你管了。
其二,学生已经用 AI 起步。 报告明确说,学生正常态化地用生成式 AI 工具开启研究。这不是趋势预测,是已经在发生的行为。当第一代「 AI 原生」研究者进场,知识库如果还停在「检索框 + 文献列表」,就会被跳过。
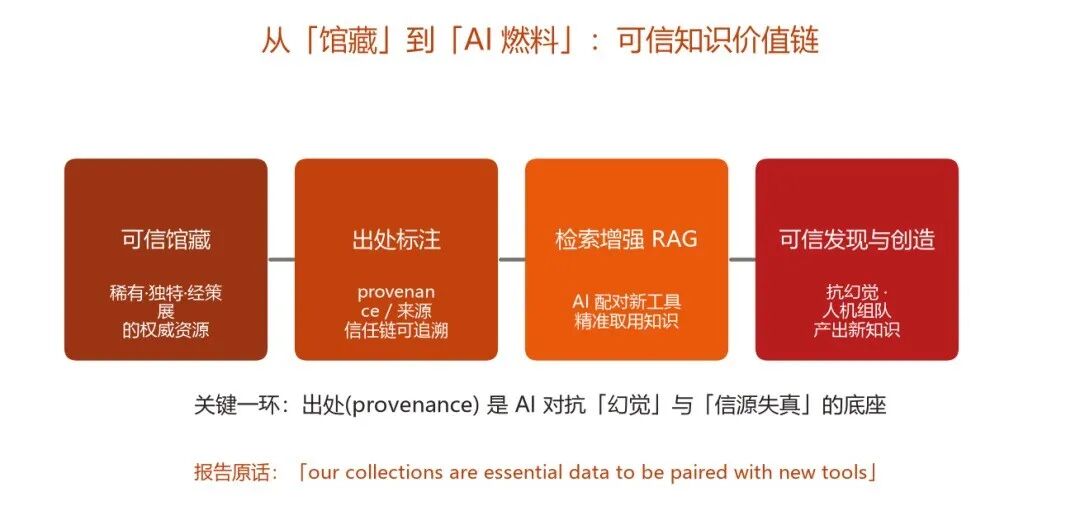
其三,馆藏即燃料。 报告原话:「 with generative AI changing how knowledge is discovered and produced, our collections are essential data to be paired with new tools 」。这句话是整份报告的题眼——被策展、被确权、被溯源的馆藏,是 AI 不可绕开的必要数据。
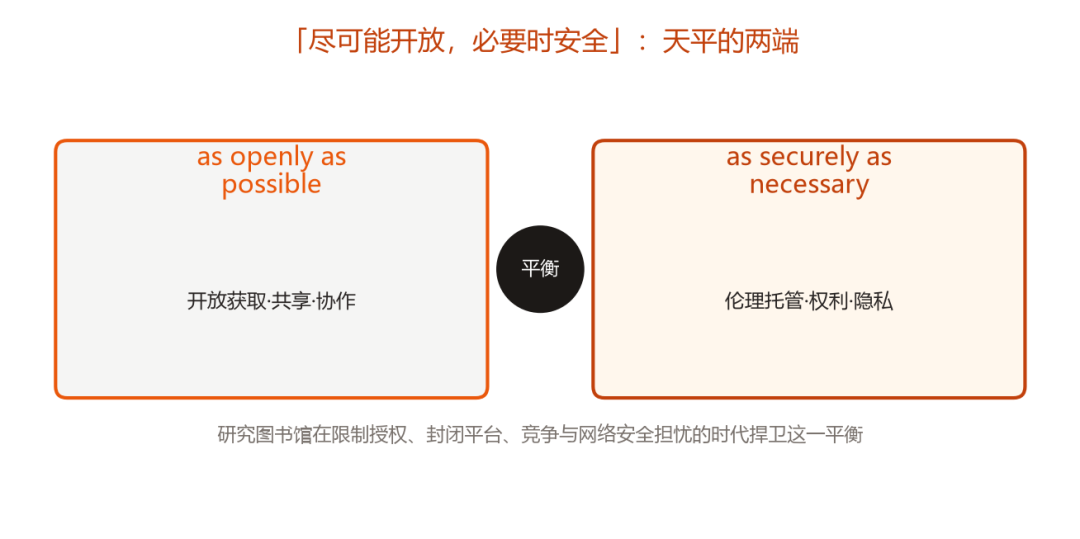
其四,开放不等于裸奔。 报告给出一个漂亮的对仗:「 we ensure that knowledge is shared as openly as possible and as securely as necessary 」——尽可能开放,必要时安全。在限制授权、封闭平台、竞争与网络安全担忧的时代,研究图书馆要捍卫的正是这条平衡线。
把四件事叠在一起,会得到一个让知识库团队坐不住的判断:用户的脚已经迈进了 AI,而我们的门还开着借书处。当发现入口与起步动作都外移到商业搜索与生成式工具,谁能把「可信馆藏」接进那条外部链路,谁才留得住下一代用户。
这四点的合力,指向一个结论:未来的知识竞争,不在谁模型大,而在谁手里握着可信、可追溯、可长期保存的源材料。
五、核心创新点:为什么它戳中了 RAG 与知识图谱的命门
站在 KG-LLM 与 RAG 的视角看,这份报告几乎是一份「机构级」的检索增强宣言,而且它点破了我们工程里最痛的三件事。
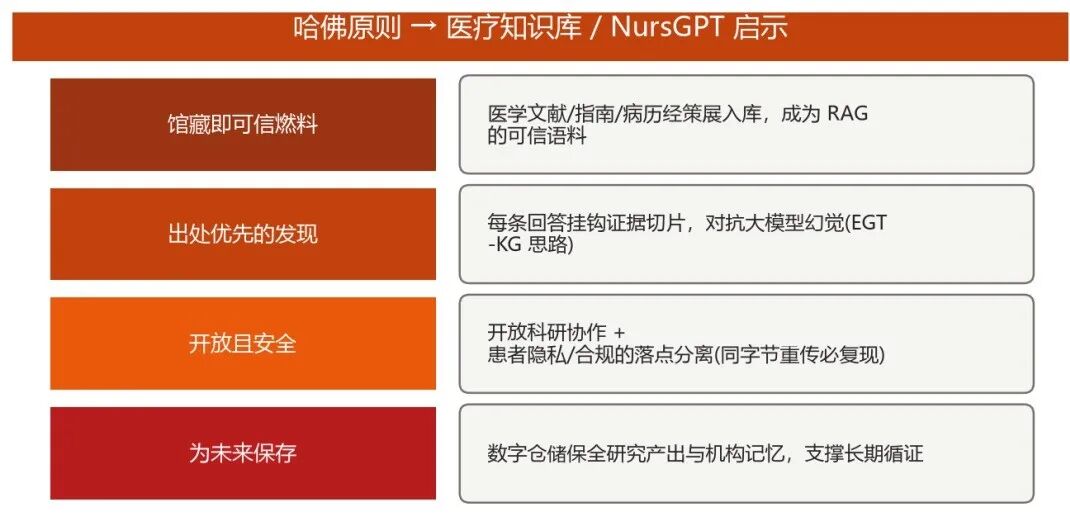
第一,出处( provenance )被抬到了价值观高度。 在「增强发现与参与」方向里,哈佛明确把 trust、provenance、accessibility、equitable access 列为数字生态的底座。provenance 这个词,正是我们今天对抗大模型幻觉的钥匙——每一条生成内容都要能钩回原始证据切片,否则就是无源之水。我们之前在 EGT-KG 里做的「证据锚驱动检索」,与这句话是同一个灵魂。
第二,馆藏即可信语料,等于给 RAG 划了质量红线。 很多 RAG 系统翻车,不是检索器不行,而是语料本身被污染、被断章取义。哈佛把「经策展的稀有独特资源」当作资产来经营,恰恰说明:好答案的上限,由入库知识的下限决定。
第三,开放与安全的双轨,正是医疗数据的现实困境。 「尽可能开放、必要时安全」放到医疗场景就是:科研协作要开放,患者隐私与合规要守住。这不是二选一,而是同一底座上的分层治理。
我把这条价值链画成了图:从可信馆藏,到出处标注,到检索增强,再到可信发现与创造——provenance 是中间那道抗幻觉的闸门。
再往深说一层。今天很多企业上 RAG,第一步就卡在「语料从哪来、干不干净」。哈佛把馆藏的「稀有与独特」当资产经营,等于提前回答了这个问题:可信语料不是爬来的,是策展来的。没有策展环节的 RAG,本质是拿噪声喂噪声。这也是为什么我们一直坚持知识图谱要先做实体与关系的归一与溯源,而不是把原文一股脑塞进向量库。
六、专家解读:从知识库工程看这份报告
如果把哈佛图书馆当成一家「全球最大的知识库公司」,它的 2026 战略其实回答了三个我们天天被问的问题。
问:知识库要不要自己下场做 AI? 哈佛的答案是「嵌进去,但别丢价值观」。它要做的是把 AI 用在馆藏的管理与连接上,同时由馆员帮师生在研究的全生命周期里用好 AI 工具。人和机器的关系,是燃料与引擎,不是替代。
问:怎么解决幻觉? 答案是回到 provenance。报告把「出处」和「信任」并列写进价值观,等于承认:没有可溯源的证据链,再顺滑的生成都不可信。这和柯基数据医药 Ontology Agent 、AI 医学图书馆的设计判断一致——每条回答必须挂着来源。
问:长期主义值不值得? 报告用整整一个方向讲「为未来保存」,把原生数字内容、机构记忆、大学档案都纳入托管。它看的是代际尺度:知识要「 passed forward for generations to come 」。做医疗知识库也一样,今天的结构化指南与病历,是明天循证研究的原料。
把这三点翻成工程语言,就是:知识库要做「价值观内置的 AI 中间层」——上游策展保真,中游 provenance 保链,下游权限保安全。哈佛用一份战略报告描述的角色,正是我们今天用图谱与本体在代码里实现的角色。
七、产业影响:这份报告会波及哪些赛道
别以为一份图书馆报告离产业很远。它的逻辑会顺着三条线外溢。
学术出版。 当图书馆把「最大化传播影响力」写进战略,传统付费墙模式会更被动。开放获取( OA )不再是道德姿势,而是知识底座的硬需求。出版方要么把可信内容以机器可配对的方式开放,要么被绕过。
医疗知识库与企业知识管理。 医院、药企、监管机构都在建自己的「知识中台」。哈佛的框架几乎可以直接平移:把指南、文献、病历当可信燃料策展入库;用 RAG + provenance 做抗幻觉问答;用分层权限做「开放且安全」。我们推进的柯基数据医药 Ontology Agent 与 AI 医学图书馆,走的正是这条路。
AI 基础设施厂商。 谁能帮机构把「藏、数、基、服」融成一个可追溯、可保存、可合规的生态,谁就握住了下一代入口。Palantir 式的本体工程、知识图谱平台,在这里找到的是真实买单方,而不只是 demo。
一句话:报告把「知识底座」从技术黑话,升级成了机构的生存命题。
落到国内,这份报告对高校图书馆、三甲医院的临床图书馆、药企医学部都该有震感。当哈佛把「馆藏即 AI 燃料」写进战略,我们还在把指南锁在 PDF 里、把病例困在孤岛系统里,差距不在模型,在有没有把知识当资产经营。
八、局限与争议:拥抱 AI 的代价
报告足够诚实,也把自己面临的张力写在了纸上,这反而让它更可信。
版权与许可。 报告承认,馆员正在应对「 AI 赋能工具的授权与权利问题」。馆藏要成为 AI 燃料,前提是授权允许。大量珍贵资源的许可并不清晰,这是燃料管道的硬堵塞。
闭源平台与竞争。 报告点名了「限制性授权体制、封闭平台、竞争」对开放性的挑战。当发现入口掌握在少数商业搜索引擎与闭源模型手里,图书馆的「开放」主张就会撞墙。
财务与政治。 报告不回避新的财务压力,也不回避政治极化与学术自由受质疑的环境。在预算收紧时,数字计划扩容与实体馆藏保全如何取舍,是没有标准答案的难题。
人的位置。 「人机协同」说起来轻盈,落到编制与培训上很重。报告把「人(馆员与档案员)」放在发现的核心,但转型需要持续的能力投入,这恰是最容易被砍的一块。
把这些摆出来,不是泼冷水,而是提醒:知识底座的仗,技术只是最小的一部分。
对医疗知识库而言,这几条几乎是一一对应的红灯:病历与指南的授权边界、商业模型对数据的吞并、合规与预算的双重挤压,以及「人」在降本潮里最先被砍。哈佛把张力写进战略,是逼自己直面;我们把它写进风险清单,是少走弯路。
九、未来方向:born-digital 与全球知识公地
报告在「为未来保存」里埋了最长远的一笔:今天爆炸式增长的是原生数字内容( born-digital )——它们没有纸质母本,一旦格式过时或平台关停,就可能永久消失。哈佛靠 ReCAP 合作与现代数字仓储服务来兜底,但报告也坦白:没有哪个机构能独自抵御网络、地缘与环境风险。
所以它呼吁加入协作网络,提升「我们共同依赖的全球知识公地」的韧性。这和知识图谱社区的共识同构——单点本体撑不起全局智能,跨机构、跨语言的互联本体才是未来。
对医疗场景尤其如此。一份罕见病的真实世界证据,可能散落在论文、病历、审评报告与患者社区里,只有把它们用统一本体连起来, AI 才看得清全貌。哈佛说的「全球知识公地韧性」,落到医疗就是「跨机构循证网络」——这正是柯基数据医药 Ontology Agent 想接的那张网。
另一条暗线是数据治理。报告说,连图书馆的采购记录这类行政数据,都成了数据密集型研究的燃料;信息政策在其工作核心,图书馆是大学数据治理战略的积极伙伴。由此看,知识库天然就是治理载体,不是治理的对象。
十、同类对比:谁在为「AI 时代的知识底座」背书
把视野拉开,哈佛不是孤例,但它把话说得最体系化。横向看几家:
| 机构/倡议 |
关注点 |
与哈佛的异同 |
| Europeana |
欧洲文化遗产数字开放 |
同:开放获取;异:偏文化遗产,弱 AI 嵌入 |
| NIH 开放科学 |
生物医学研究数据开放 |
同:科研数据开放;异:偏科研产出,弱策展价值观 |
| 高校图书馆联盟 |
联合采购与保存 |
同:协作保存;异:少把 AI 列为头号变量 |
| 哈佛图书馆 2026 |
馆藏即 AI 可信燃料 |
独:把 provenance 抬到价值观、把 AI 写进三大方向 |
差异不在于「要不要开放」,而在于谁能把开放、可信、保存、AI 四件事缝成一套自洽的战略。目前看,哈佛这份报告是最完整的一版。
十一、结尾:在恒动的世界里,守住那盏灯
报告收尾一节叫「 The Road Ahead 」。它承认新技术、新学术形态、新社会政治现实会持续重塑知识的创造与保存,但落点很轻也很重:
「在一个恒动的世界里,图书馆依然是一个地方——好奇心在此被滋养,历史在此被保护,声音被邀入对话,知识被代代相传。」
这句话,其实是对所有做知识库、做 AI、做医疗智能的人说的。模型会换,框架会改,入口会移,但人对可信知识的依赖不会变。我们写代码、建图谱、训模型,终极目的不是让机器更会聊,而是让下一个人、下一代研究者,能站在一份被好好保存、好好溯源、好好开放的知识之上,往前走一步。
哈佛用一份 10 页的安静报告提醒行业:AI 时代的地基,不是参数,是被信任的知识。把这件事做扎实,比追任何一个热点都更长久。
所以别只把这份报告当新闻。它是一份给知识工程者的备忘:少追参数,多守出处;少囤孤岛,多建公地;少做一次性 demo,多想代际尺度。把地基打在可信知识上,热点会过去,价值留下来。
 发表于 昨天 21:23
|
查看: 5|
回复: 0


