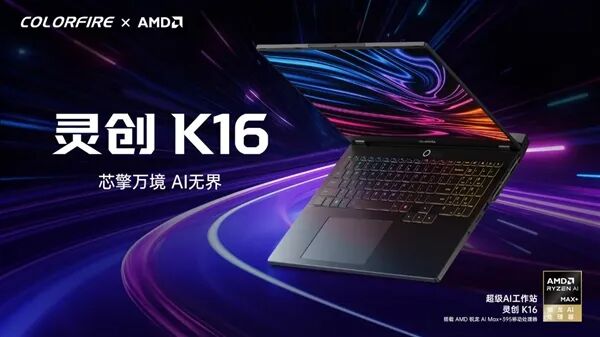
四万块买台核显本,装机玩家第一反应多半是“这钱是不是被大风刮走的”?七彩虹COLORFIRE灵创K16新出的顶配版本,128GB内存加4TB SSD,国补后报价38499元。花这个数的意义到底在哪?说白了,就是把大容量统一内存和本地AI环境一起塞进包里带走。模型装得下、回答等得起、现场用得上,这笔投入才算没白花。
这次先给模型仓库扩建
顶配版把SSD从2TB扩到4TB,而锐龙AI Max+ 395处理器和128GB内存都是原有配置,计算平台本身没有换代。
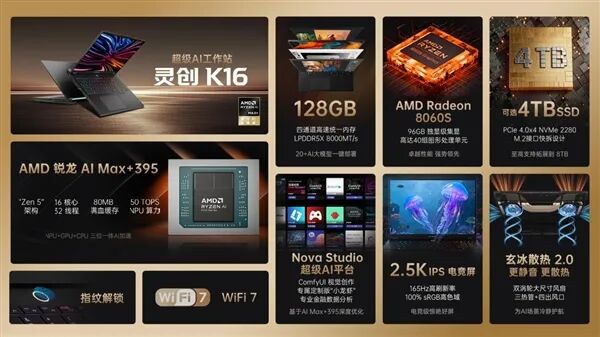
4TB负责长期保存模型权重、绘图素材和工程文件,内存负责运行时的工作空间。多出来的2TB能多留几份模型和量化版本,少对着旧文件喊“退退退”。但硬盘扩容本身并不会让生成速度翻倍,这点得先摆正预期。
128GB内存、96GB显存、4TB硬盘摆在一起,确实容易看得人“猪脑过载”。理清硬盘之后,再看这96GB就简单了。
K16的128GB LPDDR5X-8000由CPU与GPU共享,最高可划出96GB供图形使用,这96GB包含在128GB之内。系统和应用同样要占用这池内存。
独显的专用显存与系统内存是分开的;而395的大内存池,则让更多模型权重有机会留在GPU可访问的空间里。它的256位接口配合8000MT/s速率,理论带宽为256GB/s,由CPU与GPU共享。容量管装多少,带宽管搬多快——生成文字时反复读取权重,走的就是这条通道。
395集成的16核32线程Zen 5 CPU能处理文档、运行开发工具并参与推理;40个计算单元的Radeon 8060S核显,可在适配软件中承担模型和绘图运算。XDNA 2 NPU需要专门适配,50 TOPS只是它的峰值算力。判断整机AI速度,还得看软件调用哪个单元、精度与带宽。
千亿模型也得挑吃法
一个1000亿参数的模型,按每个参数16位精度保存,纯权重就要200GB左右;压到4位量化,理想值约50GB。量化减少了数值精度,但运行时还需要额外空间——KV缓存保存已处理的上下文信息,对话越长、资料越多,占用也会随之增长。
早期128GB+2TB版K16已有通过Nova Studio运行Qwen3.5-122B的记录。速度方面,可以参考AMD另一组395平台的测试。
该测试使用128GB内存,给GPU分配64GB,搭配Ubuntu 24.04、ROCm 7.2.1和Ollama 0.20.x。Q4_K_M量化的Qwen3.5-122B-A10B文件约76GB,以61% GPU、39% CPU混合加载,短提示测试中生成约8.59 token/s。
这款模型属于MoE混合专家模型,总参数1220亿,每个token激活约100亿参数。装载容量要看总量,计算量与激活部分挂钩。
按这个速度,生成1000个token接近两分钟,还没算输入处理的时间。token是文本切分单位,不等于一个汉字。如果你的日常是催稿催到“我没有时间了”,较小模型往往更适合连续追问。
装满硬盘还得跑通流程
有了存放和运行模型的空间,下一步就是让现有的工作真正搬过去。
K16配套Nova Studio管理应用与模型,预置ComfyUI工作流,减少搭环境的步骤;ROCm提供AMD GPU计算支持。ComfyUI在Windows下也已有ROCm支持,但迁移项目仍要匹配驱动、PyTorch和自定义节点依赖,专门依赖CUDA的扩展需要找到AMD可用的实现。
硬盘可以搬家,插件未必拎包入住。
去客户现场处理不便上传的资料,或在网络不稳定的拍摄地生成参考图,离线运行的价值就体现出来了。提前下载模型、插件和知识库资源,断网也能跑通完整流程;不过,调用云端API的节点仍然需要网络。
报道给出的最高160W性能释放是功耗指标。持续推理受供电模式、散热和环境温度影响,长任务宜接适配器并保证风口通畅。99Wh电池方便移动使用,高负载下的续航要另外考虑。
经常带大模型外出、资料需要本地处理,128GB加4TB才容易发挥价值。固定办公更能用上桌面工作站的扩展与散热空间;偶尔使用且资料允许上传,云端能省掉本地维护。只为偶尔问几句话就买它,钱包承担的任务比电脑还重。
带AI出门,你更需要离线查资料、现场出图,还是跑大模型调代码?哪种工作值得你背上K16?
 发表于 昨天 23:25
|
查看: 5|
回复: 0


