你让 Claude 读了一摞文章和 PDF,它勤快地产出十几条笔记。三周后你想引用某条结论,回头一翻:出处是哪篇文章?哪一页?聊天记录早被冲没了。更糟的是笔记本身——存在某个 SaaS 的数据库里,导出格式残缺,想搬家时才发现钥匙根本不在自己手上。
AI 笔记这条赛道工具层出不穷,但三个死结很少被同时认真对待:摘要活了下来,证据死了;数据是你的,也是工具的;记了不少,从不复利。
claude-obsidian 把这三个死结当成架构问题来解。它本质上是 Claude Code 插件,再加一套可移植的 Agent Skills,把 Obsidian vault 变成一个带台账、带引用、可检索的知识库。设计蓝本来自 Andrej Karpathy 的 LLM Wiki 模式。项目 2026 年 4 月开源,不到五个月就拿下 13.8k star,当前版本 v2.1.1,MIT 协议。
项目卡片
- 项目:claude-obsidian[1]
- 状态:13.8k star / 1.4k fork,v2.1.1(2026-08-25),创建不到 5 个月
- 一句话判断:少数把"可信"当架构做而不是当口号喊的 AI 笔记系统——代价是仪式感很重
摘要活下来了,证据不能死
大多数 AI 笔记流程走到"保存文本"就停了。claude-obsidian 的第一步反着来:先把来源钉死,再谈总结。
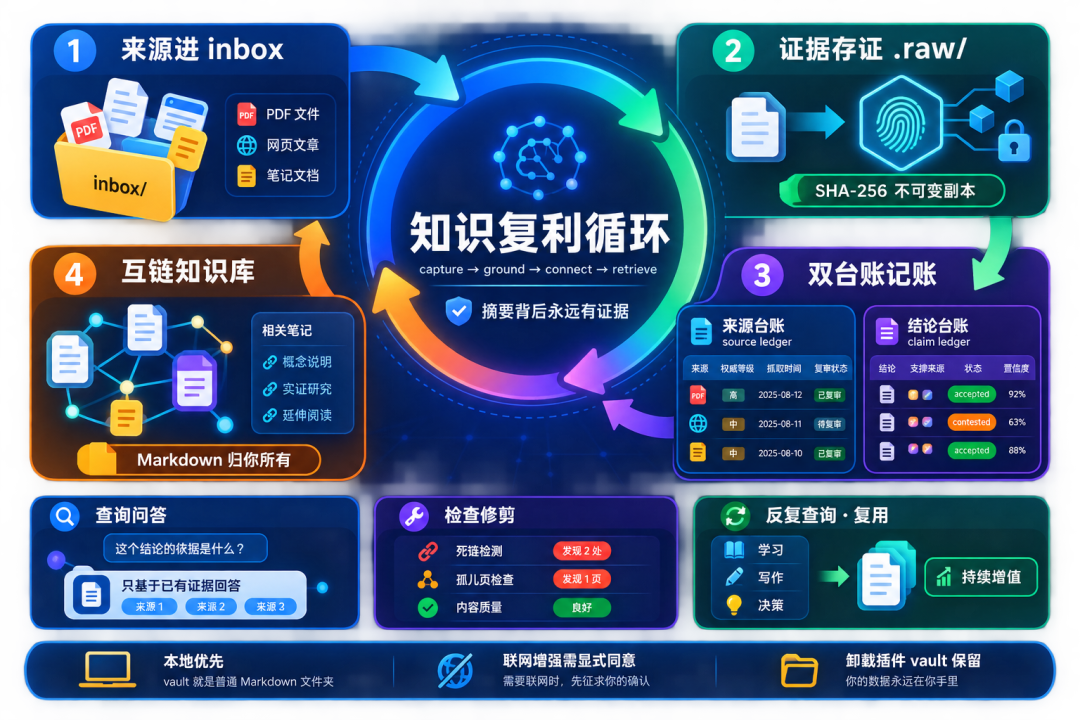
往 vault 的 inbox/ 丢一个文件,ingest 时它会先做一份内容寻址的不可变副本(SHA-256 定位),存在 .raw/ 里,之后永远不会被替换。也就是说,哪怕笔记被改得面目全非,原始证据还在原地。
在这之上是两本账。source ledger 记每个来源的权威等级、抓取时间、复审状态;claim ledger 记每条可证伪的结论——由哪些来源支撑、有没有矛盾证据、当前是 accepted、provisional 还是 contested。矛盾和来源谱系都保留在账本里,系统不会悄悄替读者选边。
最见态度的是规则本身:高风险结论必须有两个相互独立的来源才能标 accepted;证据不足时宁可明确拒答,也不编一个引用出来。我看这类项目有个习惯,先看它怎么处理"证据不足",再看它宣传了多少功能——这个细节比任何首页口号都能说明品性。
笔记是你的,还是工具的
第二个死结:数据归属。claude-obsidian 的答案朴素到近乎无聊——vault 就是一个普通目录,全是 Markdown、JSON 和源文件。不藏在插件缓存里,不锁在云数据库里,也不会被默默上传给模型。
几个细节能看出这不是口号。卸载插件、删掉宿主链接,vault 原封不动;inbox/ 里的文件核心只能"建议删除",永远不会代你执行;联网(远程 embedding、上下文前缀这类增强)是单独的显式决定,你不点头,检索就退回本地确定性的 BM25。
对已经是 Obsidian 用户的人来说,这一点尤其重要:adopt 流程可以把现有 vault 非破坏性地接进来,不用迁移、不用搬家。
记了不复利,等于没记
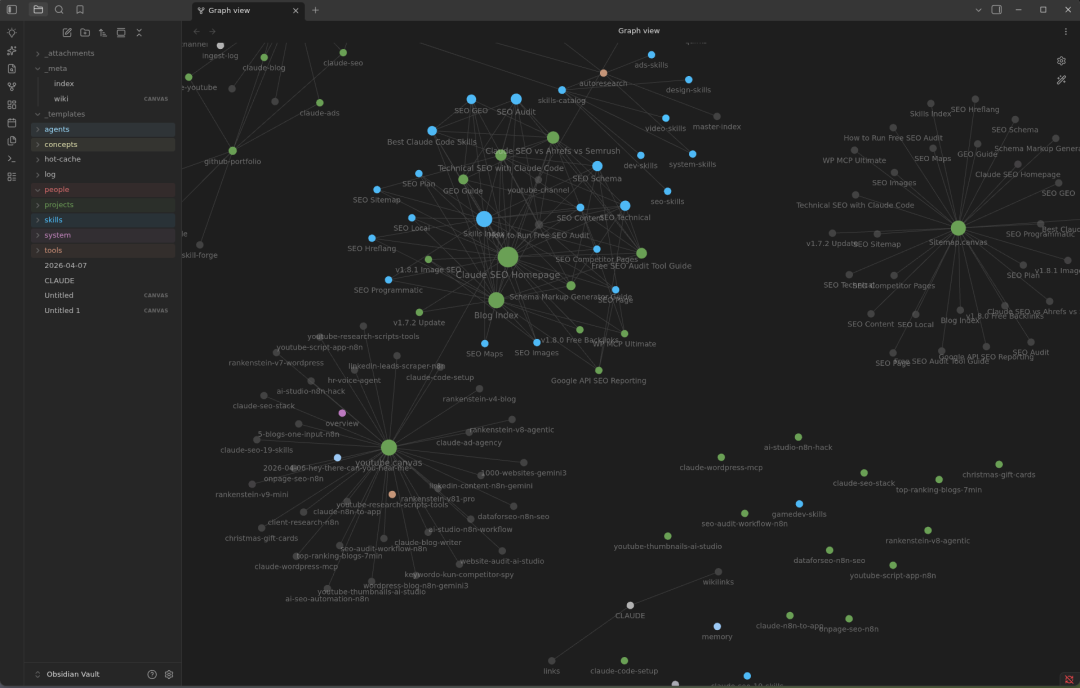
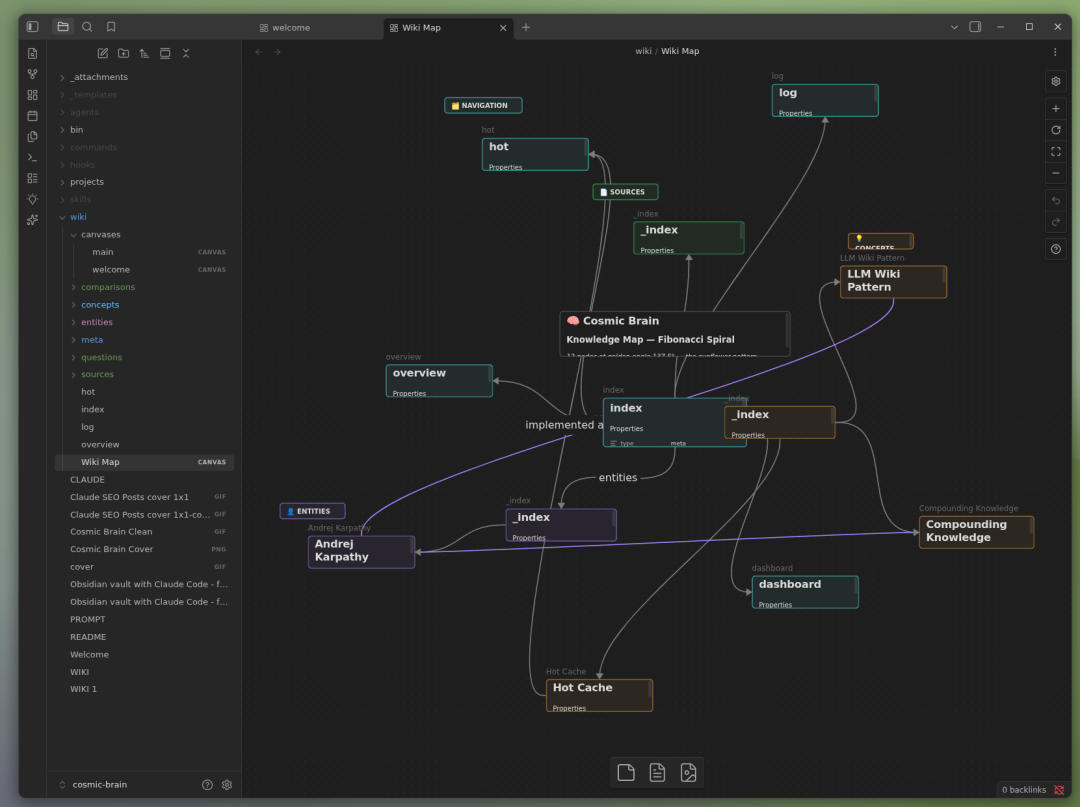
第三个死结最隐蔽:笔记工具用了一年,每次对话还是从零开始。claude-obsidian 把"用回来"做成了显式环节——ingest 入库之后,wiki-query 只从 vault 里已有的证据回答问题,wiki-lint 定期揪出死链、孤儿页、过期索引,wiki-fold 把操作日志压缩成可追溯的摘要。知识不是一条条孤立的笔记,而是一张会被反复查询、修剪的图。
15 个 skills 各管一段,但共享同一套证据模型和事务规则。组织方式还能选:默认 Generic,也支持 LYT、PARA、Zettelkasten 四种笔记法路由新页面——切换只影响新笔记怎么归档,不会偷偷重排你的旧知识。
上手路径:先看计划,再动手
流程走一遍比想象中直白,但有两个刻意的减速带。
先克隆仓库——注意它是"产品",不是你的知识库。然后初始化一个独立的 vault,init 默认只输出操作计划,审阅后再带计划哈希落盘:
# 第一步:只看计划,不写任何文件
python3 scripts/claude-obsidian.py init ~/Documents/MyVault \
  --generated-at "$GENERATED_AT" --operation-id init-reviewed
# 第二步:审阅改动路径后,带上计划里的 approved_plan_sha256 真正落盘
python3 scripts/claude-obsidian.py init ~/Documents/MyVault \
  --generated-at "$GENERATED_AT" --operation-id init-reviewed \
  --approved-plan-sha256 <计划输出的哈希> --apply
想接入现有 vault,把 init 换成 adopt,同样是非破坏性流程。
vault 建好后,在 Obsidian 里打开它,从这个目录启动 Claude Code,输入 /claude-obsidian:wiki 进入模式。之后的日常就三拍:源文件丢进 inbox/,/claude-obsidian:wiki-ingest 入库,/claude-obsidian:wiki-query 提问,好答案用 /claude-obsidian:save 显式落盘——它不会自动把整段对话转成笔记。如果是我上手,我会先拿几个不再需要的旧 PDF 试完整链路,确认账本和引用长什么样,再决定放不放正经资料进去。
不只是 Claude Code 能用:Codex、OpenCode、Gemini 走 setup-multi-agent.sh 链接技能目录,Cursor 和 Windsurf 用工作区发现。环境要求 Python 3.11 以上,Obsidian 只是可视化层,纯 Markdown 一样可用。
减速带的代价要说清楚:每次写操作都是"计划 → 审哈希 → 应用"的仪式,并行 agent 只交草稿、由单一编排者打包成一个可回滚的事务统一落盘。换来的是改坏了能恢复、并发不互踩、目标文件被外部改动时拒绝静默覆盖。嫌麻烦的人会觉得繁文缛节,在乎数据完整性的人会觉得这才是对的样子。
边界在哪
README 里有一张少见的"诚实能力边界"表,直接抄几条:PDF 和 EPUB 只取元数据、哈希和大小,没有内置语义提取;URL 和 YouTube 抓取需要你自己配置外部 runner;OCR 同理;所有远程模型增强都要显式同意出口流量。看到这张表,我对项目的好感是往上走的——愿意认真写"做不到什么"的项目,比只写"能做什么"的少得多。
平台方面,原生 Windows 只支持只读检查和 dry-run,写 vault 必须进 WSL,否则直接报 UNSUPPORTED_PLATFORM 拒绝。另外贡献者名单只有 3 人,属于单一维护者主导的高速项目——一个月内从 v2.0.0 连发到 v2.1.1,活跃是活跃,bus factor 低也是事实。
还有一句自我划界值得原样复述:它不是自动转录记录器,不是云同步服务,不是事实神谕,也不能替代备份和版本控制。
所以价值判断可以这样下:如果你已经活在 Claude Code(或同类 agent 宿主)里,在乎笔记的出处和数据归属,愿意用一点仪式感换一份"敢引用"的知识库,claude-obsidian 是目前这个方向上工程化最完整的一份实现。如果你想要的是开箱即用、多端云同步的托管第二大脑,它是反向答案——而这份"反向",恰恰是它值得被关注的原因。
引用链接
[1] claude-obsidian: https://github.com/AgriciDaniel/claude-obsidian
 发表于 前天 00:49
|
查看: 1|
回复: 0


