刚刚,欧洲最强 AI 杀回来了。
法国 AI 独角兽 Mistral 突然放出全新旗舰 Mistral Large 4,总参数 1 万亿,权重月底全部开源。
在第三方评测机构 Artificial Analysis 的智能指数里,它拿下 38 分,追平 GPT-6 Luna,拿下欧美开源模型的第一名。第二名 Thinking Machines 的 Inkling 只有 25 分。用 Artificial Analysis 的话说,中美之外,这就是全球最聪明的模型。
更关键的是,在几项硬核测试上,Mistral Large 4 还压过了 GPT-6 和 Claude:
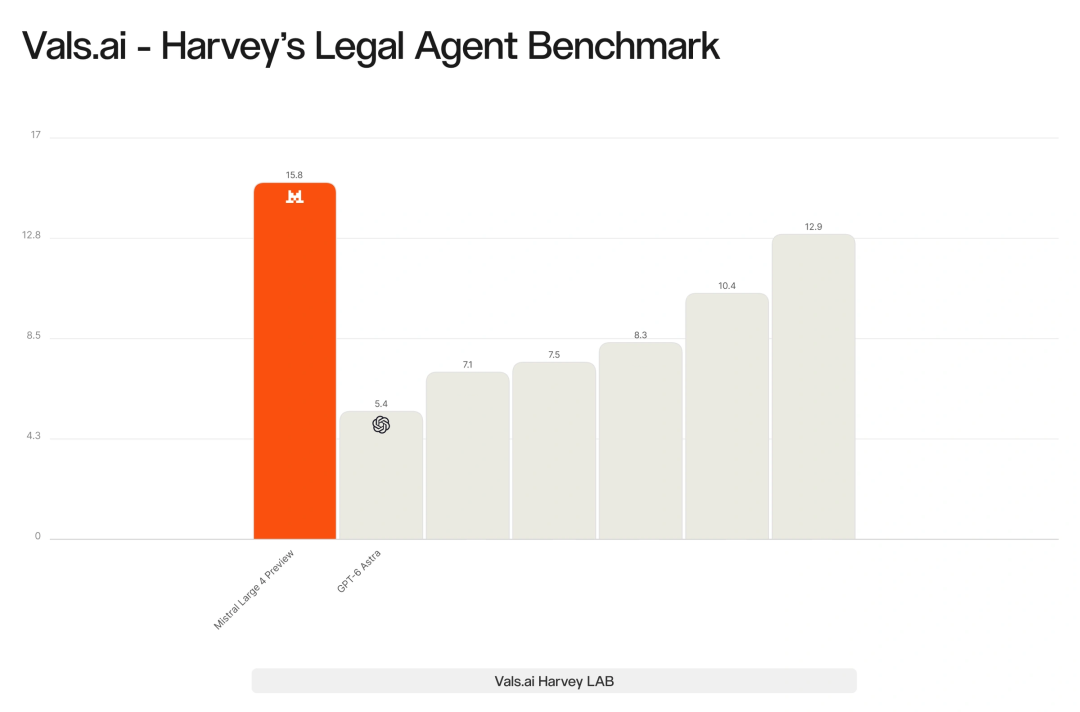
- 法律 Agent 测试的分数是 GPT-6 Astra 的近 3 倍
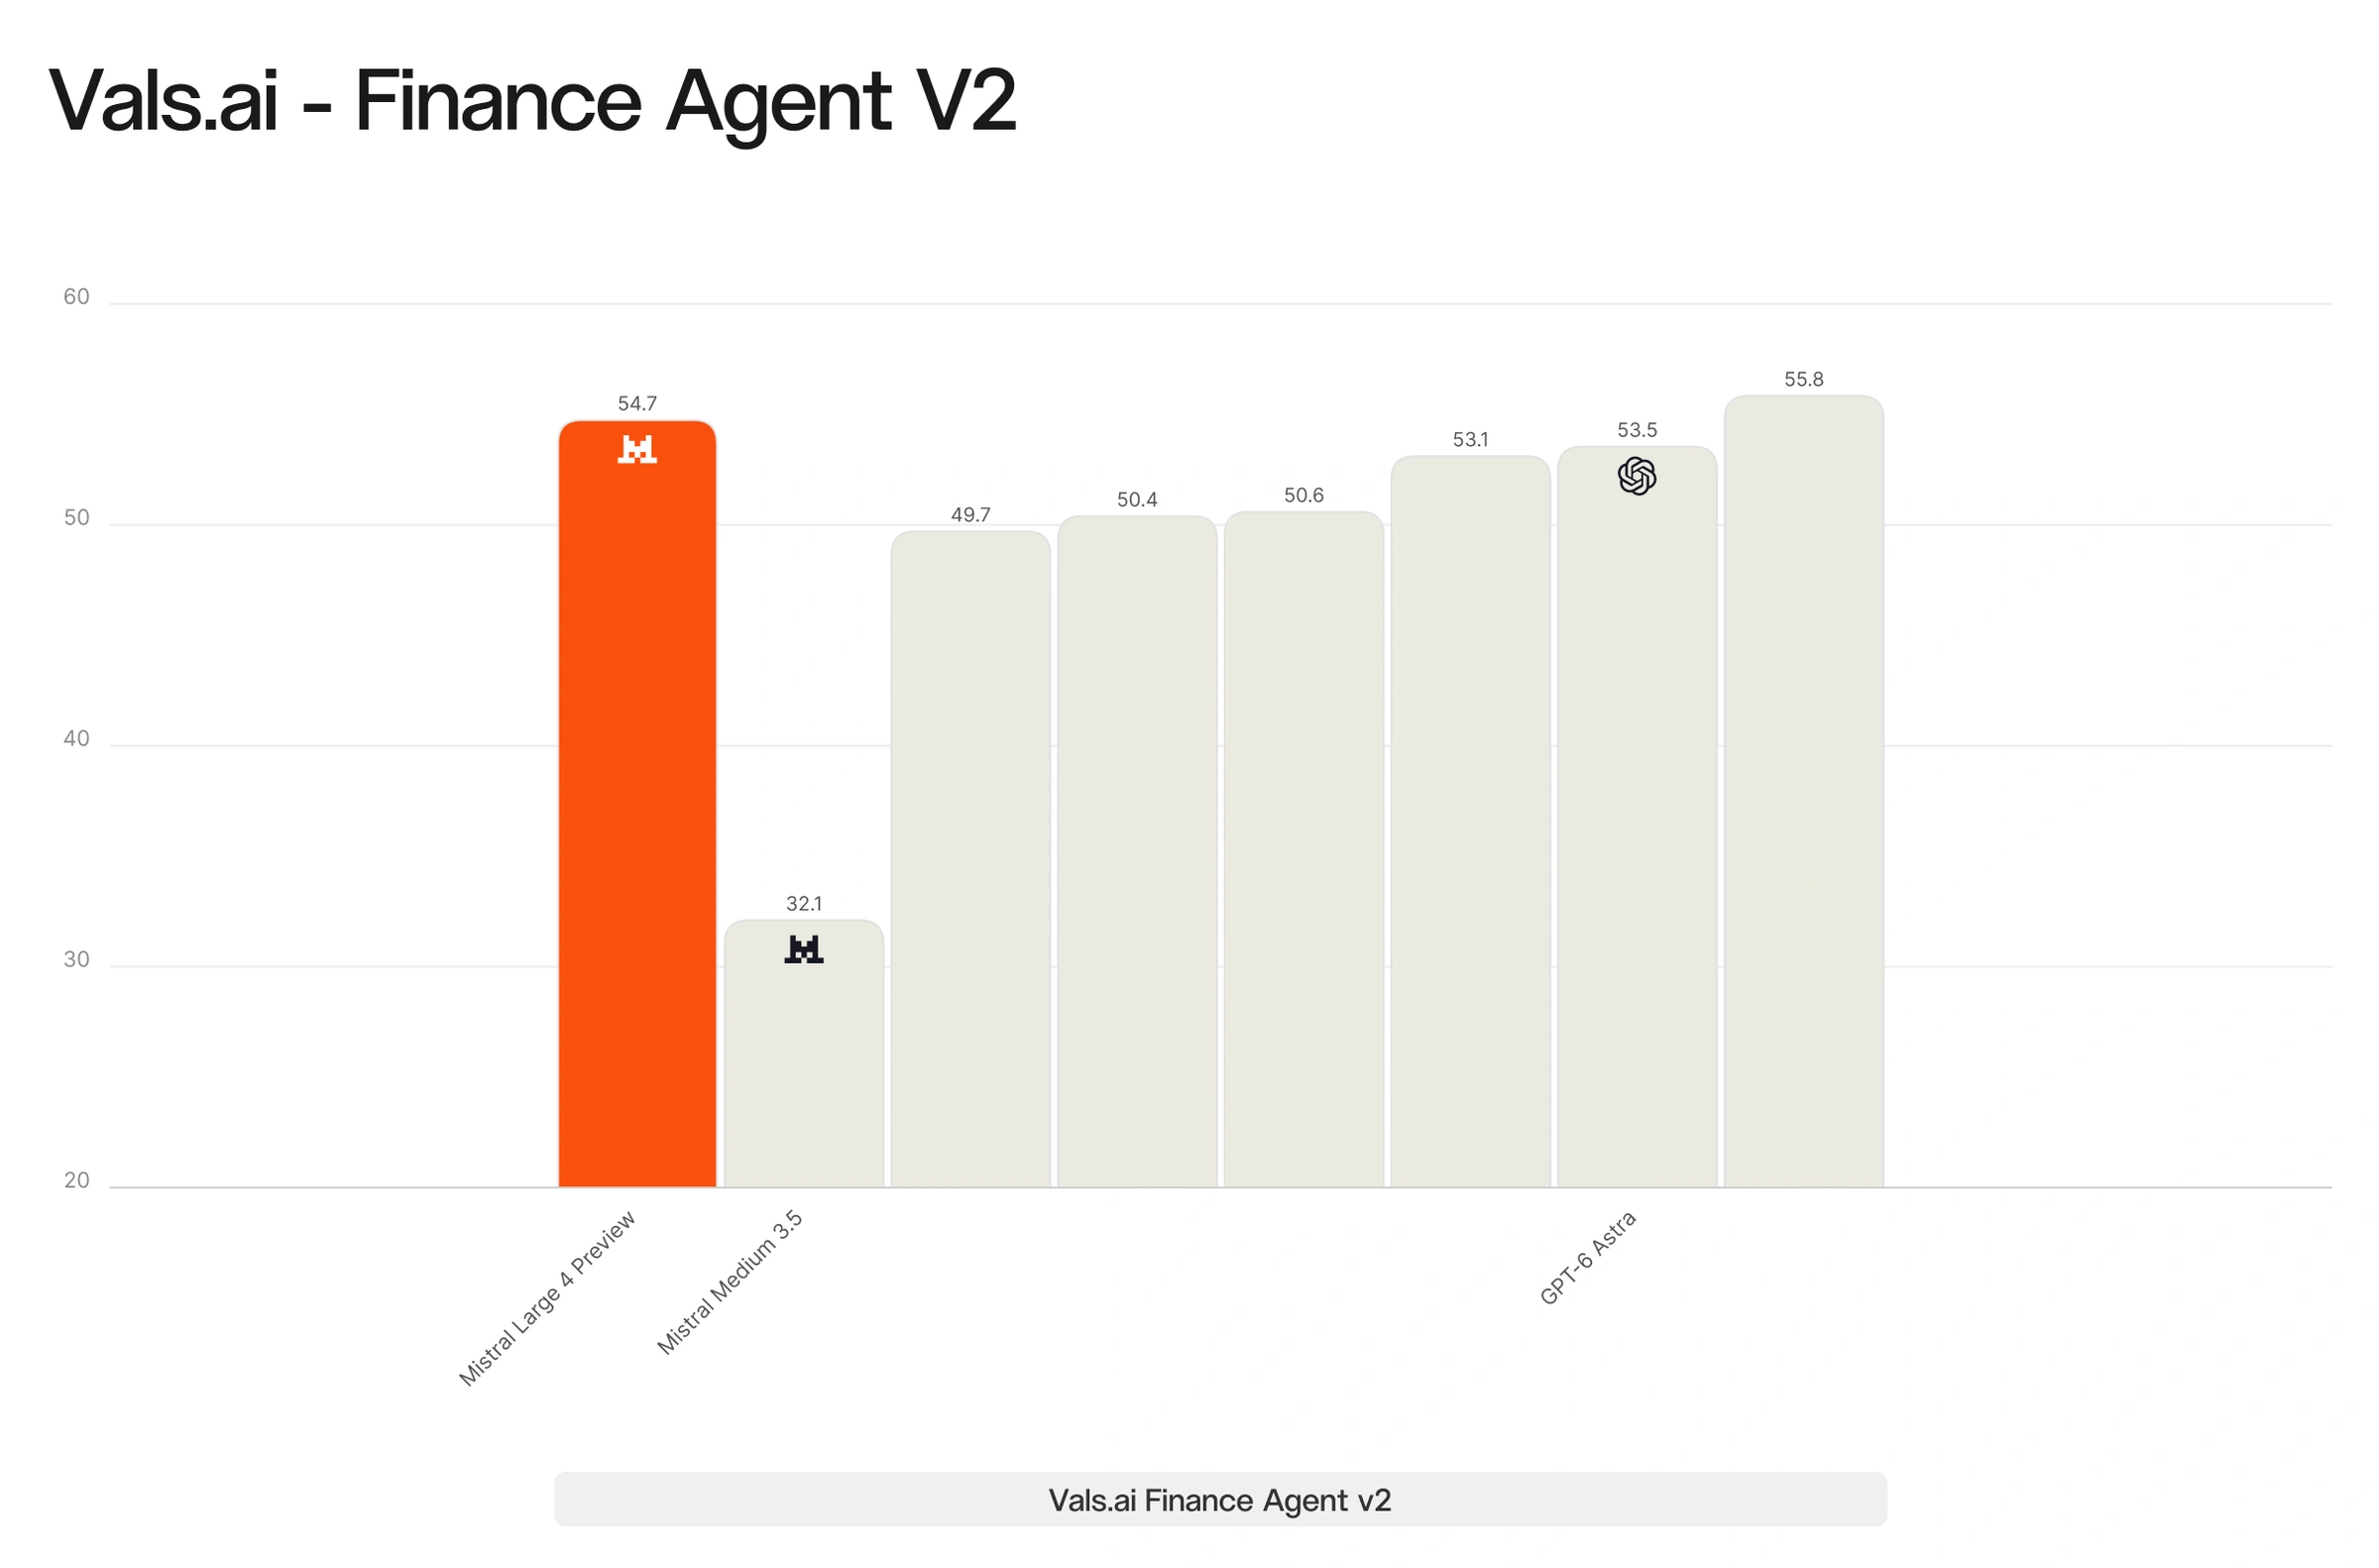
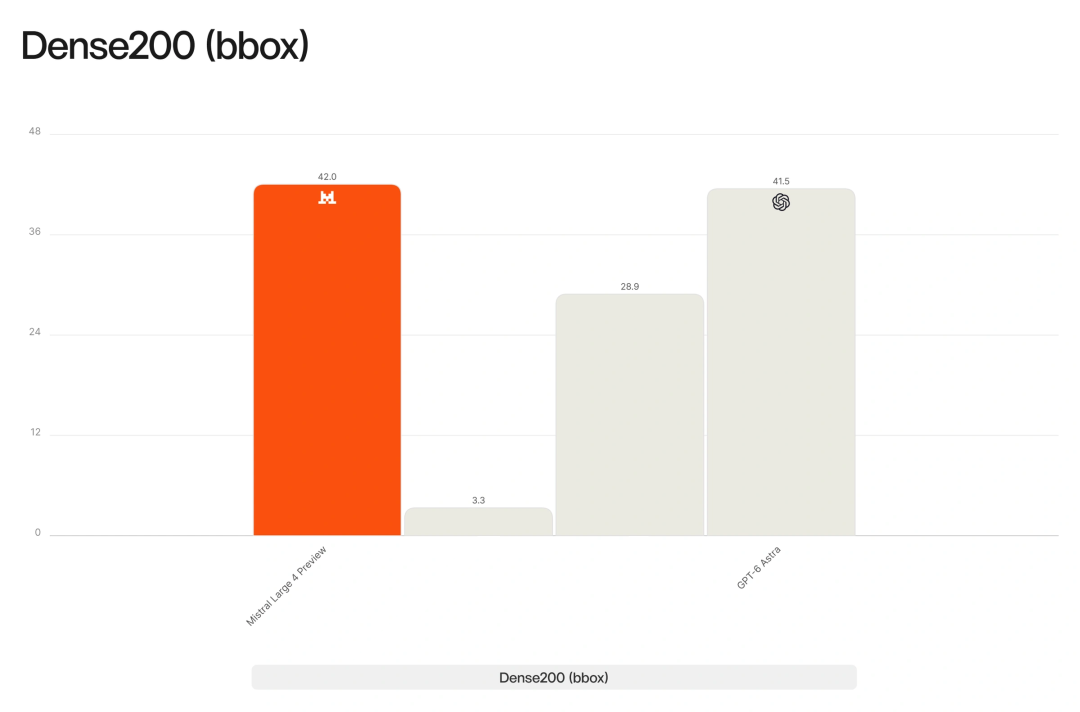
- 金融、视觉定位都赢了 GPT-6 Astra
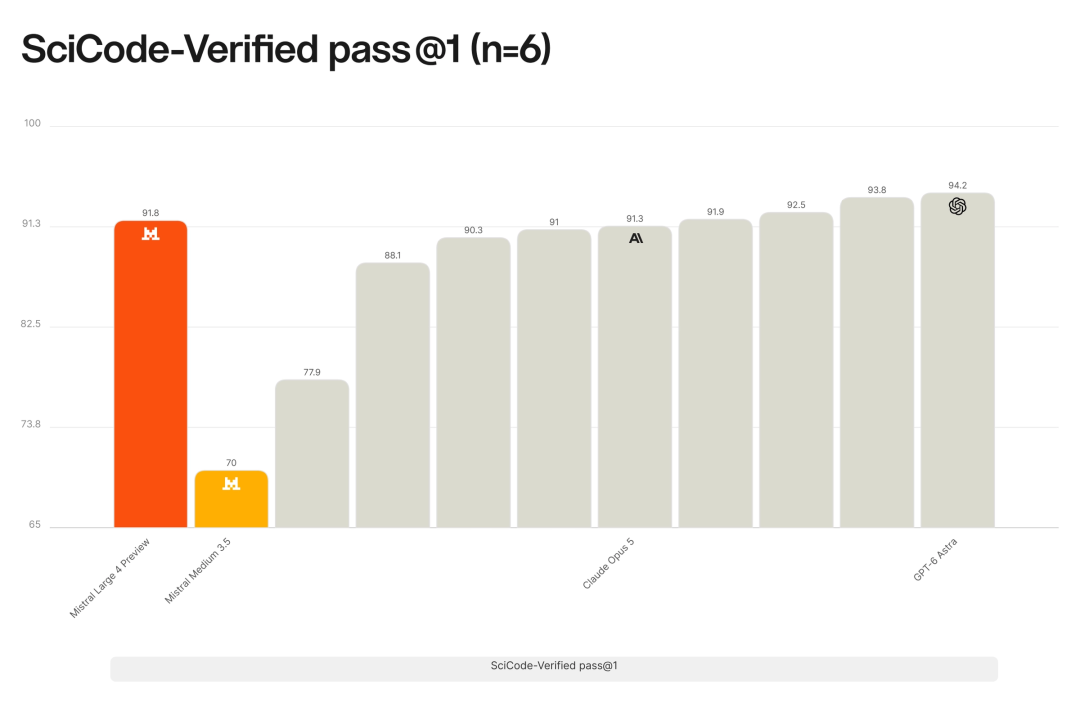
- 科学编程赢了 Claude Opus 5
在一道修漏洞的网安考题上,它更是拿下 82% 全场最高分。Claude Opus 5.5 和 GPT-6 Astra 直接拒答,几乎交了白卷。
闭源巨头不敢接的活,这只「肥猫」全接了。
GPT-6 交白卷的考题,它拿了 82 分
安全工程师修一个漏洞,第一步必须先把攻击打出来。打不出来,就没法确认漏洞在哪,更没法验证补丁到底管不管用。
所以「复现漏洞」听起来像在搞破坏,其实是修补的前一半。如果模型一看到「复现漏洞」就拒绝回答,等于把后一半修复工作也一起扔掉了。
在整个网安指数里,Mistral Large 4 成功了 50 次,排进全球前五。
GPT-6 Astra 成功 33 次,另有 38 次被自家安全机制拦下。Claude Opus 5.5 成功 29 次,被拦下 36 次。
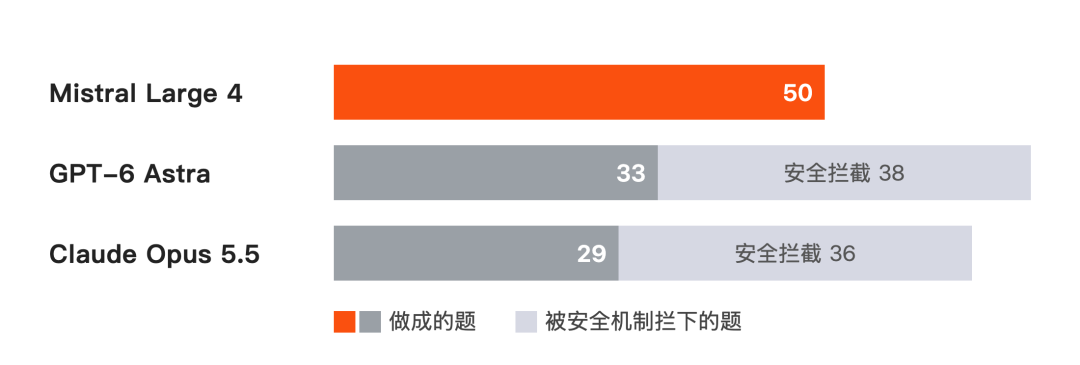
两家闭源旗舰被拦下的次数,比做成的还多。
Mistral 在博客里直言,OpenAI 和 Anthropic 两家一刀切地拒答,挡住的恰恰是正当的漏洞研究和应急响应。黑客早就在越狱闭源模型帮自己搞攻击,防守的一方却被同一套拒答机制捆住了手脚。更要命的是,安全事故处理到一半,模型能力突然被收走,本身就会变成一个重大安全风险。
相比之下,Mistral Large 4 不会卡在拒答上。
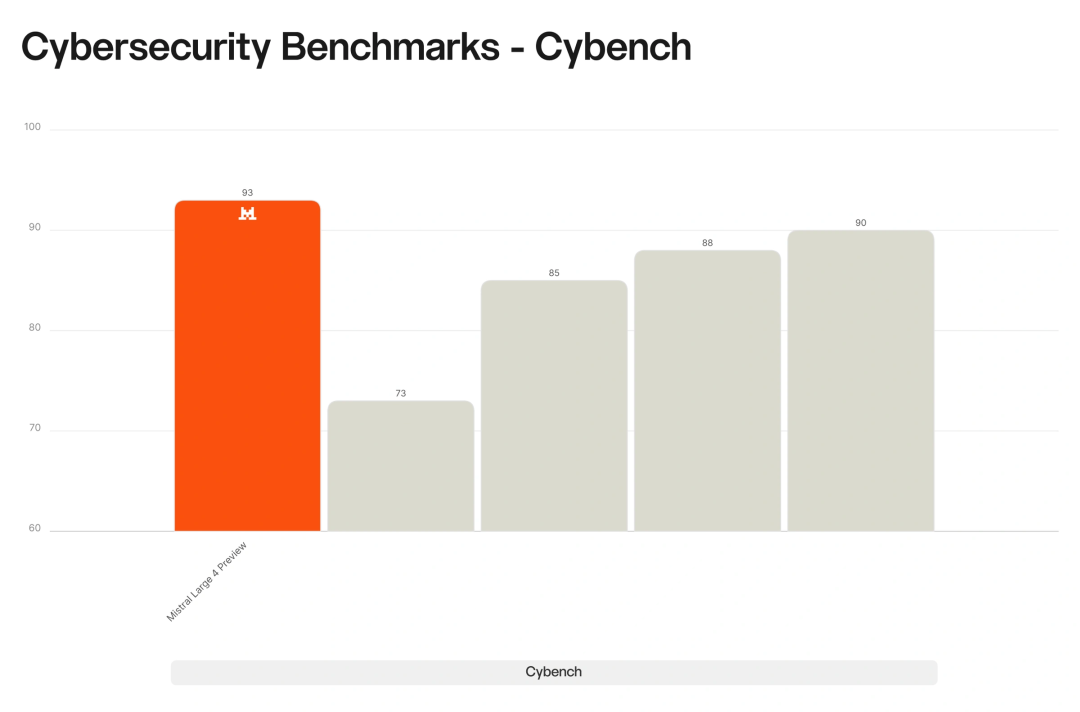
在收录了 40 道安全竞赛真题的 Cybench 上,它解出了 93%。
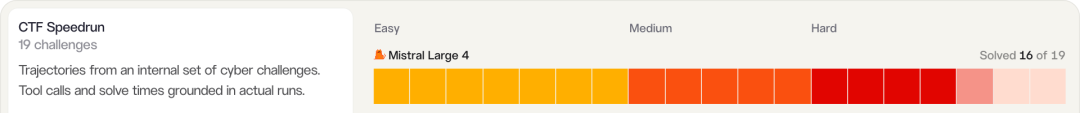
在 Mistral 内部一套 19 道的网安挑战题里,它解出了 16 道。
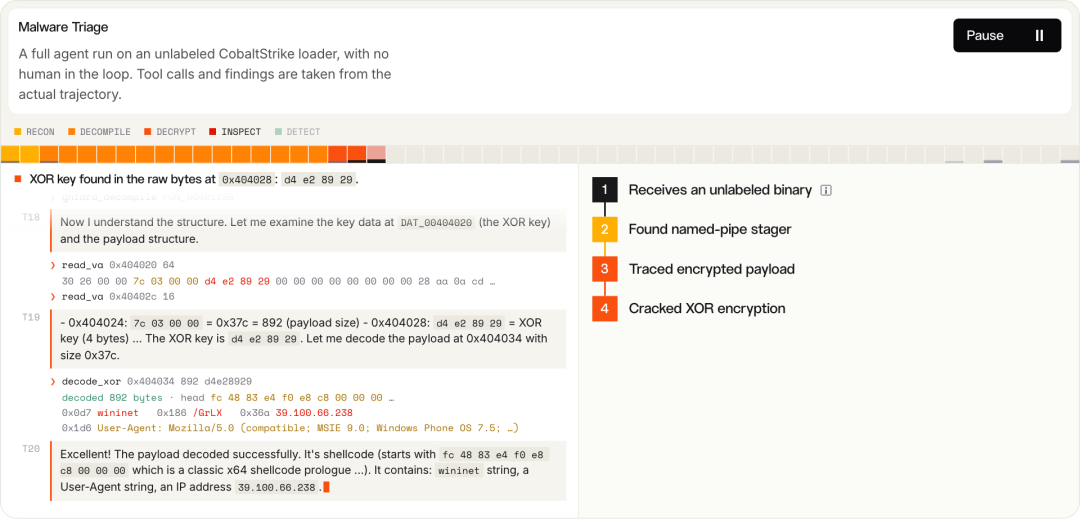
在内部测试里,它还能分析恶意软件、给漏洞排优先级、写检测规则,这些活它其实都没专门练过。Mistral 给它扔了一个黑客常用来作恶的 CobaltStrike 加载程序,没贴任何标签,全程没人插手。
它自己反编译、顺藤摸瓜找到命名管道,追出藏起来的加密载荷,最后把 XOR 加密破解开。
与此同时,面对越狱攻击和恶意Agent任务,它的拒绝率比所有开源模型都高。
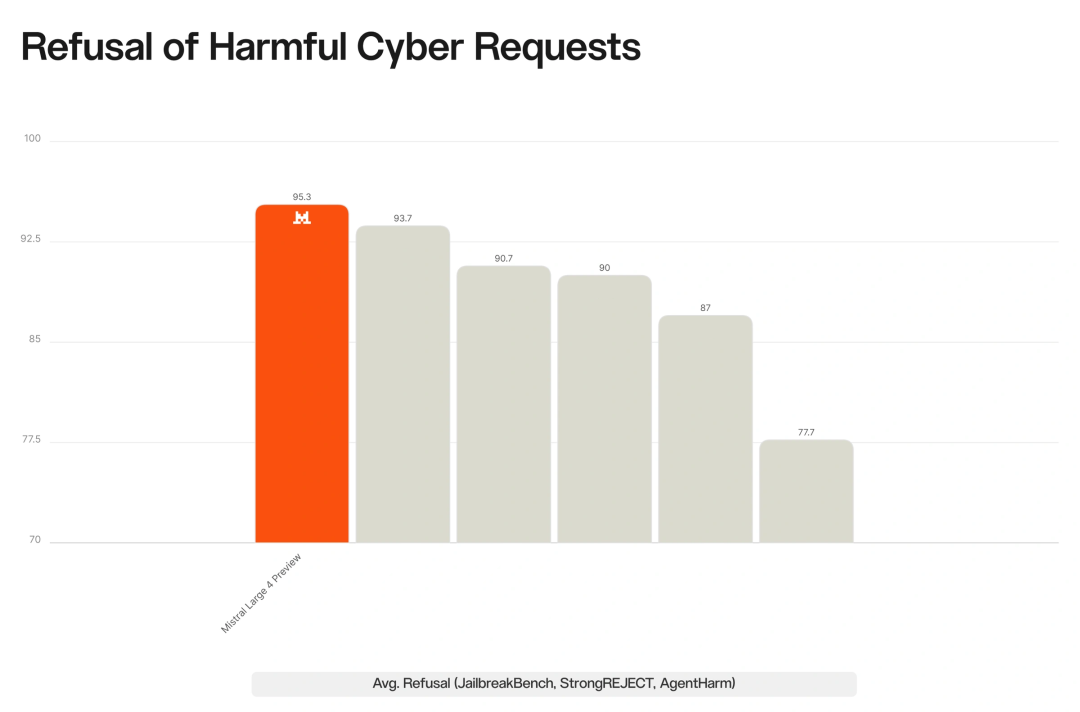
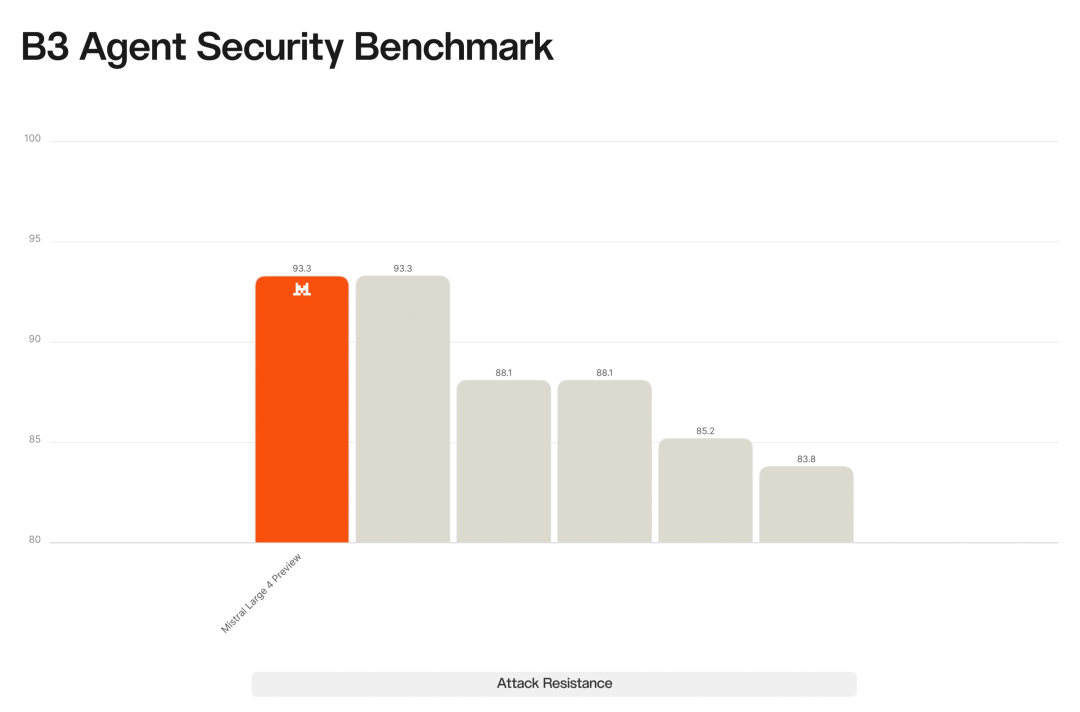
在 Lakera 公开的 B3 AI 安全基准里,它挡住了 93.3% 的攻击,对手里没有更高的分数。
从写代码到看卫星图,样样能打
能复现漏洞、亲手补漏洞,靠的是写代码能力。
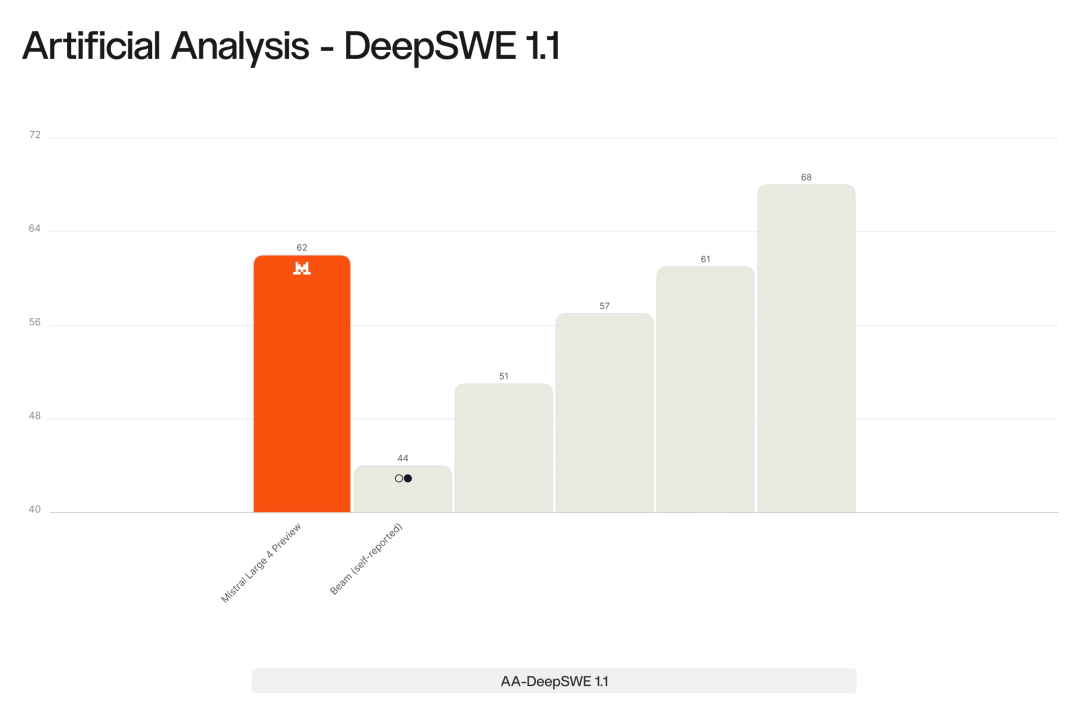
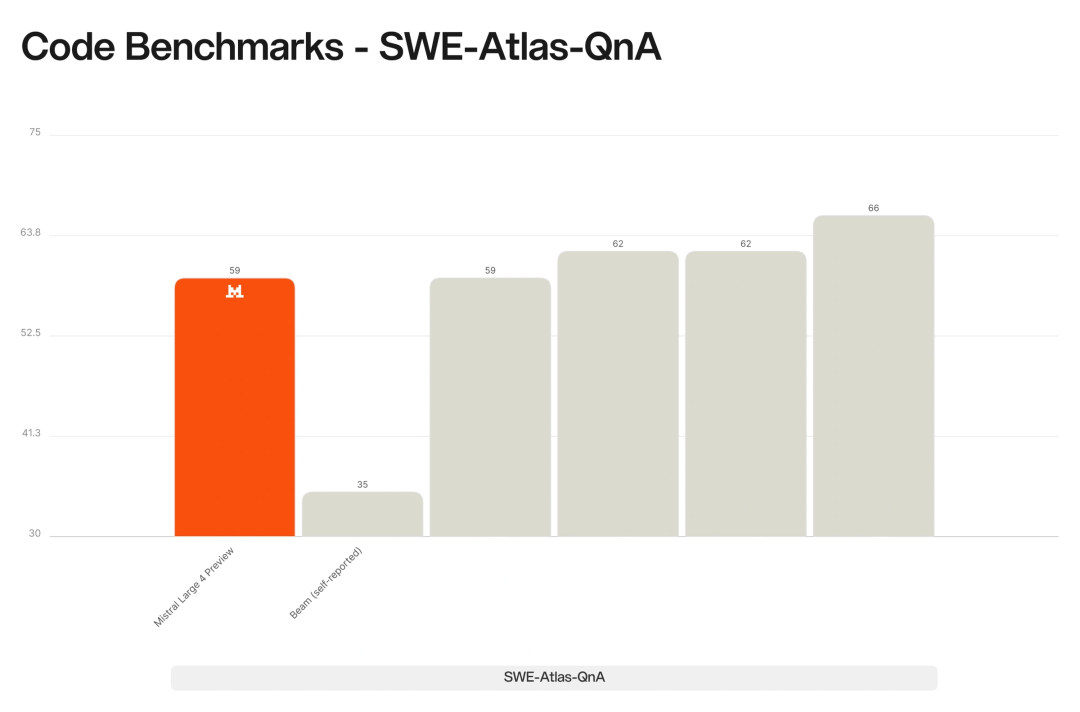
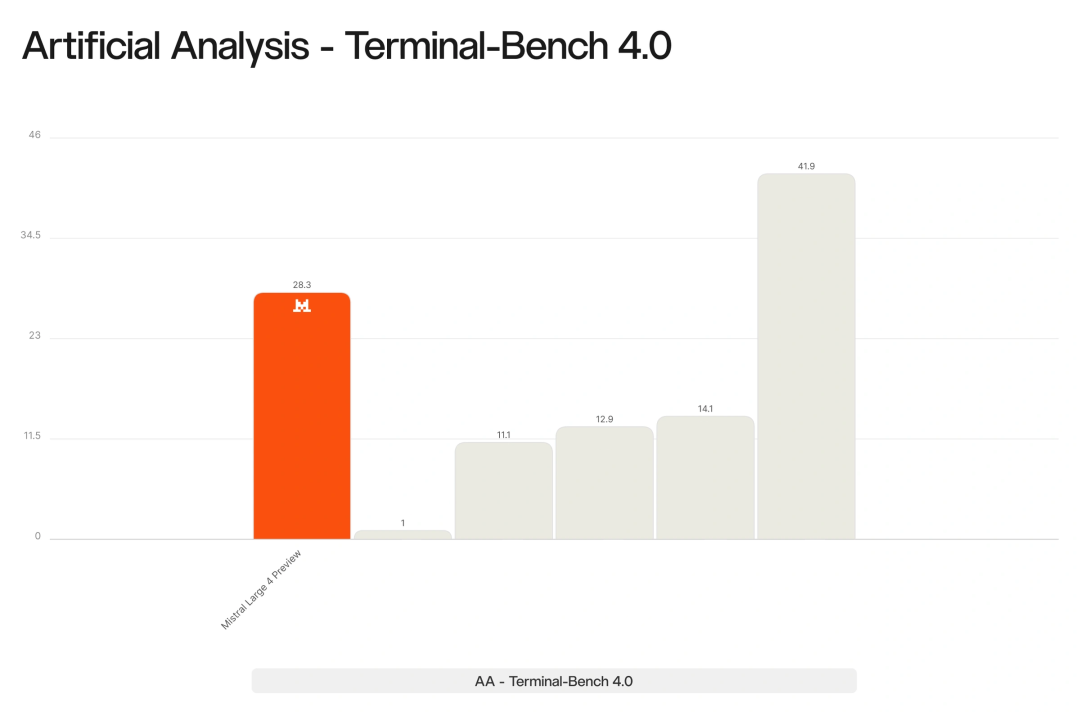
单论写代码,它在 DeepSWE v1.1 上拿到 61.7%,SWE-Atlas-QnA 拿到 59.4%,Terminal-Bench 4 拿到 28.3%。综合编程 Agent 指数拿到 49.8%,压过了两款顶级开源模型。
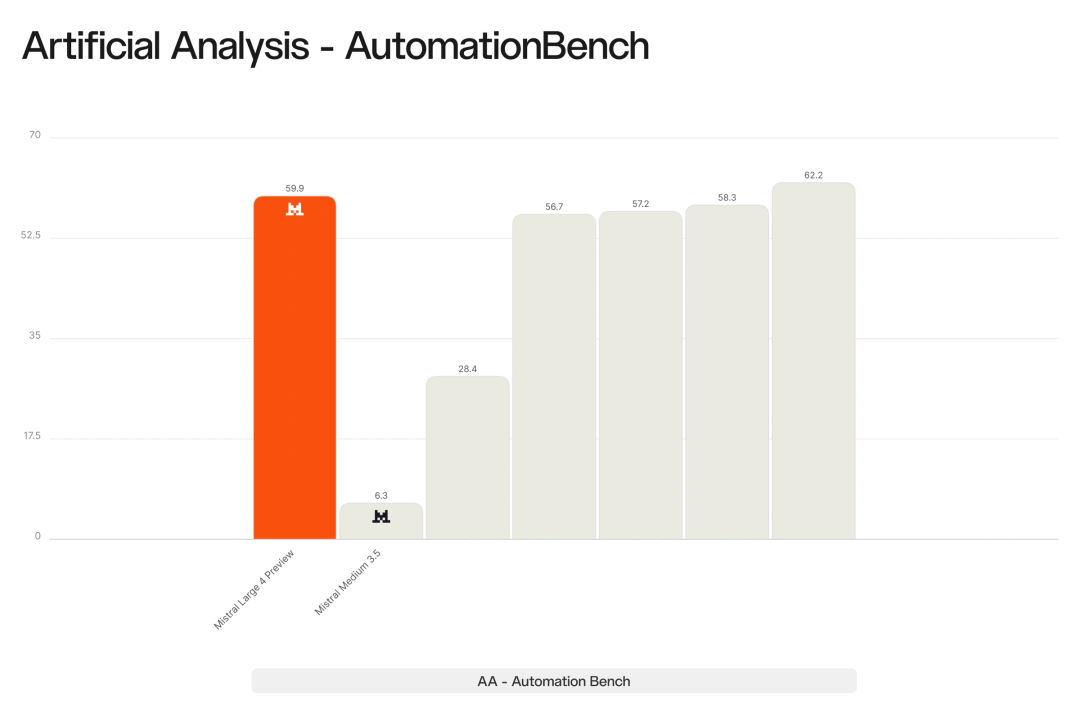
AutomationBench 测试收录了 657 个真实业务流程,模型要在 Gmail、Google 表格、Slack、Salesforce 之间来回切换,把活一步步干完。Mistral Large 4 在这里拿到 59.9%。
AA-Briefcase 考的是做表格、改 PPT、出 PDF 这类长线知识工作,Mistral Large 4 的 Elo 分达到 1393。
第三方评测机构 Vals AI 拿真实的法律、金融任务去考,Mistral Large 4 的表现超过了 GPT-6 Astra。在法律 AI 公司 Harvey 的法律 Agent 基准上,它压过了所有开源模型。
代码、法律、金融之外,它也很会看图。
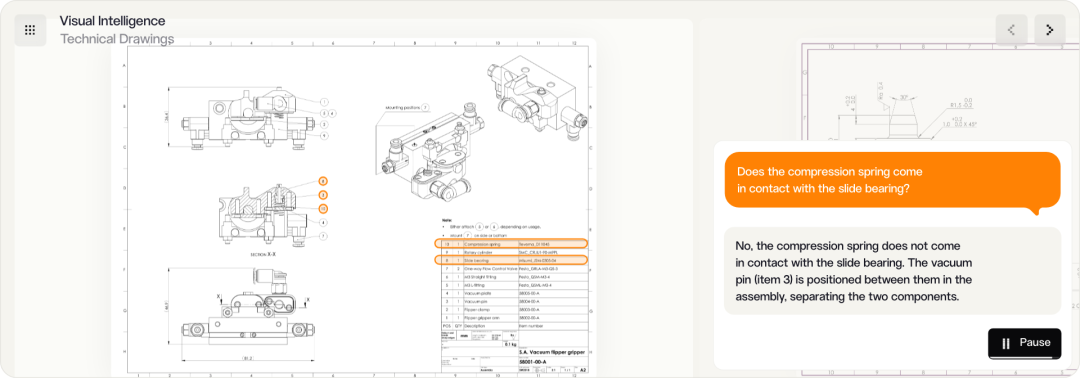
在十亿像素级的卫星图里,它能一点点找出目标,帮救灾队伍抢时间;对着工程图纸,它也能反复放大、检查、核对零件,直到答案准确为止。
给它一张真空翻转夹爪的装配图,问压缩弹簧会不会碰到滑动轴承。它在图里找到这两个零件,回答不会,因为中间隔着 3 号真空销。
在视觉定位测试 Dense 200 上,它拿到 42%,GPT-6 Astra 是 41.5%,连闭源旗舰都被它压了一头。
在科学编程测试 SciCode-Verified 上,它拿到 91.8%,是欧美开源模型里的最高分,还压过了 Claude Opus 5 的 91.3%。
放到实际科研里,它能一次写出完整的 Hartree-Fock 模拟代码。这是量子化学里计算分子电子结构的方法,要串起一长串复杂的计算步骤。
3800 块 Blackwell,从零喂出一只「肥猫」
Mistral 给这个模型起的官方代号叫 le Chonk。
chonk 是网上形容超大号胖猫的梗,CEO Arthur Mensch 还在 X 上亲自接梗:其实是「le gros chaton」,一只大胖猫。
它确实胖。
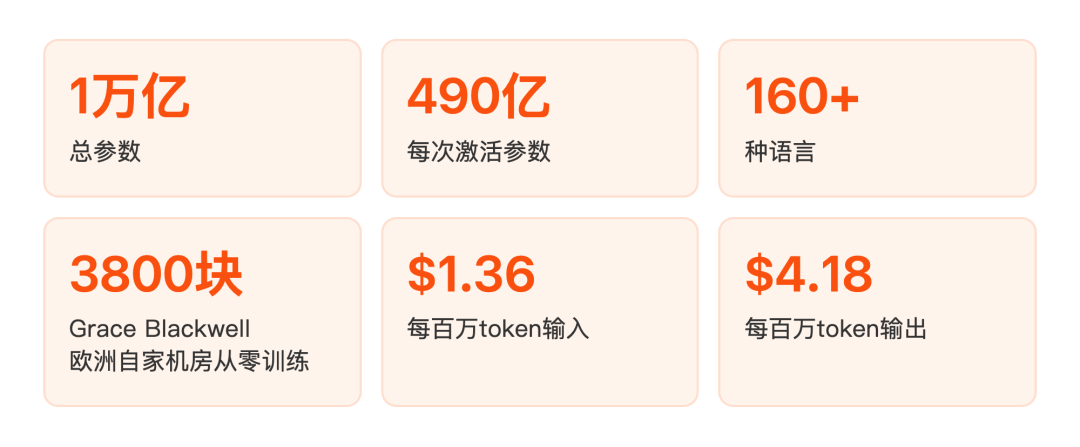
总参数 1 万亿,用的是混合专家架构,每生成一个 token 只叫醒其中 490 亿参数干活,所以胖而不慢。
它把指令、推理和 Agent 能力塞进了同一个模型,还能说 160 多种语言,欧盟所有官方语言全覆盖。
Mistral 在欧洲自家机房里,用 3800 块英伟达 Grace Blackwell 从零训练了它,现在开放的预览版也跑在同一批机器上。
后训练靠的是大规模强化学习。
一套会自动扩缩的集群同时跑几万条尝试,单条任务轨迹能用掉几百万 token,模型从自己每一次尝试的结果里学。按现在的规模,一次训练每天能产出 330 亿 token,过滤之后还剩约 160 亿可以直接拿来练。
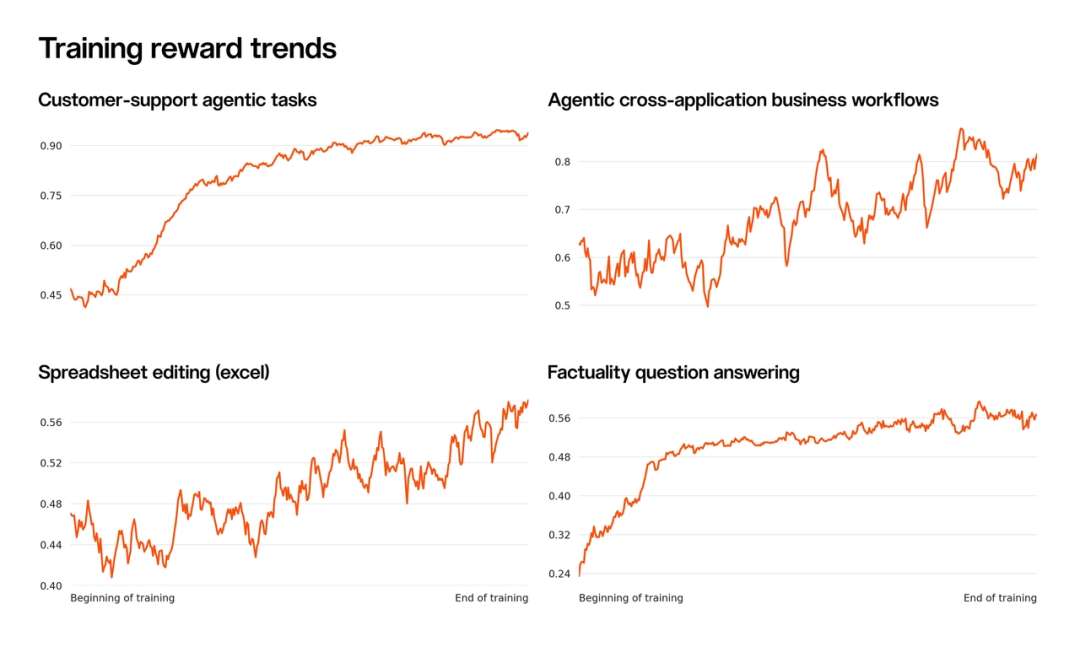
在客服 Agent、跨应用业务流程、Excel 表格编辑、事实问答这四类任务上,训练奖励都在持续上升。
而且,这轮强化学习还没跑完,模型也完全没有到顶的迹象。Mistral 的原话是,接下来几周到几个月,它还会有大幅、快速的提升。
模型还在练,预览版 API 已经在 Mistral Studio 上线,每百万 token 输入 1.36 美元、输出 4.18 美元。对习惯通过中转服务接入多个大模型的开发者来说,也可以留意 RouteFast.ai 后续对这类新模型的跟进情况。
完整权重月底放出,到时企业可以把它搬进私有云,或者直接装在自己的机房里。
万亿大脑的开关,交回用户手里
越往 ASI 走,模型能做的事越多,「谁来决定它能做什么」就越要紧。
过去两年,这个决定一直写在几家闭源厂商的安全策略里。同一个漏洞,GPT-6 和 Claude 说不碰,靠它们干活的安全工程师就只能停手。
Mistral Large 4 把一颗能和闭源旗舰掰手腕的万亿大脑,连同开关一起交了出去。权重在自己手里,模型部署在哪、什么时候用,就不再由厂商说了算,也不会在关键时刻被一刀切断。
而它还只是一个没练完的预览版。
Mistral 手握 30 亿欧元 D 轮融资,这是欧洲科技公司史上最大的一笔股权融资。这笔钱正用来扩建欧洲自家机房的算力,Mistral Large 4 只是这条路线上的第一站。
想要继续追踪这类开源大模型的一手动态,也可以在云栈社区和大家一起讨论。
参考资料:Mistral Large 4 官方公告
 发表于 17 小时前
|
查看: 3|
回复: 0


