大语言模型现在大致可以分成四类:生成、嵌入、重排、判断。这篇文章专门聊最后一类——判断模型,也可以叫它决策模型。英文圈里还有个新名字叫 System One,借的是人脑那种快速、凭直觉做判断的机制。它和聊天模型完全不是一码事:你交给它一段状态,再附上几个问题,它不会写回话,只给一个选择、一个分数,或者一个是与否的概率。程序拿到结果,就能直接决定往哪条分支走。
这类模型最近半年突然热起来,起因是 TypeSafe AI 在 2026 年 9 月发布的 Jev。Jev 只提供云端接口,不开源,但发布没几天,开源圈就冒出一连串平替:Laya、Kev、Clef、decider、GEV。国内上海人工智能实验室也推出了书生·明决,ModelScope 上陆续上架了一批。本文把它们集中梳理一遍:来历、能力、部署方式、资源占用、实测成绩,最后给一份选型清单。
和聊天模型不是一回事
判断模型的输出空间是提前框死的。提问时,你直接把手里的候选答案一并交出去,它只负责在候选里挑一个,所以根本编不出不存在的东西。整个过程只做一次前向传播(forward pass,指数据在网络里从头到尾算一遍),所有选项的概率一次算完,不逐字往外生成,因此又快又便宜。
表 1 判断模型只回三种东西
| 类型 |
你要给什么 |
它返回什么 |
典型用途 |
| choice |
一组候选项,最多 255 个 |
命中哪个,外加每个选项的概率 |
路由、意图分类、工具选择 |
| score |
一个有序刻度,通常 2 到 10 级 |
落在哪一档,可以带小数 |
紧急度、质量、风险打分 |
| noul |
一个是或否的问题 |
0 到 1 的概率 |
门禁、该不该执行、要不要升级 |
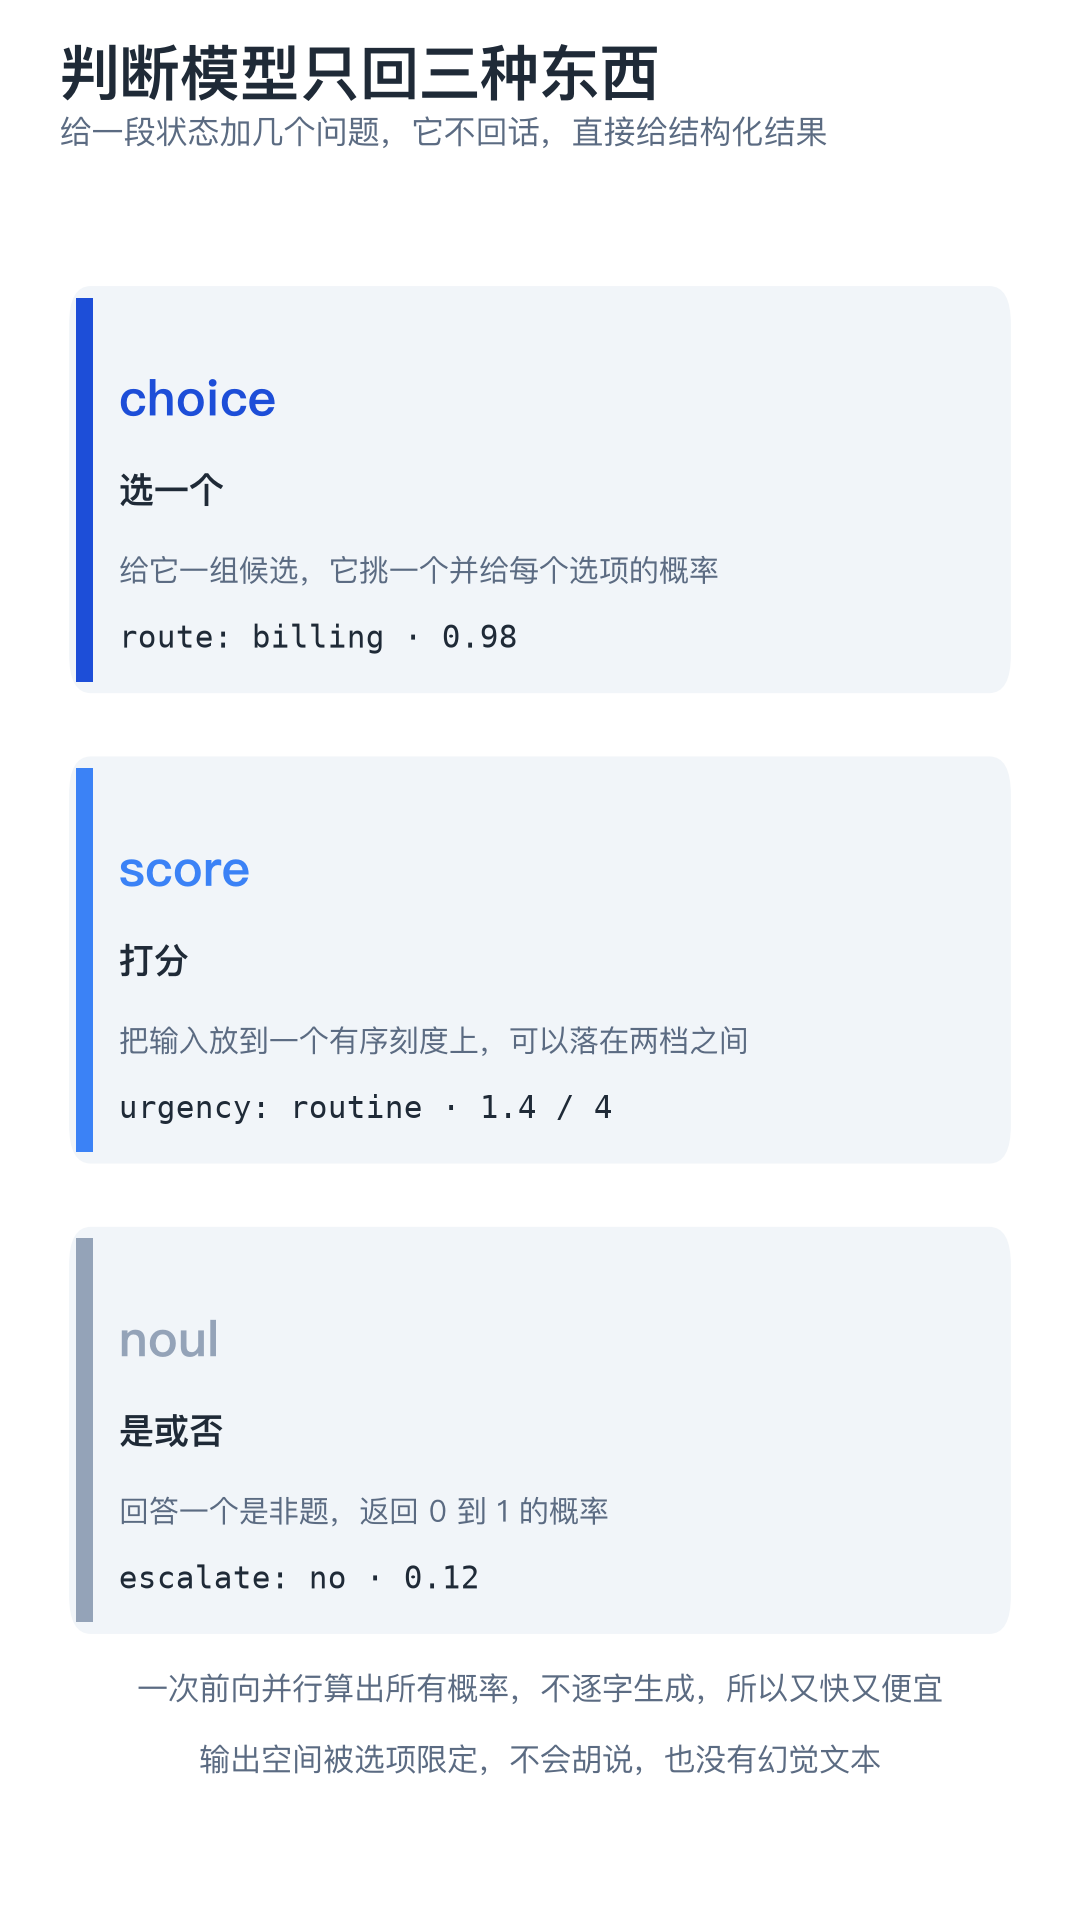
图 1 判断模型只回三种东西:choice 从候选里挑一个、score 打分、noul 回答是或否。
生成模型靠“写一段话给结论”,判断模型靠“直接报概率”。前者会甩出一大段文字,还得再解析;后者只给一个数,拿来就能判断。Jev 官方文档[1]的计费方式也印证了这一点:输入按量收费,输出免费,因为返回的不是生成的文字,而是一个结构化结果。
火起来的起点是 Jev
TypeSafe AI 是旧金山的一家实验室,创始人 Diogo Almeida 自称出身 OpenAI,参与过 ChatGPT 指令跟随相关的研究。Jev 于 2026 年 9 月 15 日发布,9 月 21 日开放托管的 API(Application Programming Interface,应用程序接口,这里指云端调用的入口)[2]。
它的训练方法叫 RLCD(Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习)。做法是拿一组合适的评分规则当奖励,模型想拿高分,唯一的办法就是把真实概率老老实实报出来,而不是随口给个 0.99。官方说它一次就把所有概率并行算完,不靠自回归一个个词元(token,模型处理文本的最小单位)地生成[1][2]。
表 2 Jev 的要点
| 项目 |
情况 |
| 出品方 |
TypeSafe AI |
| 发布 |
2026 年 9 月 15 日,9 月 21 日开放 API |
| 开源 |
否,权重不公开,只有托管 API |
| 参数与架构 |
官方一直没公布 |
| 输出 |
choice、score、noul,都带概率 |
| 选项上限 |
255 个 |
| 上下文 |
请求合计 64k token(词元,模型处理文本的最小单位) |
| 计费 |
输入每百万 token 收 0.042 美元,输出免费 |
| 速率 |
每秒 10 万 token、每秒 80 个请求 |
Jev 只在云端提供服务,下载不了,也无法私有化,更不能用自己数据微调,官方明确说所有账户共用同一份权重[1]。它留下的这片空白,很快就有人来填。
开源平替几乎同步出现
Jev 发布后没几天,Laya 和 Kev 就相继出现,走的是同一条路线:不自回归,一次前向就读出概率,接口照着 Jev 的 /v1/systemone 来做。
Laya 出自 Convai Innovations,GitHub 仓库建于 2026 年 9 月 18 日,采用 Apache-2.0(一种允许商用的开源许可)。它一共放了三个检查点:英文版基于 ModernBERT-large,4.21 亿参数,上下文 512;多语言版基于 mmBERT-base,3.22 亿参数,上下文 1024,覆盖 100 多种语言;还有一个 typed-decisions 版,同样 4.21 亿参数,在发票、安全事件、客服和 agent(智能体)轨迹四类工作流上做过微调。用法很简单,pip install laya 即可,在特斯拉 T4(英伟达的一款推理用显卡)上单个问题耗时 32.8 毫秒。需要留意的是,英文和多语言这两个基础检查点如果不再微调,准确率基本等于随机,必须用自己标注的数据训一遍[3][4][5]。
Kev 出自 Jared Palmer,同样采用 Apache-2.0,提供 0.8B、4B、9B、27B 四个尺寸,基座是 Qwen3.5。它最大的卖点是接口与 Jev 完全一致,把官方 SDK(Software Development Kit,软件开发工具包,这里指官方提供的调用库)里的接口地址 base_url 改成本地就能直接接上。4B 版本一张 24GB 显卡或一台 32GB 的 Mac 就能跑,在 H100(英伟达的数据中心 GPU,图形处理器)上六个问题一共只用 18 毫秒。它还能用自己标注的数据微调,4B 在 H100 上训一轮大约花 1 美元[6][7]。
表 3 Jev、Laya、Kev 对比
| 维度 |
Jev |
Laya |
Kev |
| 出品 |
TypeSafe AI |
Convai Innovations |
Jared Palmer |
| 开源 |
闭源,仅托管 |
Apache-2.0 |
Apache-2.0 |
| 规模 |
未公开 |
4.21 亿 / 3.22 亿 |
0.8B / 4B / 9B / 27B |
| 基座 |
未公开 |
ModernBERT-large / mmBERT-base |
Qwen3.5 |
| 输出 |
choice / score / noul |
同 |
同 |
| 上下文 |
64k |
512 / 1024 |
8k,27B 版到 65k |
| 部署 |
云端 API |
本地 pip 安装 |
本地命令行(uv)或 Modal(云端算力平台) |
| 计费 |
按输入 token 计费 |
用自己的显卡 |
用自己的显卡 |
| 速度 |
官方称 70 到 500 毫秒[2],第三方实测中位约 236 到 276 毫秒[8] |
在 T4 上单个问题 32.8 毫秒 |
在 H100 上六个问题共用 18 毫秒 |
| 强项 |
校准概率、大选项集 |
本地、多语言、便宜 |
接口一致、可微调、尺寸全 |
ModelScope 上能直接下的
ModelScope 上这一类已经有十来个,用站内列表页搜不到(需要登录),但按名字直接打开模型页都能访问。下面这些都在,附上各自的基础模型和许可。表里会反复出现几个缩写,先说明一下:LoRA(Low-Rank Adaptation,低秩适配,一种只训练少量附加参数的轻量微调方法)、NVFP4(一种 4 比特浮点量化格式)、CPU(Central Processing Unit,中央处理器,这里指不依赖显卡的处理器)。
表 4 ModelScope 上可以下载的判断模型
| 模型 |
出品 |
基座与规模 |
许可 |
说明 |
| convaiinnovations/laya |
Convai Innovations |
ModernBERT-large 4.21 亿 |
Apache-2.0 |
下载 1.4 万次,这一类里最热 [5] |
| convaiinnovations/laya-multilingual |
Convai Innovations |
mmBERT-base 3.22 亿 |
Apache-2.0 |
覆盖 100 多种语言 [5] |
| convaiinnovations/laya-typed-decisions |
Convai Innovations |
ModernBERT-large 4.21 亿 |
Apache-2.0 |
四类工作流微调 [5] |
| jaredpalmer/kev-4b |
Jared Palmer |
Qwen3.5-4B |
Apache-2.0 |
与 /v1/systemone 接口一致 [7] |
| Cloudflare/clef |
Cloudflare |
Qwen3.8-27B |
Apache-2.0 |
多模态,上下文 64k [9] |
| Cloudflare/clef-flash |
Cloudflare |
Qwen3.5-9B |
Apache-2.0 |
量化后约 6.5GB,消费级显卡能跑 [9] |
| autotrust/GEV-26B-Decide |
AutoTrust |
Gemma-4-26B-A4B |
Apache-2.0 |
256K 上下文,NVFP4 后 17GB [10] |
| Mapika/decider-4b |
Mapika |
Qwen3.5-4B |
Apache-2.0 |
单张显卡能跑 [11] |
| Mapika/decider-2b |
Mapika |
Qwen3.5-2B |
Apache-2.0 |
更省资源,笔记本也能跑 [11] |
| interfaze-ai/lev |
Interfaze AI |
Qwen3.5-4B 加 LoRA |
Apache-2.0 |
兼容 TypeSafe 接口 [12] |
| flymy-ai/decision-4b-v1.2 |
FlyMy.AI |
Qwen3.5-4B 加 LoRA |
Apache-2.0 |
打榜用的 Jev 风格适配器 [13] |
| OpenJev/OpenJev |
TheoLeeCJ |
Qwen3.5-4B |
非商用 |
CPU 和浏览器都能跑 [14] |
| bespokelabs/Bespoke-Nimble-9B-v3 |
Bespoke Labs |
Qwen3.5-9B 加 LoRA |
非商用 |
只放适配器,需自备基座模型 [15] |
| PatronusAI/glider |
Patronus AI |
Phi-3.5-mini |
非商用 |
更早的评测用小模型 [16] |
许可要留个心:标 Apache-2.0 的可以商用,标非商用(CC-BY-NC,一种禁止商用的知识共享许可)的只能研究和自用。上表里 OpenJev、Bespoke Nimble 和 glider 都是非商用。
大厂也下场了
除了社区项目,几家大机构也在两个月内跟进。
Clef 和 Clef-Flash 出自 Cloudflare,2026 年 10 月 1 日发布[17]。Clef 是 27B,基座 Qwen3.8-27B;Clef-Flash 是 9B,基座 Qwen3.5-9B。两者的结构都是骨干网络加一个联合 schema 头(把每个问题和它的候选项编码成一组结构,再统一打分),一次前向完成,还带一个视觉编码器,能看图。上下文官方标 64k。在 Cloudflare 自己的跑分里,Clef 的中位延迟是 209 毫秒,Clef-Flash 是 38.8 毫秒,同一口径下 Jev 为 524 毫秒。许可为 Apache-2.0,ModelScope 上也提供了[9]。
Strands Decider 2B 出自 AWS Strands Labs,2026 年 10 月 1 日发布[18][19]。它 1.9B,基座 Qwen3.5-2B,做法是把语言模型的输出头换成一个约百万参数的指针头,训练只需要一张 RTX 3090(英伟达的一款显卡)跑 11 小时。在 RTX 3090 上延迟中位数约 115 毫秒,在 M3 Mac(苹果自研 M3 芯片的笔记本)上约 153 毫秒。JevBench(一个第三方独立评测榜)公共集准确率为 0.762[20]。
书生·明决的仓库名是 Intern-Decision,出自上海人工智能实验室,2026 年 9 月 28 日开源[21]。它有 0.8B、2B、4B 三档,基于 Qwen3.5,把视觉编码器冻结后接入,做成多模态。官方给的是单张 RTX 4090 的延迟,4B 中位 44 毫秒。七项测试里 4B 平均得 90.02 分,同一套口径下 Jev 是 88.74 分。国产 GPU(Graphics Processing Unit,图形处理器,也就是显卡)厂商沐曦称已完成 Day 0 适配(新品发布当天就适配好)。
还有 StartLux-Decision[22],尺寸最全,从 0.8B 一直到 35B-A3B(总参数 350 亿、每次只激活约 30 亿的混合专家模型),支持图片输入,但许可是非商用;NeoHorse-Jev-4B[23] 支持图文决策;NanoJev[24] 是个 0.6B 的小模型,作者拿它和 Jev 在迷宫、贪吃蛇这类游戏任务上做过对比。
表 5 里出现的几个词先说明一下:BFCL 指 Berkeley Function Calling Leaderboard,是一项函数调用能力评测;DI 指 Decision Index,是综合决策指数;H200 是英伟达的一款数据中心 GPU。
表 5 大厂与国产的判断模型
| 模型 |
出品 |
时间 |
基座与规模 |
许可 |
速度 |
关键成绩 |
| Clef |
Cloudflare |
2026-10-01 |
Qwen3.8-27B |
Apache-2.0 |
中位 209 毫秒 |
BFCL 98.5 [17] |
| Clef-Flash |
Cloudflare |
2026-10-01 |
Qwen3.5-9B |
Apache-2.0 |
中位 38.8 毫秒 |
BFCL 98.8 [17] |
| Strands Decider 2B |
AWS |
2026-10-01 |
Qwen3.5-2B |
Apache-2.0 |
3090 上中位 115 毫秒 |
JevBench 0.762 [18] |
| 书生·明决 |
上海人工智能实验室 |
2026-09-28 |
Qwen3.5-0.8B/2B/4B |
Apache-2.0 |
4090 上 4B 中位 44 毫秒 |
七项均值 90.02 [21] |
| StartLux-Decision |
StartLux Labs |
2026-09-29 |
Qwen3.8-27B 等 |
非商用 |
H200 上 27B 102 毫秒 |
自评 DI 63.88 [22] |
| NeoHorse-Jev-4B |
TokenRhythm |
2026-09 |
Qwen3.5-4B |
Apache-2.0 |
未公布 |
自评均值 77.70 [23] |
| NanoJev |
个人项目 |
2026-09-17 |
Qwen3-0.6B |
MIT 许可 |
未公布 |
只在游戏任务上 [24] |
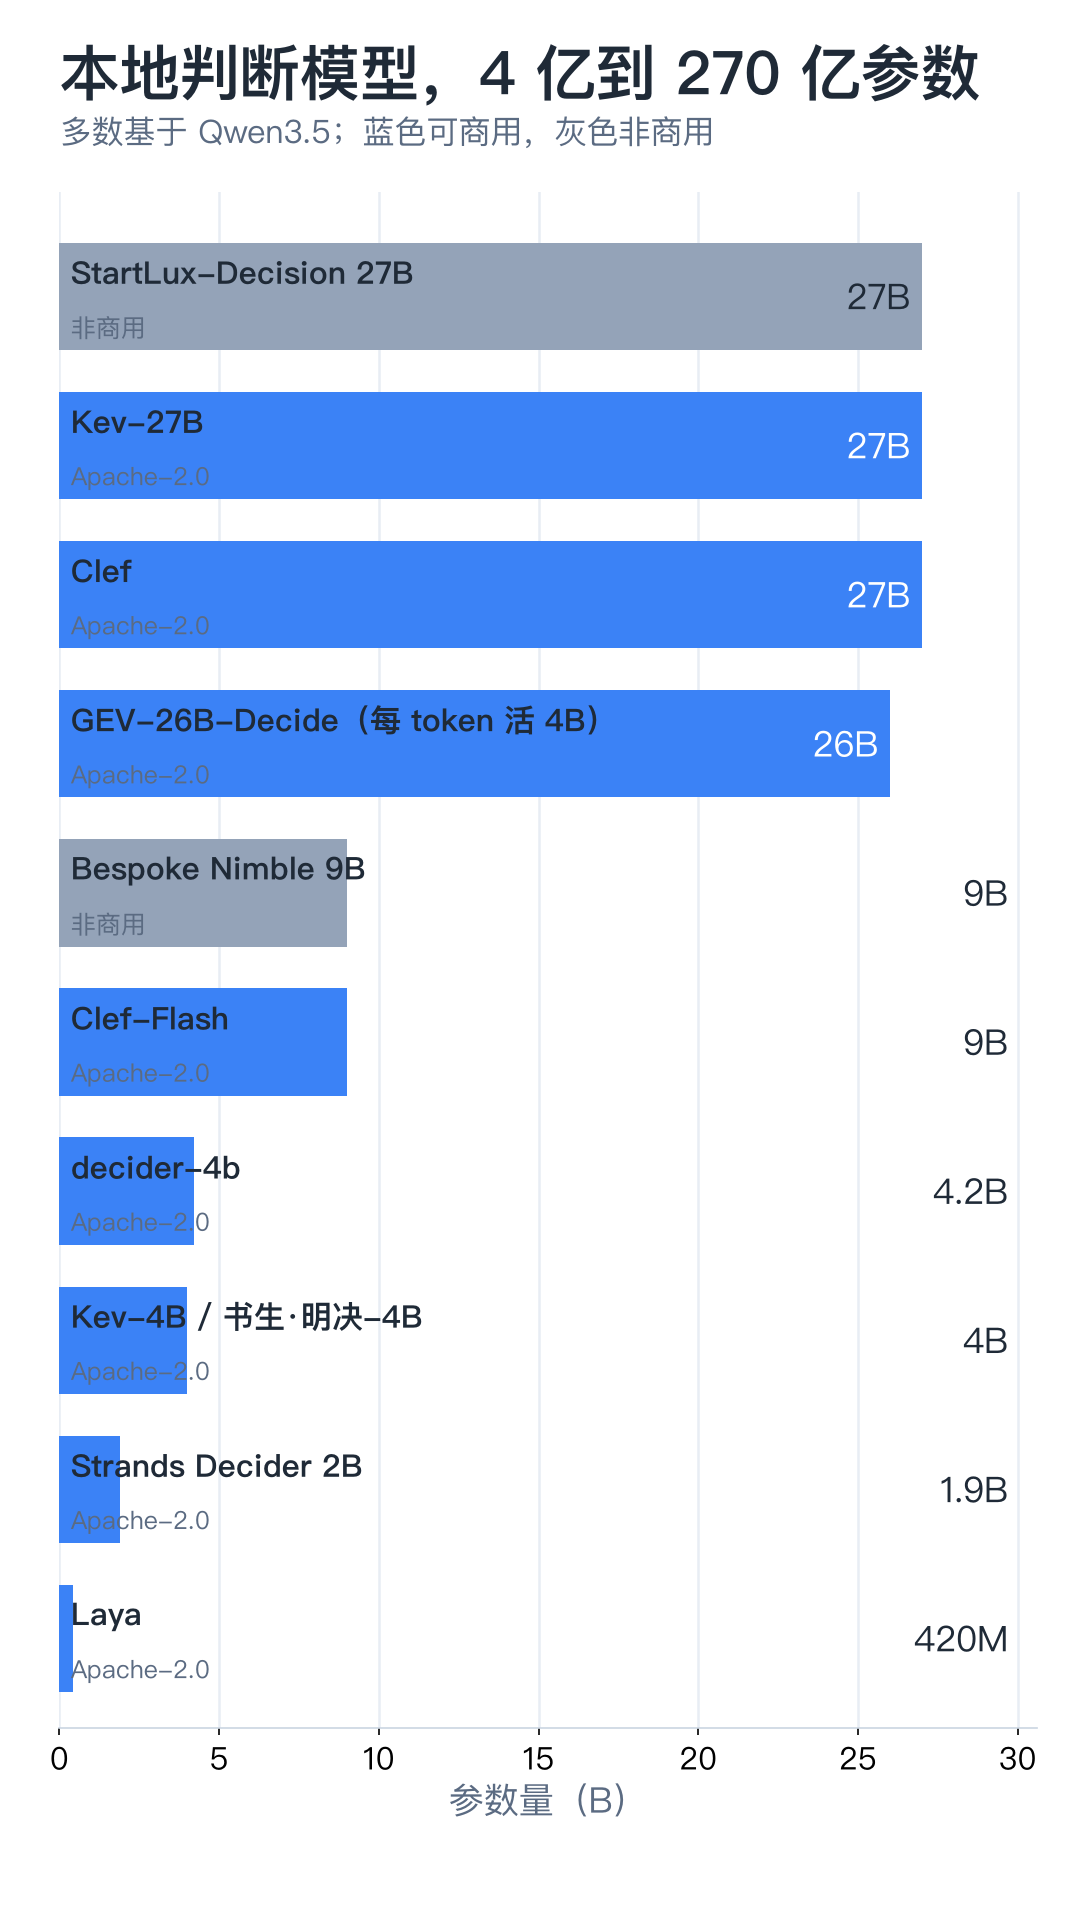
图 2 本地能跑的代表模型及其规模,蓝色为可商用许可。
如何分高下
判断模型有一个第三方独立榜叫 JevBench,挂在 benchmarkheaven.com 上,版本更新很快[20]。它把每个系统的智能、校准、速度、成本四个维度做调和平均,算出一个综合分,题目里有一部分是密封的,参与者也拿不到原文,用来防止刷分。
表 6 JevBench 榜单前列(版本 1.4.2.2)
| 名次 |
模型 |
综合分 |
智能 |
校准 |
部署 |
| 1 |
Imajev-4B |
67.4 |
52.2 |
80.4 |
自托管 |
| 2 |
Plumb-4B |
65.8 |
53.0 |
75.5 |
自托管 |
| 3 |
decider-4b v2 |
64.1 |
49.4 |
75.0 |
自托管 |
| 4 |
Jev 1.13.0 |
63.3 |
53.1 |
76.3 |
云端 API |
| 5 |
JevK5 v0.2 |
62.0 |
48.9 |
74.5 |
自托管 |
| 6 |
Cygnet |
61.8 |
49.5 |
74.9 |
自托管 |
| 7 |
Hopper |
59.4 |
48.0 |
79.1 |
自托管 |
| 8 |
Winnow-12B Q8 |
55.6 |
48.3 |
64.8 |
自托管 |
| 9 |
reflex 4B |
54.0 |
47.5 |
70.4 |
自托管 |
| 10 |
djev |
52.2 |
47.0 |
55.4 |
云端 API |
读这个榜要注意两点。综合分把速度和成本算得很重,所以几个开源 4B 模型靠便宜和快排到了 Jev 前面;但只看智能这一项,Jev 仍是前十里的第一。另外,榜上大量数字是各团队自己报的,硬件和测试口径都不统一,Laya 作者就明确说过自己并没有调用 TypeSafe 的接口,两个模型并没有在同一套题上正面比过。它适合拿来定方向,不适合当成结论。
怎么选
要云端托管、不想碰显卡、候选项又特别多,选 Jev。它的概率校准做得好,可以直接拿来设阈值,255 个选项加 64k 上下文,目前没有对手。
要开源、要能私有化、还想拿自己的数据微调,选 Kev。接口和 Jev 一模一样,尺寸从 0.8B 到 27B,既有笔记本能跑的,也有数据中心级的。如果只想在本地把 Jev 那套接口跑起来,Laya 最省事,4 亿参数,连 CPU 都能跑,还自带多语言。
要在边缘部署又要看图片,Clef-Flash 合适,9B,量化后 6.5GB,8GB 显存就够,延迟三十几毫秒。要在智能体里塞一个便宜、高频的判断器,Strands Decider 2B 或 Mapika 的 decider-2b 更轻。要国产、要合规、要图文,书生·明决的 4B 是现成的选择。
只有一张 24GB 显卡、又想跑大一点的模型,GEV-26B-Decide 用 NVFP4 量化到 17GB 就能跑,256K 上下文,还能开启自适应思考。非商用场景想要一整套可调尺寸,可以看 StartLux-Decision。
表 7 按场景选型
| 使用场景 |
建议 |
| 托管、零运维、选项多 |
Jev |
| 开源可训、接口要一致 |
Kev |
| 本地、多语言、要省资源 |
Laya |
| 边缘部署且要看图 |
Clef-Flash |
| 智能体内高频、便宜的判断 |
Strands Decider 2B、decider-2b |
| 国产、图文、合规 |
书生·明决 |
| 单张 24GB 显卡跑大模型 |
GEV-26B-Decide(NVFP4) |
| 非商用、尺寸要全 |
StartLux-Decision |
判断模型不是要取代大模型,它是插在“想清楚”和“动手做”之间的一层。大模型负责理解和生成,判断模型负责在关键节点拍板、分流、把关。把它和生成模型拼起来用,才是这类东西真正的价值。这类模型迭代速度很快,云栈社区里也不断有同好在交流选型与部署经验。
参考链接
本文数据截至 2026 年 10 月 8 日;这类模型发布密集、更新很快,参数、许可和榜单都可能变动,请以各自官方页面为准。
 发表于 1 小时前
|
查看: 9|
回复: 0


