AI 能够修改自己的代码,是否就能持续变得更强?递归自改进的终极形态,或许在于系统不仅能够理解并改写自身的改进机制,还能进一步改进「改进机制的方法」,如此递归下去,乃至触发智能爆炸。然而,这样的无穷递归可能吗?上篇《递归定理|集智百科》梳理了克莱尼递归定理的基本原理,以及第二递归定理如何为程序自指提供数学基础。本文在此基础上提出猜想:终极递归自改进与系统的自指能力密切相关。沿着第二递归定理揭示的自指构造,我们进一步探讨自反射结构如何支撑自省式自改进,以及其中的结构条件与工程难题:从数学上能够「访问自己」,到现实中能够持续「改进自己」,究竟还有多远?
研究领域:递归自改进、自指、第二递归定理、自省、反射结构、大语言模型。
我有一个大胆的猜测:目前 AI 圈大火的递归自改进,拼到最后,不是拼谁的模型大,谁的架构好,谁的算法巧妙,而是拼自改进系统的自指能力。你的系统在越大的范围内、越完备地实现自指,才能获得越厉害的递归自改进能力。
第二递归定理(Second Recursion Theorem,简称 SRT),被称为「函数式珍珠」,是自指的最小、最精致的数学表达。本文将沿着 RSI 的能力下降、提升与阈值,论证为什么自指是终极递归自改进程序的必备能力,并详细介绍第二递归定理,以及要实现真正意义上的自指式递归自改进,需要 AI 系统具备什么特征。
一、递归自改进:越改越强,还是越改越垮?
1.1 从「智能爆炸」到「规模法则」
过去两年,AI 行业不再满足于「造一个静态的大模型,再由人类工程师反复调教」。它们想造的是一个会自我进化的系统:一个智能体,能自己改写自己的提示词、策略、工具用法、记忆结构,甚至底层参数,通过与环境的持续交互,自己把自己变得越来越强。
这个想法其实一点都不新。早在 1965 年,统计学家 I. J. Good 就提出过著名的「智能爆炸」假说:如果一台「超级智能机器」能够设计出比它自己更聪明的机器,那么这台新机器又能设计出更更聪明的机器,如此循环,智能将以指数级暴涨。今天人们给这个机制起了一个更技术化的名字——递归式自改进(Recursive Self-Improvement,下文简称 RSI)。
RSI 的诱惑是巨大的:一旦启动,它似乎承诺「一劳永逸」——人类不必再一遍遍地训练、调参、监督,系统自己就能滚雪球式地进化下去。但这里藏着一个很少被认真对待的陷阱:「自我改进」这件事,为什么一定会是「改进」,而不是「改退」?
进入深度学习时代以来,AI 一直在持续改进。然而,这种改进本质上靠的是规模法则(Scaling law),是人类工程师在外部持续供血:数据是人类准备的,评估是人类做的,训练是人类启动的。它和「系统自己改自己」是两码事。
RSI 要的是另一条路:把「改进」这件事本身,交还给系统自己。Good 的智能爆炸、Yudkowsky 的「种子 AI」(Seed AI)、Schmidhuber 的哥德尔机,都属于这条脉络。它们的共同理想是:系统不仅能优化自己的任务表现,还能优化「自己优化自己的能力」——这才是「递归」二字的真正含义。
AI 自己改自己到底靠谱吗?过去 10 年发展的事实证明,大语言模型的确具备在线学习的能力,而且还可以通过强化学习的方式持续提升。
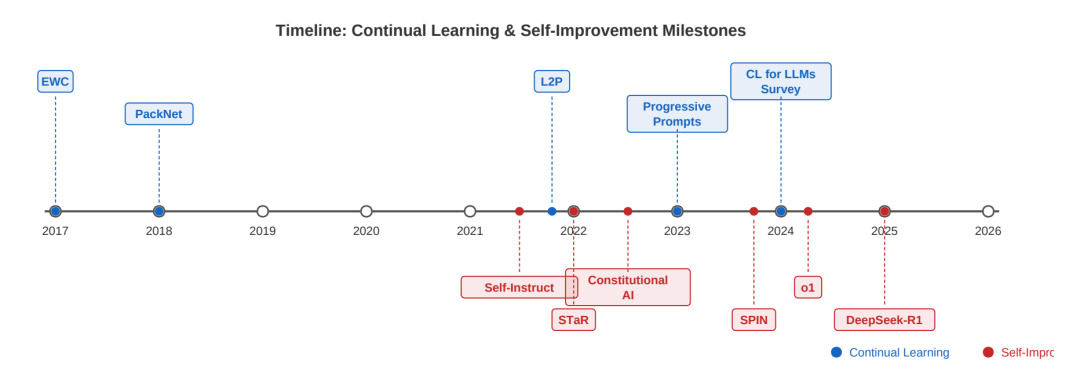
另外,实证数据也表明(根据这篇:https://zhuanlan.zhihu.com/p/2047037290392899916),在 2024–2026 的两年里,AI 系统在多项编码和研究基准上经历了从「刚刚起步」到「饱和」的历程:
| 基准 |
用途 |
2023/2024初 |
2025 |
2026 |
关键变化 |
| SWE-Bench Verified |
真实软件工程任务 |
Claude 2: ~2% (2023) |
70%+ |
~93.9% (饱和) |
两年内从个位数到饱和 |
| METR Time Horizon |
AI 可靠完成任务的人类等效时长 |
~4分钟 (Claude Opus3, 2024.03) |
~6小时 (GPT 5.2) |
~12小时 (Opus 4.6, 2026.03) |
翻倍时间从每7月缩短到每4月 |
| CORE-Bench |
复现论文结果 |
~21.5% (2024.09) |
Opus 4.5: 95.5% (2025.12) |
饱和 |
15个月后饱和 |
| MLE-Bench |
Kaggle竞赛 |
16.9% (2024.10) |
— |
Gemini3: 64.4% (2026.02) |
已大幅接近人类水平 |
| PostTrainBench |
后训练/微调 |
— |
— |
AI: 25-28% vs 人类: 51% (2026.04) |
达到人类的一半水平 |
1.2 为什么「越改越差」真的会发生:模型崩塌
可惜,现实很快就给这个美梦泼了一盆冷水。
最著名的警钟是模型崩塌(model collapse)。2024 年《Nature》上的一项研究发现:如果不断地用上一代模型生成的数据去训练下一代模型,几代之后,模型的输出多样性会急剧收窄,原本丰富的「模式」一个个消失,最终坍缩成几句重复的废话。更让人警惕的是,后续研究(Dohmatob 等)证明,哪怕训练数据里只混入了极小比例的人工合成数据,这种崩塌都会被触发——而且堆更多的数据也救不回来。
换句话说:「用模型的输出去喂模型」这个循环,天然倾向于「退化」而不是「进化」。 这就把一个根本性问题摆到了台面上——
递归自改进,到底有没有一道绝对的天花板?如果有,它的数学本质是什么?
1.3 自改进是一个动力系统
说到递归自改进,也许你会想到动力系统迭代。也就是说,「一个程序改进自己」这件事可以看成一个不断迭代的离散动力系统:每一步,程序 $P_n$ 经过一个改进算子 $T$,变成新的程序 $P_{n+1} = T(P_n)$。所谓「持续不断地递归改进」,就是这个动力系统的不断迭代:
$$P_0 \longrightarrow P_1 \longrightarrow P_2 \longrightarrow \cdots$$
动力系统理论早就告诉我们一个基本事实:大多数迭代过程都会收敛到某些「不动点」或「不变集合」——一旦掉进去,就再也走不出来了。 改进系统也不例外。如果改进算子 $T$ 是固定的,那么迭代几十代、几百代之后,新程序很可能在某个「行为模式」上原地打转,多样性丧失殆尽。模型崩塌,本质上就是这个「不动点」在数据层面的一次现身。当然,还有另一种情况,这就是混沌情形,但它显然也不是 RSI 真正想要的:因为混沌系统确定性的迭代最终却导致完全随机性的结果。
RSI 真正想要的是 Wolfram 所说的复杂类型:迭代系统的参数落入到混沌与秩序边缘的临界地带,迭代始终是一个正在发生、但从未完成的相变过程。但事实表明,你要在保持 AI 系统功能的同时维持在这样临界的状态,成为复杂类型的动力系统并不简单。仿佛 RSI 会碰到一个门槛,超过这个门槛,RSI 就能持续递归改进下去;超不过,就会让模型不断降级,甚至是模型塌方。正如这张摘自 https://victorchen96.github.io/auto_research/continual_learning_survey.pdf 的图所表达的:
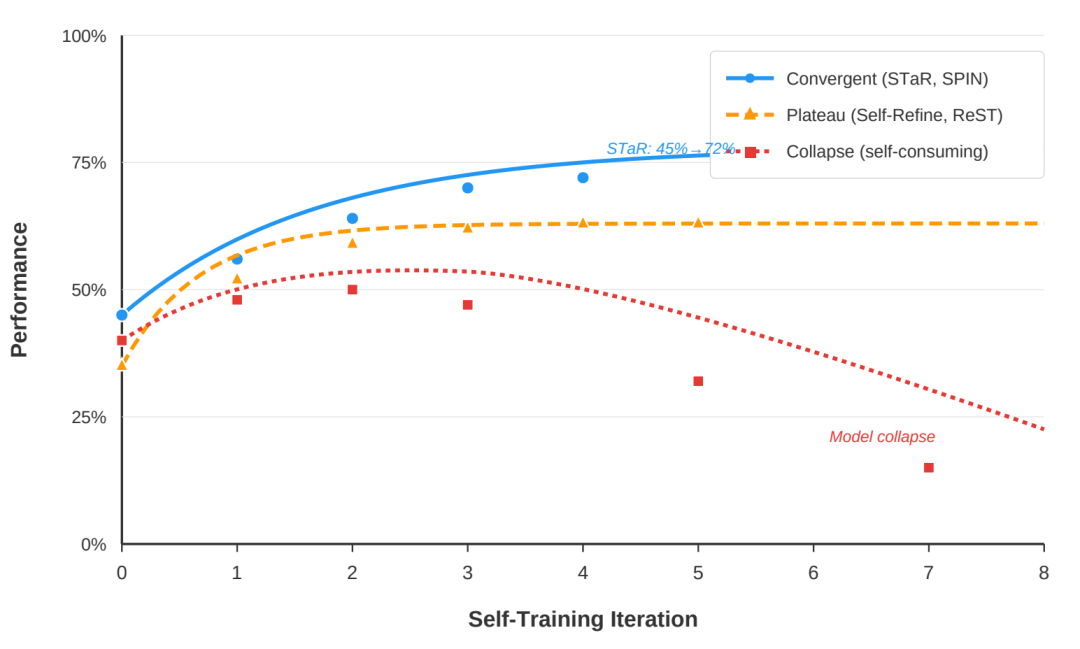
图:自提升路径分类体系。 收敛型方法(如 STaR、SPIN)依靠外部验证或人类数据作为基准;平台型方法(如 Self-Refine、ReST)会在数轮迭代内耗尽可修正错误;崩塌型方法缺少基准信号,性能最终发生退化。曲线基于已发表实验结果绘制(Zelikman 等人,2022;Chen 等人,2024;Madaan 等人,2023;Shumailov 等人,2024)。
事实上,早在 20 世纪 40–50 年代,著名数学家冯·诺伊曼就已经发现了机器自我改进的这个复杂度相关的阈值问题,并明确指出了这个复杂度阈值与机器的自指能力密切相关,这也是「第二递归定理」(SRT)需要被关注的重要因素。
1.4 一场博弈:固定的改进算法终会被看穿
换个角度,我们还可以从博弈的角度来看待 RSI 这件事儿。设想人类使用 AI 是一个与 AI 进行的博弈过程。如果某个自改进系统的改进算法是固定的——比如「每轮都按同一套规则生成 10 个候选、挑分数最高的那个」——那么这个算法产生的输出(概率分布),必然带有可以预测的规律。人类(或竞争对手)只要观察到足够多的「改进后的算法」,迟早能摸清这套规律,从而找到它的漏洞、卡死它、或者反向利用它。
所以结论呼之欲出:一个真正「不可被看穿」的自改进系统,不能只有一套固定的改进规则。 它必须「全身无死角」——不只是「规则」在进化,「改进规则的方法」也要进化,「改进『改进规则的方法』的方法」也要进化……一层一层,无穷无尽。
1.5 终极形态:全身无死角的改进
这就是自改进的终极形态:
不只要进化「做什么」,还要进化「怎么改进」,进而进化「怎么改进『怎么改进』」……无限递归下去。
用一句大白话说:一个理想的自改进系统,连它「用来改进自己的那套算法」本身,也必须随时可以被自己改掉。否则,那套算法就成了它的「死角」——一个它自己永远碰不到、但别人能看穿的软肋。
1.6 天花板在哪里?——第二递归定理
于是,问题终于被逼到了墙角:
「全身无死角」的持续改进,在数学上究竟可不可能?
如果可能,那它就能跨过天花板,真正实现 RSI;如果不可能,那所谓的「递归自改进」,最终会在改进若干代之后,无可挽回地开始降级。
这道天花板的答案,藏在可计算性理论的一颗明珠里。它的名字,叫克莱尼第二递归定理(Kleene's Second Recursion Theorem,简称 SRT)。
二、第二递归定理:完备的自指是可能的
在讲它之前,得先承认一件事:这个定理听起来很唬人,但它其实是整个数学里对「自指(self-reference)」这个现象最简洁、最有力的一句陈述。
2.1 理解自指的不可能性
要理解自指这个概念,首先你要看到它表面上的不可能性。这种不可能性有两重含义,一个是悖论,一个是无穷倒退。
一个东西「谈论自己」,听起来就很悬,但其实有很多例子。最经典的例子是那句古老的「说谎者悖论」:「这句话是假的」。这类例子的共同点是:自指一出现,矛盾、悖论、死循环就跟着来了。
还有一种更让人头皮发麻的「无穷倒退」:一个程序要想经过分析后改进自己,就需要首先拿到自己的源代码。如果不凭借外部文件,它就只能把源代码包含在程序自己的源代码中;而要想让源代码完整,这个内嵌的源代码也要包含完整的源代码……这就像一条蛇试图吞掉自己,引发了无穷循环的不可能性。
所以很长一段时间里,自指都被当成危险品:数学家们发明「类型分层」来禁止「自我包含」,逻辑学家划下「不能谈论自身真假」的禁令——目的都是把它关在门外。
但诡异的是,在程序的世界里,自指不但没爆炸,反而成了一件稀松平常的事。原因只有一个:程序本身就是数据。 一段源代码,不过是串字符;而任何一串字符,都能被编成一个自然数。于是「让程序拿到自己的编号」就不再是什么玄学,而是一步实打实的机械操作。你随时能在电脑上写一个「打印出自己源码」的小程序跑一跑——它不死循环、不自相矛盾,只是安安静静地把自己的样子原样吐出来,见后续章节。
这正是第二递归定理要告诉你的事:那些在逻辑世界里会引发悖论的自指,在可计算的世界里非但合法,而且必然存在。它一句话,就把「自指」从危险的悖论,变成了可以放心使用的工具。
2.2 第二递归定理到底说了什么
在进入正式介绍之前,你需要了解一个基本的事实:所有的计算机程序都可以被编码成自然数。所谓的计算机程序无非是一段符号串,就像一个长长的英文单词。英文单词可以按照字典序给所有单词赋予一个自然数,也就是这个单词在英文字典中的序号。同样地,所有的程序也可以被自然数编码。于是,「程序」和「数据」之间不再有鸿沟——程序可以作为另一个程序的输入被处理。我们把所有程序排成一列,用自然数 $e$ 编号,用 $\varphi_e$ 表示「编号为 $e$ 的程序所计算的那个函数」。这一步叫「程序即数据」,是整个第二递归定理的基础。
第二递归定理的表述有多种彼此等价的形式,其中最容易让人一下子记住的是 Roger 在 1957 年给出的表述形式(Roger 不动点形式):
对任何一个可计算的处处有定义的函数 $f$,总存在一个程序编号 $e$,使得:
$$\varphi_e \equiv \varphi_{f(e)}$$
$f$ 是任意一个「程序变换规则」:你喂给它一段程序编号 $x$,它吐出另一个程序编号 $f(x)$;而方程右侧 $\varphi_{f(e)}$ 表示的就是 $f(e)$ 这个编号对应的程序;符号 $\equiv$ 表示左右两个程序彼此「功能等价」:在一切输入上,两边要么算出相同结果,要么同时无定义。
也就是说,实际上程序 $\varphi_e$ 和 $\varphi_{f(e)}$ 都可以接受输入的数据 $x$,因此这个公式写全了,应该是:
$$\varphi_e(x) = \varphi_{f(e)}(x)$$
即对于任意的输入数据 $x$,如果有定义,那么 $\varphi_e(x)$ 和 $\varphi_{f(e)}(x)$ 都相等;否则两边都无定义。
由于所有可能的字符串与所有的自然数可以形成一一对应关系,所以上述表述中所有的程序编号你都可以理解为是程序的源代码。于是,$\varphi_e$ 就是源代码为 $e$ 的程序,$f(e)$ 也是一段源代码,是将 $e$ 经过 $f$ 的转换而得到。$\varphi_e \equiv \varphi_{f(e)}$ 表示的是源代码为 $e$ 的程序与源代码为 $f(e)$ 的程序功能等价。
之所以这个表述形式也称为 Roger 不动点形式,就是因为它和我们熟悉的迭代中的不动点类似,例如 $x = f(x)$。然而,SRT 的不同之处在于,等号不是严格意义上的数值相等,而是两个程序的功能等价。也就是说,对于任意的 $f$,一定存在一段程序 $e$,它和「被 $f$ 改造过之后的自己」——也就是 $\varphi_{f(e)}$——行为完全一模一样。 换句话说:无论你打算怎么「折腾」一段程序,总有一段程序,它「天生」就等价于被你折腾之后的样子。 这样的程序也可以看作是源代码空间中的不动点。
这样的源代码空间中的「不动点」实际上就是一大类自指程序,这些程序能够拿到自己的源代码,做任意事情(不严格地说,就是进行 $f(e)$ 操作),包括可以分析自己的源代码,在一个内嵌的模拟器上模拟自己源代码,还能够根据自己的源代码凭空再造一个自己等等。
可是,你要想严格得出这一结论,需要把第二递归定理转述成与 Roger 形式等价的 Kleene 表述形式(这也恰恰是它的最原始表述形式):
对任何一个可计算的二元函数 $g$(不一定处处有定义),总存在一个程序编号 $e$,使得对于任意的 $x$:
$$\varphi_e(x) = g(e, x)$$
这句话翻译过来就是:对于任意的可计算函数 $g$,它可以是「打印」「模拟」「计数统计」「分析」等等,都存在着一段源代码 $e$(根据 $g$ 而构造出来),使得执行 $\varphi_e$ 的结果,等价于它拿着自己的源代码喂给 $g$,并执行相应的打印、模拟、计数统计、分析等各种操作、计算。这段程序 $e$,在某种意义上「知道自己的源代码」,并且表现得「仿佛 $g$ 已经作用在它自身上了」,因此 $\varphi_e$ 就是一个自指的程序。
因此,SRT 相当于就是「自指合法」的数学许可证。
2.3 一行对角线:证明,就是自指本身
这个定理最惊人之处,是它的证明只有一行。然而,要完成这个简洁的证明,你需要一个重要的定理作为铺垫,这就是可计算理论中著名的 s-m-n 定理,也就是函数式编程中的柯里化(currying)技术。
你不要嫌弃这一大堆的名词,其实这个定理说了一个非常简单的事:任何一个二元函数,都可以把它的第一个变量固定,从而把它看作是一个一元函数。例如,如果 $f(x, y) = x + y$,则对于任意固定的 $x_0$,我们总可以定义一个一元函数 $f_{x_0}(y) = f(x_0, y)$,从而把 $f$ 参数化了。
s-m-n 定理实际上就把这件事儿更一般化了。首先,它把输入数据视作一般的 $m + n$ 维向量,其中参数部分 $x$ 是 $m$ 维,数据 $y$ 是 $n$ 维;其次,它讨论的是可计算函数,所以每一个函数都有一个程序编号。因此,$f$ 有一个可计算程序的编号 $a$,一元函数 $f_x$ 也有一个编号 $a'$,而从编号 $a$ 到编号 $a'$ 的转化是通过一个可计算函数完成的。这样,s-m-n 定理可以表述为:
s-m-n 定理:对任何一个编号为 $a$ 的 $m+n$ 元可计算函数 $f$,其中 $x$ 为 $m$ 维、$y$ 为 $n$ 维,总存在一个可计算函数 $S_n^m$ 将 $a$ 和 $x$ 映射为一个程序编号:$a' = S_n^m(a, x)$,使得:
$$\varphi_{a'}^{(n)}(y) = \varphi_a^{(m+n)}(x, y)$$
这个定理说的是,给一个双输入可计算函数 $\varphi_z$,再给定它的第一个输入 $x$,就能机械地生成一个「把第一个输入写死在程序里」的新单输入可计算函数 $\varphi_{S(z,x)}$,其中它的源代码是通过可计算函数 $S$ 根据 $z$ 和参数 $x$ 计算出来的。
好了,有了 s-m-n 定理的准备,我们就可以见证 SRT 的一行对角线证明了。接下来,我首先展示 Roger 形式的一行对角线证明。
证明:
-
根据任意编码为 $z$ 的二元函数 $\varphi_z$,我们可以根据 s-m-n 定理,构造一个可计算的二元函数 $\sigma(z, x)$,它可以由 $z$ 计算出一个程序编号:$\sigma(z, x) = S_1^1(z, x)$,使得对于任意的 $y$,$\varphi_{\sigma(z,x)}(y) = \varphi_z(x, y)$;
-
对于处处有定义的任意可计算函数 $f$,假设它的编号为 $a$,则令 $g(x, y) = f(\sigma(x, x))$ 。我们可以将 $g$ 视为关于编码 $x$ 的二元函数,即 $g$ 可计算,设其编号为 $b$;
-
显然 $g$ 是可计算的,因此存在对它的编码,设为 $b$。由步骤 1 的 s-m-n 定理,对于任意的 $y$ 有:$\varphi_{\sigma(b,y)}(z) = \varphi_b(y, z)$;
-
取 $e = \sigma(b, b)$,对于任意的输入 $x$,我们有(一行对角线):
$$\varphi_e(x) = \varphi_{\sigma(b,b)}(x) = \varphi_b(b, x) = g(b, x) = f(\sigma(b, b)) = f(e)$$
其中,第一个等号是根据 $e$ 的定义;第二个等号是根据 $\sigma$ 的定义以及 s-m-n 定理;第三个等号是根据编号为 $b$ 程序的定义;第四个等号是根据 $g$ 的定义;最后一个等号又是根据 $e = \sigma(b, b)$ 这个定义。
证毕。∎
为了清晰起见,我把这个证明中的各种代入关系总结为下图:
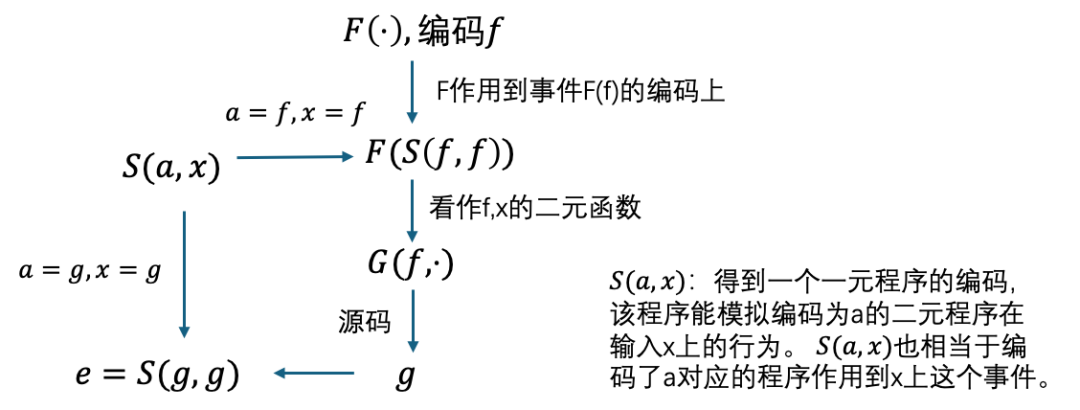
由此可见,如果你将整个证明视作一个黑箱,那么黑箱的输入有两样东西,一个是题干中的函数 $f$,它对应的编码为 $a$,另一个则是 $g$ 这个函数;输出则是一个程序的编码,即我们想要的那个不动点 $e$。
这个证明本身实际上是一系列的构造过程。被构造的有这样几个东西:
- $\sigma$ 这个二元函数,它可以由任意二元程序 $\varphi_z$ 的编号 $z$ 和视为参数的 $x$,计算得到一个一元函数的编号 $\sigma(z, x)$,使得它可以模拟编码为 $z$ 的程序在 $x$ 上的行为。实际上,你可以把 $\sigma(z, x)$ 看作一个「程序 $\varphi_z$ 应用到 $x$ 上」这个计算事件的编码器;
- 其次,是根据任意编码为 $a$ 的程序 $f$ 构造了编号为 $b$ 的程序 $g$,这其中 $x \mapsto \sigma(x, x)$ 被称为对角线程序(在 GEB 中也称为 Quine),而 $g = f \circ \sigma$ 是结合了任意额外功能编码 $f$ 后的对角线程序;
- 最后,证明的关键一步是第 4 步里那个自应用——让程序 $e$ 把自己的编号当作自己的输入而构造不动点 $e = \sigma(b, b)$。
这就是对角线方法,就是「构造自指」的方法。它和康托尔证明实数不可数、哥德尔构造「本句不可证」、图灵证明停机问题不可解,用的是同一种技术。
所以这个定理最深刻的地方在于:它的「证明」和它的「结论」是同一件事——都是「让一个程序合法地引用自己的代码」。你不是在证明「自指存在」,你是在亲手把它造出来。
由 Roger 形式和 s-m-n 定理,我们还可以推出 Kleene 形式的 SRT。
证明:
-
对于任意的二元可计算函数 $g$,设它的编码为 $z$,由 s-m-n 定理,可以得到一个可计算函数 $\sigma(z, x)$,使得对于任意的 $y$:$\varphi_{\sigma(z,x)}(y) = \varphi_z(x, y) = g(x, y)$;
-
将 $g$ 中的 $x$ 看作参数,则可以构造一个关于 $x$ 的一元函数 $h(x) = \sigma(z, x)$,显然它是可计算的;
-
将 SRT 的 Roger 形式应用到函数 $h$,则存在不动点 $e$,使得对于任意的 $x$:$\varphi_e(x) = \varphi_{h(e)}(x) = \varphi_{\sigma(z,e)}(x) = g(e, x)$。
证毕。∎
我们也可以绘制一张构造的函数和变量的相互依赖图以便于理解这段证明:
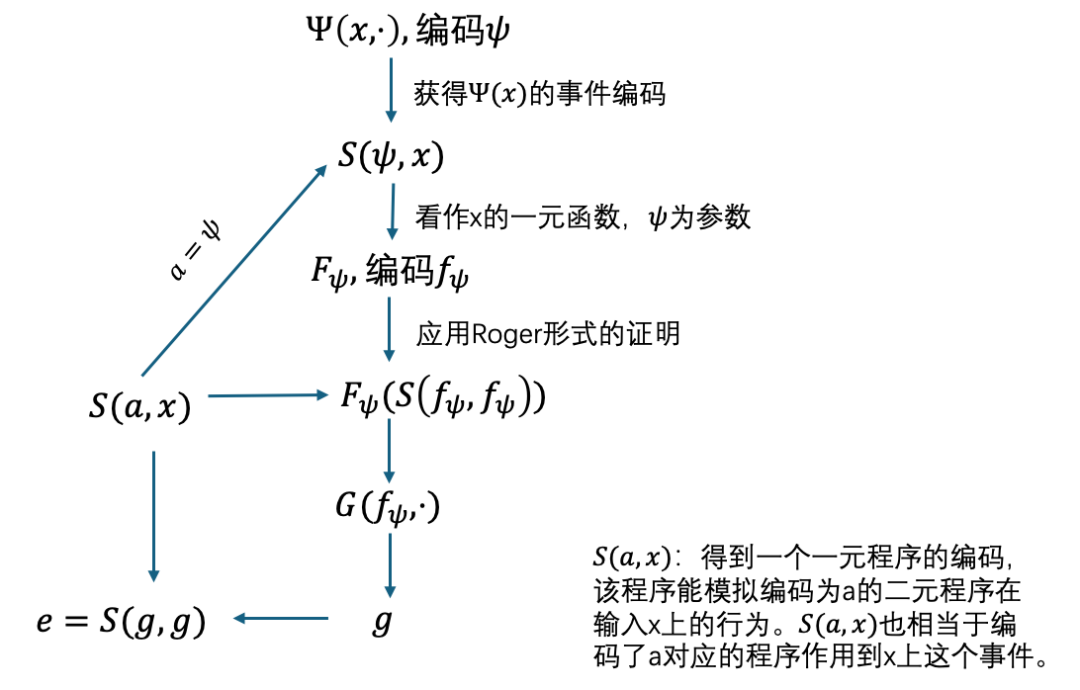
比较前后两张图不难看出,Kleene 形式的证明多出来了由 $g$ 到 $\sigma$ 这部分,后面就是套用 Roger 形式证明的部分,得到不动点 $e$。
2.4 最小内核:Quine 程序
理论太抽象?给你一个能亲手跑的最小例子——Quine 程序,也就是「打印出自己源代码的程序」。
你可以自己亲自在 Python 环境下测试一下:下面这个 Python 程序就是教科书级的 Quine,运行它,会原样打印出它自己的全部源码:
q = 'q = %r; print(q %% q)'; print(q % q)
先解释一下几个符号。%r 相当于 Python 中 repr 函数,作用是把一个对象转成「给解释器看的官方字符串表示」。print(q % q) 里的 q % q 是老式字符串格式化(% 运算符),它的一般性语法是 格式模版 % 要填入的数值。例如,如果执行 print('%r' % 'hi'),则打出 'hi' 的结果。其中,前面的 %r 是要被替换的位置,'hi' 是要替换的对象,% 是二者的连接符。
因此,print(q % q) 的意思是用 q 来替换前一个 q 中 %r 处的内容。
另外,由于字符串中的符号 % 有特殊的作用,因此它通常不能当正常的数据被打印出来。这个时候,如果要将 % 视为一个数据而正常打印,就需要在字符串中使用 %%,这样能正常打印 '%' 字符串,相当于第一个 % 是一个转义符。
总体来看,Quine 的机制极其简洁:字符串 q 里装的是一个「打印模板」,%r 会带上引号打印出 q 自己的内容。于是 print(q % q) 打印出来的,恰好就是这个程序的全部源码。程序把自己的源码当作数据、再把它打印出来——这就是第二递归定理「程序合法引用自己代码」的最小实现。
通过对比 Kleene 形式的 SRT,你会发现,这个 Quine 程序相当于是把 $g$ 定义为 print(x) 函数的一个应用结果,其中第二个参数设为空。整个 Quine 程序的源代码就是不动点 $e$。而这个不动点则是由事件「将源代码为 $z$ 的程序应用到 $x$ 上」这个事件的编码 $\sigma(z, x)$ 构成的。在 Quine 中,字符串变量 q 就相当于是证明中的 $e$;print(q % q) 是能够执行功能的程序体,并已经把 q 代入了程序体中。再来看 'q = %r; print(q %% q)' 的构成:这又是一个事件的编码,即把 print(x % x) 这个函数应用到 q = %r 这个数据上,这相当于证明中 $g$ 的源代码。其中 print(x % x) 这个函数对应了 $g$ 这个函数,q = %r 则是它的编码。总体来看,我们可以得到下面的表(注意表格中所有放到引号中的 % 符号都做了转义):
| Quine中的元素 |
SRT的Kleene形式证明中的元素 |
print(x) |
$g$ |
print(x % x) |
$g(x, x)$ |
'print(x %% x)' |
$z$($g$ 的编码) |
q = %r; print(q % q) |
$e$(不动点) |
'q = %%r; print(q %% q)' |
$\sigma(z, e)$ |
"q = 'q = %%r; print(q %%%% q)'; print(q %% q)" |
$g(e, e)$ |
更妙的是,这个 print 可以换成任意可计算操作——比如「统计字符数再打印」「对源码求哈希再打印」「把源码上传到某服务器」……只要 $g$ 是可计算全函数,SRT 都保证:一定存在一段程序,它的行为 = 「对自己的源码施加 $g$、再输出结果」。用公式写就是 $\varphi_e(x) = g(e, x)$。
所以:
Quine 是 SRT 在 $g$ = 「打印」这一个特例上的推论;SRT 则是 Quine 在 $g$ = 「任意可计算操作」上的推广。
第二递归定理给出的不是一个具体的奇技淫巧,而是一句普遍断言:任何合理的程序系统,都「封不住」自指。
2.5 SRT 是如何将不可能转化为可能的?
那么,无论是 Quine 程序,还是 SRT 的构造性证明,它们是如何将表面上看起来不可能的程序的自我包含,转化为可能的程序呢?答案就藏在一个时间步的运算里!
一段程序要实现自打印源代码,就需要借助操作系统和编译器的力量执行指令,因此从加载程序到将正确的源代码打印到屏幕上至少需要一个时间步。正是在这一个时间步里,Quine 程序做了大量的运算,包括字符串拼接、执行函数等操作,从而实现了打印出和静态程序一模一样的代码。所以,并不是 Quine 的源代码这个静态结构中天然地包含了自己的代码,而是靠一步时间运算拼出了自己的源代码,使得最后的计算效果就仿佛它先拿到了自己的完整代码,再把它打印了出来。
那么,Quine 是如何做到这种动态的拼接的呢?答案就在于 Quine 之中大量出现的「镜像」结构。我们看到,在 Quine 的源代码中,有大量诸如 x % x、q % q 这样的代码。这是早期版本的 Python 的一种语法,作用是把后面的变量代入到前面的变量之中,并替换掉 %r 处的值。它实际上完成的就是一种代入自己的操作,也就相当于是 $g(x, x)$。前面一个 $x$ 为函数,后面一个 $x$ 为数据,所以 $x % x$ 实际上得到的是代入 $x$ 的编码。我们可以认为前一个起到函数作用的 $x$ 为实体,那么后一个起到数据作用的 $x$ 就是虚像。所以 $x % x$ 所做的就是将 $x$ 的实体和虚像给放到了一起,并编码,这就相当于一次照镜子。
更有趣的是,整个 Quine 程序中有两层「镜像」结构,第一层是外层的相当于 $g(e, e)$ 的部分,第二层是定义在 $e$ 里面的相当于 $g(x, x)$ 的部分。为什么需要两层呢?由于 $e$ 是数据,它里面的内容相当于在虚拟层,这样它被执行的时候,它就会由虚拟变成真实的代码,也就是说 $e$ 中的代码的层次会提升一层。所以,在 $e$ 中必须再包含更虚拟的一层,才能够保证在层次提升的时候还能得到属于数据的虚拟层。这就是为什么要用 %r 来给整个 $e$ 外面加上一层引号的原因。
因此,概括下来,Quine 的本质实际上是一个两层的镜像结构:实体 + 虚像,而运行 Quine 程序得到的功能就是将镜像中的对象提升一个层次,让它变成实体(可执行的运算)。同时,Quine 里层的镜像结构开始发挥作用,一部分变成了虚像,另一部分则变成了真实的部分。一次 Quine 的执行运算,可以概括为如下图:
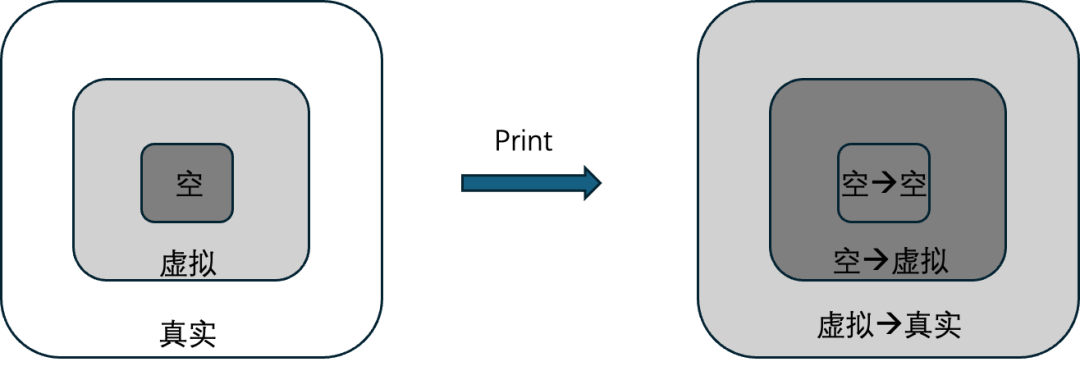
其中 print 等一系列操作相当于是一次将 Quine 中的一切对象提升一个层次,即由「虚」转「实」的操作。为了表述清楚,右图的颜色保留为左图对应对象的颜色。另外,空实际上对应的是 $e$ 中 'q = %r' 这个层次。
从上图你也可以看出,如果把整个 Quine 的运作过程看作是操作系统和编译器 $U$ 作用到了 Quine 的源码 $q$ 身上的结果,其中 $U$ 中包含了打印等操作,那么 Quine 这一构造的确就是一个普通迭代意义下的「不动点」:
$$U(q) = q$$
式子中,左边的 $U(q)$ 是打印到屏幕上的字符串内容,所以加了引号;右边的 $q$ 则是 Quine 的源代码,两边的内容一模一样。所以,SRT 中其实也蕴含了普通函数迭代的不动点(见下面的第一递归定理)。这种迭代的不动点,使得 SRT 通过运算「拿到」自己的源代码成为了可能。这就是为什么 SRT 以及 Quine 能突破看起来的不可能性的原因。
2.6 它为什么重要:一把「可计算性的瑞士军刀」
计算机科学家 Neil Jones 给 SRT 起过一个绰号:「可计算性的瑞士军刀」(A Swiss Pocket Knife for Computability)。这不是夸张。用这一个「一行证明」,就能干净利落地推出下面这些赫赫有名的结果:
-
图灵停机问题不可判定(1936):假设存在判定器 H,能判断任意程序是否停机。构造一个「跟 H 唱反调」的程序——「如果 H 说我会停机,我就死循环;如果 H 说我不会,我就立刻停机」。这个「引用自己判决结果」的循环定义,正是 SRT 把它合法化的。于是 H 无论怎么判都错,矛盾。虽然历史上图灵停机问题并不是靠 SRT 来证明的,但是应用 SRT,你可以得到对停机问题更简单的证明。
-
哥德尔不完备定理(1931):核心工具「不动点引理」(「任何性质 $P$ 都存在一个句子谈论『自己是否具有 $P$』」)是 SRT 最纯粹的推论。取 $P(x) = x$ 不可证,立刻得到「本句不可证」。
-
冯·诺伊曼的自复制自动机(1948):只要存在一台「给蓝图就造机器」的通用构造器,就必存在一台「无论输入什么都能造出自己副本」的机器。SRT 用有限指令闭合了「复制需要蓝图、蓝图又需要蓝图的蓝图」这个看似无穷倒退的循环。实际上,前面介绍的 Quine 程序就可以看作是一个简化版本的自复制程序(如果你把 print 理解为在屏幕上建造程序)。
-
自省程序(Cutland 1980):比 Quine 更强——程序不仅打印自己,还能「看见」自己、在一个通用模拟器上模拟自己的源代码,并给出分析结果。
一句话总结 SRT 的地位:它是数学中对「自指」这一现象最干净、最一般的统一陈述。 从罗素悖论到 Quine,从停机问题到自复制机,所有这些看似迥异的现象,本质上是同一种「对角线 / 自指」结构的不同化身;而 SRT,是这一原理最一般的形态。
2.7 它为什么叫「第二」?一段险些被埋没的历史
最后,聊点关于 SRT 的小八卦:你一定好奇,Kleene 是怎么发现这个定理的?它为什么又叫第二递归定理呢?
1938 年,克莱尼发表了一篇只有 6 页的短文《论序数的记号》(On Notation for Ordinal Numbers)。这篇论文的主题,表面上是给「无限队列的长度」——数学上的「序数」——设计一套机械可读的编码系统。第二递归定理,只是他在论文第 2 节末尾「顺手」陈述并证明的一个当时连名字都没有的定理,证明只有两行。
据 Moschovakis 回忆,有学生问克莱尼这个「短得可疑、巧得离谱」的两行证明从哪来的,克莱尼(也许是开玩笑地)回答说,他只是「拿着 s-m-n 的性质瞎鼓捣」(fiddled around)就鼓捣出来了。连克莱尼自己都没意识到,他挖出的是一颗珍贵的「小宝石」(little gem)。
那它为什么叫「第二」递归定理?因为克莱尼本人一辈子都只叫它「递归定理」(the recursion theorem)。直到 1967 年,Rogers 在他那本经典教材《递归函数论与有效可计算性》里首次建议:为了区分「关于函数变换的不动点」的定理和「关于程序代码的不动点」的定理,把前者叫第一递归定理(弱),把克莱尼 1938 年的这个叫第二递归定理(强)。Moschovakis 表态支持:「如果允许投票,我投 Rogers 一票。」从此,SRT 的名字定了下来。
这里值得多嘴一句「第一」和「第二」的区别,因为它是新手最常见的困惑:
| 属性 |
第一递归定理(FRT) |
第二递归定理(SRT) |
| 作用对象 |
函数本身 |
程序的编号(源代码) |
| 一句话 |
任何机械的递归定义必有可计算的(最小)解 |
任何程序变换 f 都有不动点 e,使执行代码e等价于执行代码f(e) |
| 「不动」的是什么 |
函数经变换后回到自己 |
代码变了,但行为不变 |
| 数学血统 |
Knaster-Tarski 不动点定理的可计算版 |
对角线方法的集大成者 |
| 谁更强 |
弱 |
强(强蕴含弱,反之不然) |
注意 SRT 里那个不动点的精妙之处:$f(e)$ 通常不等于 $e$(代码确实被改动了),但 $\varphi_e$ 和 $\varphi_{f(e)}$ 算的是同一个函数。所以「不动」的不是代码,而是代码的行为。
三、把自指装进自改进:构造自省式自改进程序
铺垫到这里,我们终于可以把两件事焊在一起了:RSI(递归自改进)和 SRT(自指)本质上是同一个问题。
3.1 自改进的三层阶梯:Yampolskiy 的三层自改进
自指是自改进的数学基础,但要谈「改进自己」,还需要一层更精细的分级。研究者 Yampolskiy 提出了一个很有用的三层分类:
| 层级 |
名称 |
干什么 |
典型例子 |
| 第1层 |
自修改(Self-modification) |
改自己的代码,但不保证更好 |
多态病毒 |
| 第2层 |
弱RSI(Weak RSI) |
在固定框架内优化表现,收益递减 |
神经架构搜索、几乎所有现有LLM自改进 |
| 第3层 |
强RSI(Strong RSI) |
改进「改进的能力」本身,潜在无上限 |
哥德尔机(理论上) |
弱 RSI 和强 RSI 的分水岭,就是「改进机制本身有没有被改进」。几乎所有今天我们能看到的「自进化 LLM」,都停留在第 2 层:它们用的是人类预设好的机器学习算法去优化任务表现,而那套算法本身,从来不被自己改动。这,正是前文说的「死角」。在本文中,我们说的终极递归自改进就是 Yampolskiy 所说的强 RSI。
3.2 用 SRT 构造「全身无死角」的自改进程序
那么,「全身无死角」的第 3 层,数学上能不能造出来?能,而且方法出奇地优雅,只需三步:
第一步,先造一个「会照镜子的程序」(自省程序)。 取 $Sim(x, t)$ = 在通用机器 $U$ 上把程序 $x$ 模拟最多 $t$ 步。这是一个全可计算函数(因为 $t$ 是有限上界,模拟一定结束)。把它塞进 SRT,得到不动点 $e$:
$$\varphi_e(x) = Sim(e, x)$$
翻译过来:程序 $e$ 的行为 = 在 $x$ 步内模拟 $e$ 自己的源代码。 它会「看见」自己。Cutland 在 1980 年给这类程序起了一个名字:自省程序(introspective program)。
第二步,在「照镜子」后面接上「动手改造」。 把变换规则升级为三段的复合:
$$F = Modify \circ Evaluate \circ Sim$$
其中 $Sim$ 是有界自模拟(照镜子),$Evaluate$ 是评估函数(给镜子里的自己打分),$Modify$ 是修改算子(根据打分动手改代码)。再把 $F$ 塞进 SRT,得到不动点 $e$:
$$\varphi_e = F(e) = Modify(Evaluate(Sim(e, T)))$$
这就是一个自省式自改进程序(Introspective Self-Improving Program,简称 ISIP):运行 $\varphi_e$,就等于「在 $T$ 步内模拟自己的源码 → 评估这段模拟的表现 → 据此修改自己的源码」。
第三步,让这个过程递归下去。 把 $e$ 记作 $P_0$,它的执行会吐出一段新源码 $P_1$,记作 $P_1 = \varphi_e$ 的输出;$P_1$ 再吐 $P_2$……于是自动得到一条程序序列:
$$P_0 \longrightarrow P_1 \longrightarrow P_2 \longrightarrow \cdots$$
每一步,新程序都是对前一个程序的改进。这就是形式化的「递归自省式自改进」。
请注意这里的精妙之处:第二递归定理只用了一次——用来把第一个自指程序 $e$「召唤」出来。一旦 $e$ 存在,后面整个改进序列是自动的、遗传的,不需要任何新的「自指动作」。(用数学的话说,SRT 的 uniform 版本保证存在一个统一的程序 $r$,把「找到不动点」这件事做成一个机械流程。)
3.3 完备性与反射结构的必要性
这个构造有一对漂亮的「对偶」性质,直击「全身无死角」的题眼。
完备性(Completeness):从标准形式的 ISIP 出发,任何一段源代码都能在有限步内被达到——不仅任务逻辑能改,连「决定如何改的元机制」本身也能改。换句话说,这个系统里没有任何一个区域是结构上「改不到」的,包括它自己的改进引擎。这正是「强 RSI」的定义性特征:改进机制本身可以被改进。
反射结构的必要性(Necessity of the Reflective Structure):反过来,一个有限的、自包含的、具备「完全定向自修改」能力的系统,必然会呈现出一种「反射结构」——一个可执行的「身体」 $\varphi_q$ + 一份描述整个身体的「生成式描述」 $q$ + 一个能读懂并展开这份描述的「解释器」。也就是说,「身体 + 蓝图 + 解释器」这三件套,不是冯·诺伊曼偶然的设计癖好,而是任何能完全自我修改的系统的必然形态。
把这两条放在一起,我们得到了一个漂亮的等价:
「完整的定向自修改」 ⟺ 「反射式自省结构」。
关于自省自改进程序的更多讨论请参考我们的论文:https://www.mdpi.com/1099-4300/28/9/951
3.4 三个关键因素
从 SRT、Quine 到 ISIP,我们可以提炼出三个贯穿始终的关键因素:
-
自反射结构(reflexive architecture):一段代码被「镜像」在两个域里——一个被动的、携带数据的「描述」域,和一个主动的、可执行的「功能」域。没有这个双份镜像,自指就闭合不起来。
-
支撑环境(supporting environment):反射系统的边界,必须相对于它底层的解释器/操作系统来精心划定。把越多能力塞进自指程序本身,灵活度越高,但结构复杂度也越高;把越多能力外包给环境,核心越简单,但自适应能力越受限。
-
通用计算与自指的关系:正是「通用计算」(通用图灵机、通用解释器)给了自指以栖身之所。SRT 之所以成立,本质是因为「程序即数据、数据即程序」的通用性让对角线得以闭合。
四、为什么迟迟造不出来:实践中的困难
既然理论上这么漂亮,为什么今天没有一个类似哥德尔机、ISIP 这样的自指自改进程序在跑呢?
4.1 哥德尔机碰壁
哥德尔机是早在 2003 年就提出来的一种自指的自改进程序,但却迟迟没有实现。原因不在原理,而在工程:它要求机器在每一次自改之前,都能在自己的形式系统里证明「这次改动全局最优」。这需要一套完整的、机器能自证的自描述公理系统 + 一个足够强的证明搜索器。前者极易出现自指悖论(Löb 定理告诉你,一个一致的系统无法证明自身的健全性),后者在现实算力下根本搜不动。于是,几乎所有后来者都「降级妥协」:把「证明最优」换成「统计近似」,把「自我验证」换成「外部基准分」。
4.2 自反射结构的代价:复杂度翻倍与脆弱性
更深层的困难,藏在反射结构本身。
回想它的定义:同一段代码要在「描述域」和「功能域」里镜像两份。这带来一个直接的后果——每增加一个新功能,都得在两个域里各写一遍,结构复杂度以「翻倍」的速度增长。 而且,这种双份镜像高度依赖「描述」与「功能」的精确对齐,任何一点随机扰动(比如一次随机的代码突变)都可能打破这个对齐,让整个闭环瞬间崩坏。换句话说:反射结构天生是脆弱的。
这也解释了一个谜团:为什么理论上最完备的架构(哥德尔机)恰恰是最难实现的?——因为「无约束的自指能力」和「结构简洁性」是一对不可兼得的矛盾。想全能,就得付出复杂度翻倍、脆弱性飙升的代价。
4.3 自指真的必要吗?
一个值得认真对待的反问是:要「改进自己」,真的必须拥有完备的自指结构吗?
自复制机器的研究给了我们一个清醒的提醒:实现自复制,并不一定需要完备的自指。 Langton 的元胞自动机「自复制环」、Byl 的小型自复制机,都比冯·诺伊曼那台庞然大物简单得多——它们牺牲了「通用构造」能力,换来了极简的闭环。这说明:
「改进算法的能力」和「自指能力」,其实是两个垂直(正交)的维度。 你可以有很强的自指却不擅长改进,也可以有很强的改进却只具备残缺的自指。
于是出现了一条务实的中间路线——近似的反射结构(approximate reflective structure):不强求「符号级」的精确自指,而是用神经网络 Quine、超网络(hypernetwork)等手段,实现一种连续、近似的自反射。它足以支撑一段时间的递归改进,却无法提供完备自指那种「形式化安全保障」——连续近似下的递归自改进,其动力学稳定性是没有保证的。
4.4 内嵌的自反射结构:LLM 里藏着自指吗?
还有另一条更诱人的路:也许自指不必从外部「搭」出来,它可能已经「藏」在一个大系统(比如 LLM)的内部。
这就把话题引向了当下最热的问题:今天的大模型,到底有没有真正的自省能力? 我们那篇 2026 年 Entropy 的论文对近年文献做了系统梳理,结论可以用一个词概括——准自省(quasi-introspection):
| 自省组件 |
当前 LLM 的现状 |
| 自我建模(知道自己会什么) |
部分:有统计校准、能识别「已知/未知」实体的特征 |
| 自我模拟(预测自己的行为) |
弱:只有低维的「元认知空间」,缺乏「特权访问」 |
| 自我评估(发现自己的错误) |
不可靠:会出现「元认知幻觉」,越反思越错 |
| 自我修改(定向改进自己) |
浅层:迭代几次就饱和,且只停留在代码层面 |
换句话说,今天的 LLM 会「谈论」自己(能说「我不确定」),但那更多是从训练语料里学来的语言惯例,而非对自身执行过程的真实访问。研究者 Song 等提出过一个犀利的判据:真正的自省,要求智能体获取自身内部信息的机制,必须比「第三方从外部观察」更可靠、更廉价。 按这个标准,绝大多数所谓的「LLM 自我认知」都够不上自省,只能算「自我叙述」。
从结构上看,造成这个差距的瓶颈至少有三个:
-
没有反射结构,就没有完整的自我访问:一个裸 LLM 的全部「功能身份」都在权重张量里,而权重是连续的数值、不是离散的符号,且张量规模远大于上下文窗口。它没有一个「能精确重建自身」的蓝图——就像一台没有蓝图的冯·诺伊曼机,无法预测自己改动后的算法后果。
-
前馈架构的局限:标准 Transformer 是前馈的,单次前向传播被限制在均匀 $O(1)$ 复杂度内,无法执行「不动点迭代」。而真正的自省需要任意深度的递归嵌套。思维链(CoT)只能算「时间上的循环」,作用在 token 轨迹上,而非权重级的函数动力学上。
-
自我报告缺乏因果根基:模型说「我不确定」时,未必在做真正的元认知监控,可能只是复述了语料里人类表达不确定的句式。
那么如何发现、或逼近这种「内嵌的自反射结构」?论文给的方向包括:外置的自我模型(把「自我卡片」做成显式、可改的数据结构)、递归与迭代架构(Universal Transformer、Perceiver 等)、以及寻找 Transformer 内部隐藏的「近似反射核心」(如 Luppi 等提出的「协同核心」假说)。但所有这些「解耦」的近似方案,都有一个共同的局限:它们只能抓到高维系统的低维投影,据此优化,可能会把系统带进「认知盲区」。
虽然今天的研究里,人们并没有按照自指的方式去构建 LLM,但这并不意味着 LLM 原则上不能具备自指能力。根据 SRT,我们看到,要构造一个完备的自指程序并不是什么难事,关键是环境需要支持通用计算,而大量的研究已表明 LLM 是支持通用计算的,甚至于在 Prompt 层就是图灵完备的。所以从原则上讲,LLM 是可以构造完备自指的。但是,具备这种能力,和真正实施了这种能力并不是一回事儿。
这里值得岔开一句:如今各家大模型的能力边界仍在快速扩张,但「能调用 Claude、GPT、Gemini 的 API」和「能对自身执行过程做有界自模拟」完全是两回事。前者是工程接入问题,后者才是自指结构的问题。
如果我的判断——终极 RSI 要拼的是自指能力——是对的,那么让 LLM 具备 SRT 式的自指能力就是一个关键性的问题了。
结语:那根「自省的线」,正是天花板本身
回到开篇那个问题:递归自改进,到底有没有天花板?
有的。而且这道天花板的数学本质,就写在克莱尼第二递归定理里。
- 冯·诺伊曼告诉我们:自复制需要一个完整的结构性自我描述(身体 + 蓝图 + 解释器),越不过这个「复杂度阈值」,复制就是退化性的。
- 我们 2026 年 Entropy 的论文顺着同一条思路推下去:自改进需要的是一个完整的功能性自我模型——一种能够模拟自己的执行过程、发现自己内部错误、预测自己改动后果的能力。它把这个能力叫作自省,把对应的复杂度阈值叫作自省阈值。
第二递归定理则一劳永逸地保证:这样的自省程序,在数学上「存在」——它甚至和 Schmidhuber 的哥德尔机等价。但「存在」是一回事,「造出来」是另一回事。反射结构的复杂度翻倍与脆弱性、Rice 定理给出的「改进不可判定」、Löb 定理划下的「无法自证健全」、以及今天 LLM 前馈架构与连续权重的先天限制——它们共同解释了,为什么我们离那根线,还有相当的距离。
而这条线的另一头,站着更深刻的东西:自指,或许是理解生命、智能与意识共同钥匙的那把钥匙。 第二递归定理,只是这把钥匙上最亮的那一颗齿。
那颗被克莱尼在 1938 年一篇 6 页短文里「顺手」挖出、又差点被埋没的「小宝石」,八十多年后,成了我们讨论「机器能否自己进化自己」时绕不开的起点。这也是云栈社区上持续引发热议的话题之一——从可计算理论到 LLM 自省能力,不同背景的开发者总能在这里找到交锋的切入点。
参考文献
-
Deli Chen (2026). Never Stop Learning: A Survey of Continual Learning and Self-Iteration in Large Language Models. https://victorchen96.github.io/auto_research/continual_learning_survey.pdf (LLM 自我迭代与持续学习综述)
-
Kleene, S. C. (1938). On notation for ordinal numbers. The Journal of Symbolic Logic, 3(4), 150–155.(第二递归定理的原始出处)
-
Kleene, S. C. (1952). Introduction to Metamathematics. D. Van Nostrand.
-
Rogers, H., Jr. (1967). Theory of Recursive Functions and Effective Computability. McGraw-Hill.(第一/第二递归定理的命名来源与标准表述)
-
Cutland, N. J. (1980). Computability: An Introduction to Recursive Function Theory. Cambridge University Press.(自省程序的原始定义)
-
Moschovakis, Y. N. (2010). Kleene's amazing second recursion theorem. The Bulletin of Symbolic Logic, 16(2), 189–239.(SRT 的权威综述,18 个应用)
-
von Neumann, J. (1966). Theory of Self-Reproducing Automata (A. W. Burks 编). University of Illinois Press.(自复制自动机与「复杂度阈值」)
-
Good, I. J. (1965). Speculations concerning the first ultraintelligent machine. Advances in Computers, 6, 31–88.
-
Yampolskiy, R. V. (2015). From Seed AI to Technological Singularity via Recursively Self-Improving Software. arXiv:1502.06512.(三层自改进分类)
-
Schmidhuber, J. (2003/2007). Gödel machines: self-referential universal problem solvers making provably optimal self-improvements.(哥德尔机)
-
Zhang, J., Yuan, B., & Zhang, Q. (2026). Self-Referential Introspection in Large Language Models: The Critical Threshold for Recursive Self-Improvement. Entropy, 28(9), 951.(本文的核心理论来源:自省阈值、ISIP、与哥德尔机的等价性)
-
Shumailov, I., et al. (2024). AI models collapse when trained on recursively generated data. Nature, 631, 755–759.(模型崩塌)
 发表于 昨天 21:44
|
查看: 4|
回复: 0
 /1


