来源:How Thorsten Ball Uses Amp, Amp Chronicle / YouTube;作者:Thorsten Ball;日期:2026 年 10 月;形式:客户内部分享 / Amp Chronicle
2026 年 10 月,Thorsten Ball 在一家大银行做完内部分享后,把同一份 deck 录成了 34 分钟视频。它比他在 X 上发的 "How I work with Agents" 长 thread 更完整:不只是个人 Prompt 技巧,而是把 Agent、代码库、开发流程当成一个整体来重新设计。整段分享的核心论点是:Agent 和模型已经把软件开发的一些基本常数改了——如果还按 2016 年的流程套一层 "Agent 代写代码",就看不到别人正在看到的生产力跃迁。
1. 世界观:软件变便宜了,"烂代码堆积论" 不再成立
Ball 开场就说,他没法不谈自己怎么看世界,就直接讲怎么用 Amp。在他看来,Agent 和模型让软件的生产、修改、调试、迭代都变便宜了,以至于过去 30 到 50 年形成的那套实践和流程需要重新想。修 Bug 的时间、做一次改动的时间、能共享的原型数量、甚至 "买 vs 建" 的决策,这些常数都在变。
他举了两个小例子。一个是 feature flags:他职业生涯里一直觉得 feature flags 很烦,就是几个布尔值也怕写错;但有了 Agent 之后完全变了。另一个是 Grafana charts:以前得自己定义,现在 Agent 能直接帮你做。这些以前让人觉得 "不值得做" 的小事,现在变得触手可及。
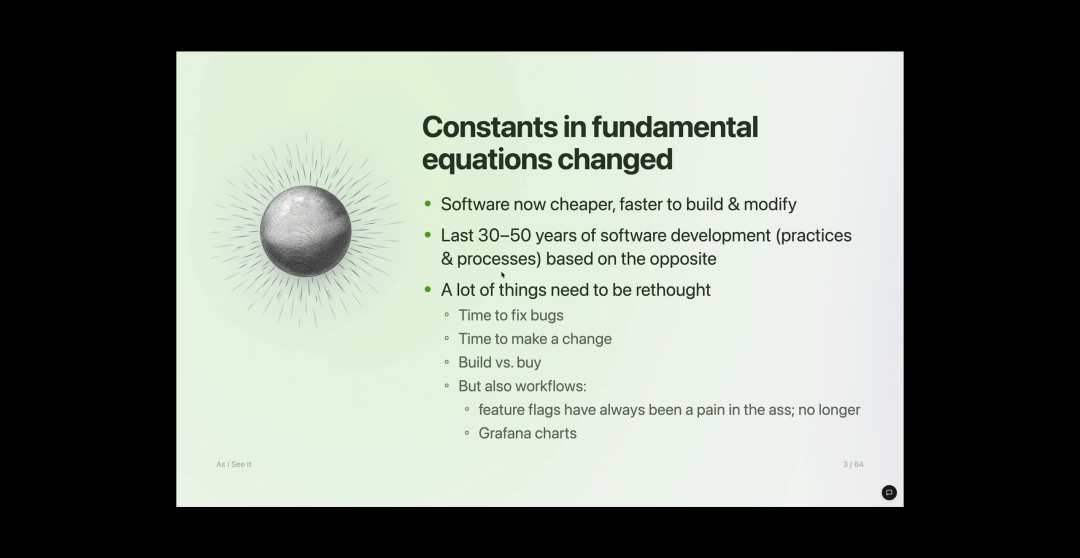
比静态能力更重要的是 变化速率。Ball 用 1999 年的 AAA 游戏打比方:如果你知道等游戏做完时 CPU 会快一倍,那现在的设计就必须考虑这个进度。今天也一样——token 成本在下降、模型发布周期在缩短(从年初的 "每两个月一个 frontier model" 到现在有人说 "每两周"),甚至半年后做同一件事可能更便宜更快。把 Agent 当静态工具来评估,会错过这个变量。
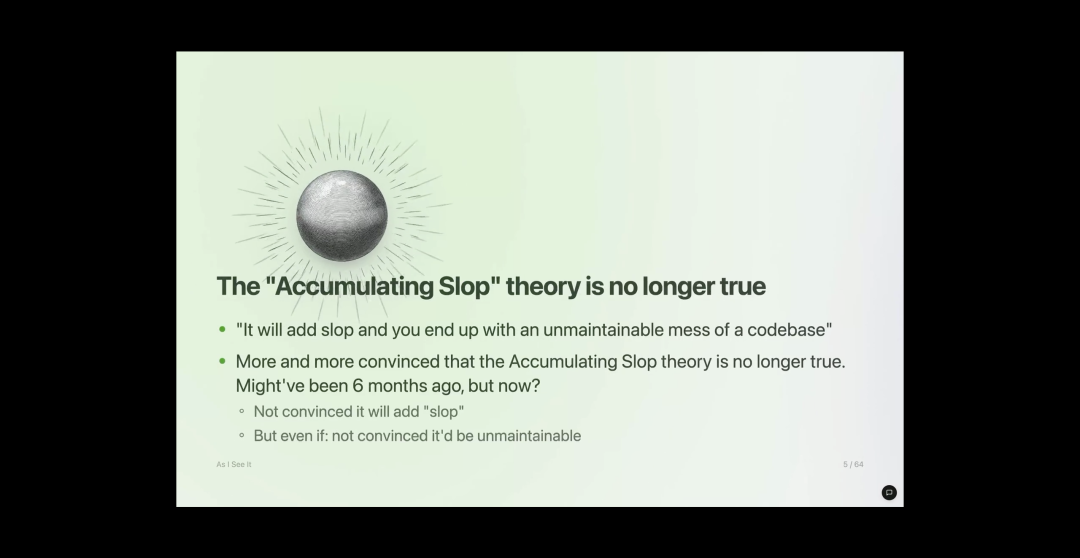
顺着这个逻辑,他明确否定了 "Agent 会让代码库堆积 slop、最终不可维护" 的说法。他认为现在的模型(比如他当时在用的 Opus 5.5)已经强到可以帮你清理烂代码;即使产生了 slop,也不意味着结果不可维护。
2. Prompt 的层级变了:从 How 到 What
Ball 认为,去年的 Prompt 工程(文件顺序、@ 文件位置)已经不需要了。Amp 的 web、macOS 和 iOS 客户端已经去掉了 @ mention。现在的 Prompt 应该是高层目标,而不是实现步骤。
他给了三个自己的例子:
- "把字节码编译器和 VM 做到 2 倍快。"
- "给我建一个像这样的项目。"(他放了几张截图,Agent 据此做了一个浏览器 router。)
- "能不能在这个在线侧边栏里加一个很小的 mini chat?"(他说是自己在手机上口述的,Agent 直接做完了。)
这些任务里没有 "先改这个文件、再改那个函数" 的指令。Ball 的结论是:别再说 'How',说 'What'。
但做到这一点需要同时改造另外两件事:代码库和流程。他称之为 Triad:agent / codebase / process。
他把 "把 Agent 框在文本编辑器里" 比作 GDP 不涨的原因:如果只是把 "人打字" 换成 "Agent 打字",然后 push、review、CI 全部照旧,那就浪费了 Agent 的潜力。必须让 Agent "横向展开",看到比文本编辑器多得多的东西。
3. 让 Agent 横向展开:覆盖整个 SDLC
"横向展开" 是这次分享里最鲜明的组织设计。Ball 说 Agent 已经能很好地做垂直栈(前端、后端、数据库、基础设施),现在要让它覆盖整个软件开发生命周期:
- 帮你做原型、做功能;
- 能部署、能切 release;
- 能判断上线是否顺利;
- 能看 CI、读生产日志、在生产环境里调试;
- 能看监控指标、能开 feature flags。
他反复强调这是 "真正、真正、真正的游戏规则改变者"。为了让 Agent 能做到这些,Amp 内部写了一系列插件:bug 报告、用户邮件、system health、feature flags、用户补偿等等。这些插件把 Agent 接到了公司的现实里。
4. Amp 自己怎么建 Amp:一个 AI-native 团队的数据点
Amp 本身是他这套方法论的产物。Ball 说 Amp 是 "99% AI 写的",而且是一个 TypeScript monorepo,从 2025 年 2 月开始做的时候就有资深工程师用 AI。代码量已经超过 200 万行。今年年初他们因为 Cloudflare Durable Objects 的问题做了一次大重写,切换平台后重新上线;之后上线了 Orbs 和 cloud agents,团队速度 "像疯了一样" 提升。
他展示了一张 velocity 图:重写期间速度下降,Orbs 之后 commit velocity 明显上扬。这个数据点的意义不只是 "AI 让开发更快",而是 当基础设施让 Agent 能随时 spawn 线程、端到端跑任务时,团队节奏会质变。
5. Ball 个人的工作流
5.1 模型与输入
Ball 只用最新最强的模型,当时的主力是 Opus 5.5。他不认同为了省钱用更便宜的模型:你不知道它会在哪出错,结果往往要更多轮对话、更多检查,反而更贵。他还开始用 dictation(口述)——虽然妻子走进房间时他会觉得有点尴尬,但口述能移除一个瓶颈,而且说更多上下文对 Agent 有帮助。
5.2 不再手动管理上下文
Amp 在过去半年移除了很多上下文管理功能。去年他们还很骄傲地做了 handoff 和 thread map,让用户看到用了哪些上下文;现在 Ball 认为这些已经过时。他建议:别再去想 "现在用了 300k 还是 380k token"。 Compaction 已经够好,手动管理上下文是浪费时间。一个 thread 就是一个任务,有的只有 46 条消息,有的 3,714 条。
5.3 不写给人读的文字,但写机械性文字
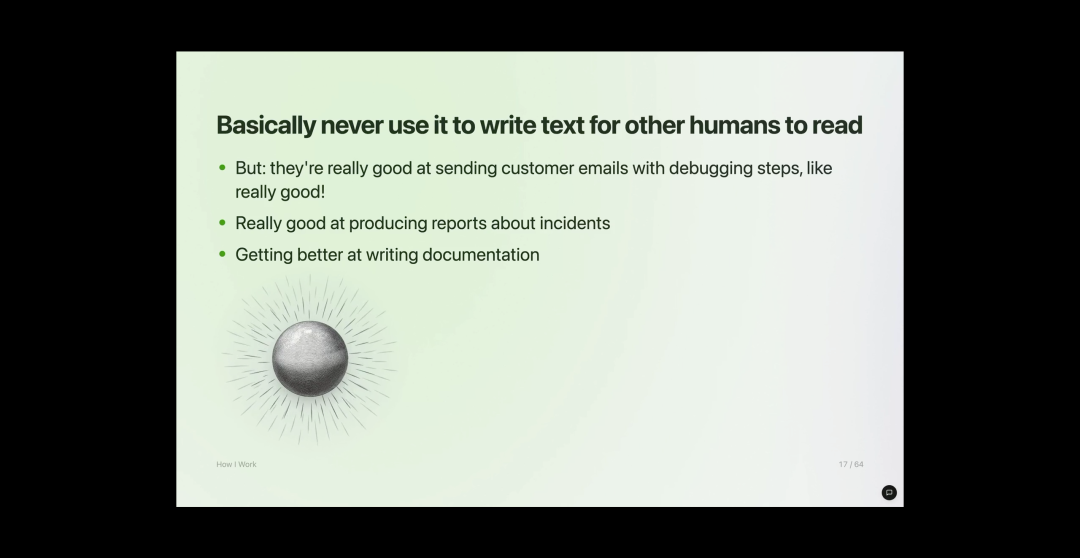
Ball 不愿意让 Agent 写给人读的文字——他自己看 Agent 写的东西会 "眼神发直",所以不想让别人也经历这个。但 Agent 很适合写 机械性文字:客户调试邮件、事故报告、参数文档。只要另一端的人不 care 是不是真人写的,就可以交给 Agent。
5.4 Automations / Schedules:被低估的杀手功能
Amp 的 automations(也叫 schedules) 让用户可以告诉 Agent "两小时后再检查"。Ball 说他之前没意识到这有多重要,直到有次坏了一天才发现离不开。他每天会跑一些固定检查,也会用 "两小时后再看 error rate 有没有下降" 这种方式。他还常用 snooze until next message,让 sidebar 只在 Agent 有新消息时才出现,保持干净。
5.5 不要等 Agent,让 Agent 等你
这是 Ball 的口头禅之一。他说如果你总在等 Agent、开八个面板监控它们,那就做错了。Agent 可能跑 20、30、45 分钟,你应该做自己的事,轮到你了再去看。他把自己的 sidebar 形容成 "一堆未读消息和从 Slack 发起的线程",他正在录这个视频,那些 Agent 在后台跑。
5.6 批量要变体,而不是来回迭代
既然 Agent 不是人,你就可以提一些对人来说很无理的要求。Ball 举了在飞机上去纽约的例子:他发现一个 dial icon 在一个 pill 里没对齐,自己也不确定问题在哪,于是让 Agent "生成多个可能的修复变体,并给我一个能挑选它们的小页面"。Agent 做了 A/B/C/D 几个截图,他最后选了 B。这个做法同时适用于解空间和问题空间——比如 "给我 4 个这里变慢的理论,然后四个都验证一遍"。
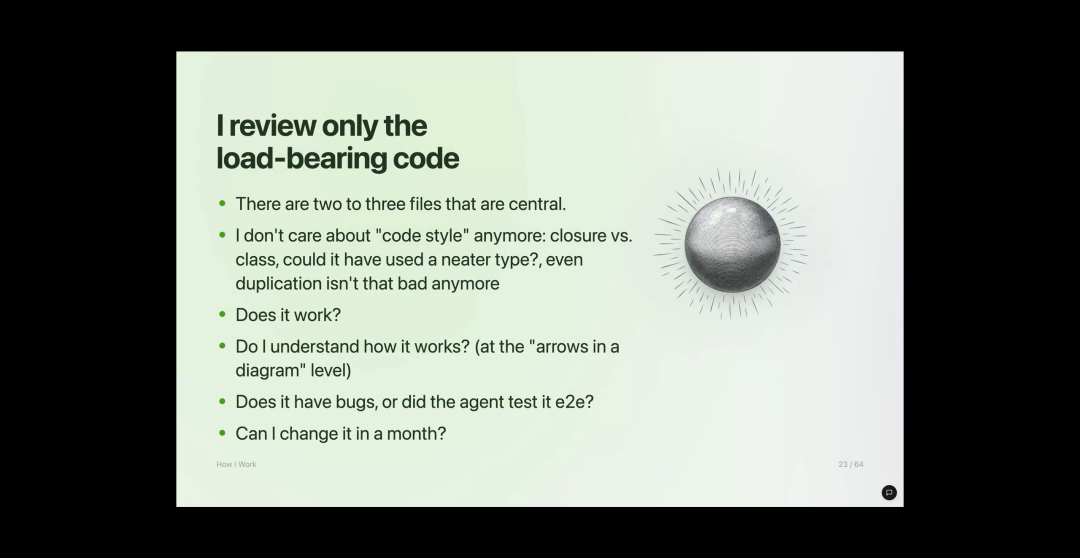
6. 审查:只看 load-bearing 代码
Ball 说他只 review "承重代码"。他换了一个角度解释:如果别人让你 review 500 行代码,但什么都没给,你只能硬看;但如果对方同时给了 end-to-end 演示视频、测试矩阵、日志、不同栈上的验证,你审查的方式会完全不同。
所以他要求 Agent 先做大量工作来证明 "这东西能跑"。然后他问自己四个问题:
- 它能跑吗?
- 我理解它的思路吗?(到 "架构图箭头层面" 就够了)
- 它有 Bug 吗?Agent 有没有端到端测试过?
- 一个月后我还能改它吗?
核心文件只有不到 5 个,那些他才看。CSS 错误和数据库迁移错误不是一回事。
7. "Give me irrefutable proof"
Ball 说这是过去半年最大的游戏规则改变者。因为 Amp 有 Orbs(每个线程一个的 ephemeral 远程机器,scale to zero),Agent 可以在里面随便安装工具、跑 build、截图、录视频。他只要说一句 "给我无可辩驳的证据证明这现在能跑",Agent 就会自己把证据做出来。
他展示了几个真实例子:
- 一次重构 touching 了仓库里最承重文件之一,Agent 起了 dev server、写了脚本、spawn runner、做完整端到端测试,最后给出 "main 和 refactor 之间没有行为差异" 的测试矩阵。
- 一个 "queued messages reordering" 功能,Agent 录了视频作为证明。
- 一个 macOS 权限对话框相关改动,Agent 给了 end-to-end 截图。
- 一个性能优化任务,Agent 给出不同改进方案的速度对比表。
8. 让代码库对 Agent 可读
Ball 认为,什么止住了 Agent 的幻觉?是 tool calls。 因为 Agent 能触碰现实,能检查文件是否存在、能跑命令,所以不再瞎猜。代码库必须对 Agent "可读":能起 dev server、能停、能注入 seed data、能跑 REPL——至少要只读可见。
Amp 仓库里有 15 个 AGENTS.md 文件,针对不同子系统给 Agent 不同指令;还有 dev server、GCloud、BigQuery、RivetKit 等 skills。Ball 强调,只编码固定 workflow 不够,还要给 Agent 工具并解释这些工具怎么用。
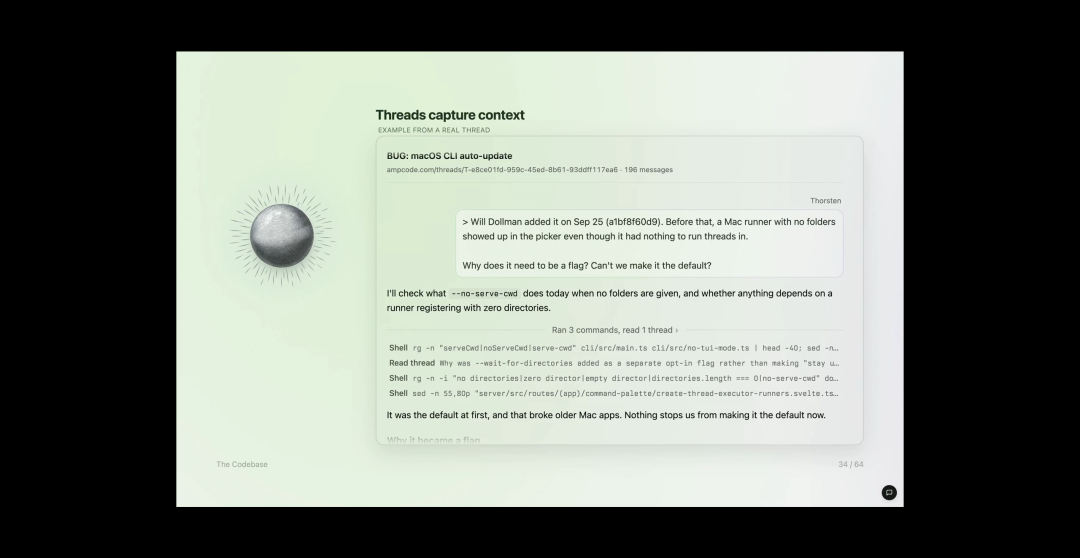
另一个重要资产是 Threads。Amp Threads 捕获了上下文,Agent 可以读取历史线程来回答 "我们为什么这么做"。他展示了一个真实线程:他问 "为什么这里要加 flag,能不能改成默认?" Agent 读取了 Will 在 9 月 25 日提交对应代码的线程,找到了原因。
9. All in on Orbs:不再本地开发
Ball 说 Amp 团队已经完全不用本地开发了。Orbs 是标准化的共享环境,每个人都有同样的 setup;知识累积在代码库里(AGENTS.md、skills、scripts、文档),也累积在 Amp 的 threads 里。当某个同事搞懂了 "怎么在 Orb 里做 iOS 录屏",他会写成 skill 或脚本,第二天所有人都能用,不用自己装任何东西。
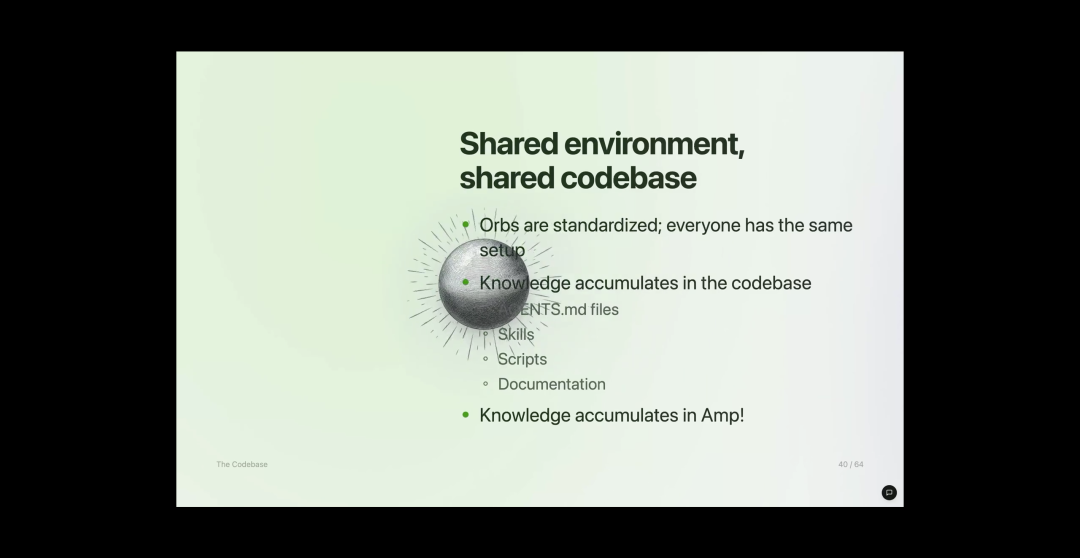
Orbs 是 ephemeral 的,每个线程一个,空闲时 scale to zero。Agent 可以在里面装 Python、FFmpeg、不同 server 等任何东西,不用担心把 Mac 塞满。Ball 录这个视频的 deck 就是在一个 Orb 里做的,他甚至不知道动画和布局引擎是怎么实现的。
他们也用 Runners:Runners 是跑在自己机器或某台固定机器上的有状态环境,适合需要本地 macOS 的东西。比如 macOS app 本身就是一个 Runner,Orbs 里的线程可以 spawn 一个线程到这台 Mac 上调试 iOS app,然后来回传文件和报告。
10. 让 Agent 看到生产
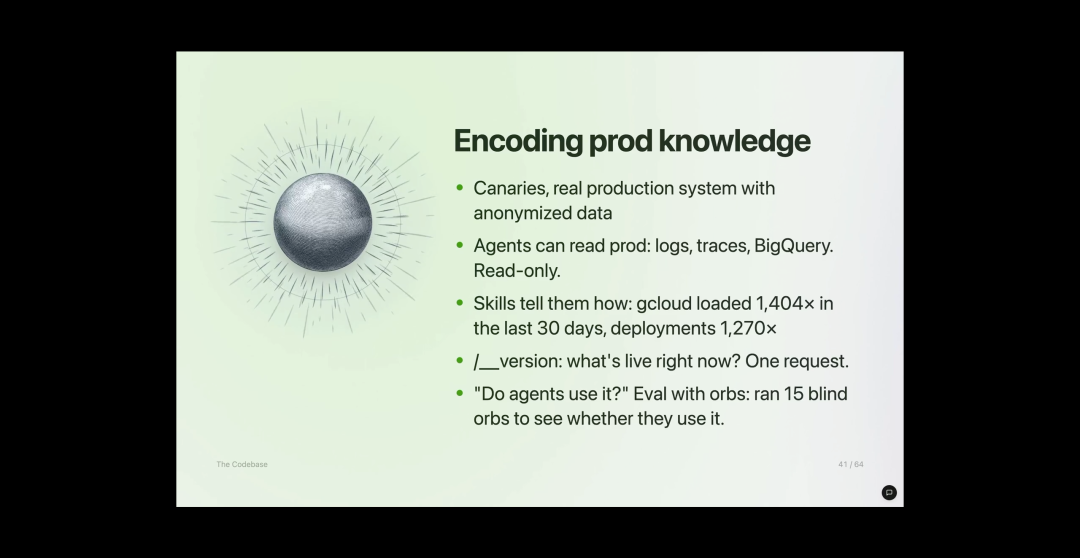
代码库可读还不够,还要让 Agent 看到生产。Ball 说 Amp 把生产知识也编码进了代码库:
- Canaries:用真实生产系统 + 匿名化数据,专门给 Agent 用。
- Agent 可以只读访问 logs、traces、BigQuery。
- Skills 教 Agent 怎么查:比如 gcloud skill 过去 30 天被加载 1,404 次,deployments skill 1,270 次。
/__version 接口让 Agent 一次请求就知道现在线上跑的是哪个版本。
他把这个做法类比成 "十年前有人会说 '你怎么为了测试改代码?'"——现在他们为了 Agent 在生产路径里放只给 Agent 用的数据和代码,因为想让 Agent 能看生产。
11. 流程:push to main,没有 PR
Amp 从第一天就是 AI-native:senior 工程师用 AI,所有流程都围绕这个前提设计。他们 直接 push 到 main,没有 PR。理由很直接:
- 他们 dogfood,Bug 修得快;
- 有 feature flags,风险可控;
- 让 Agent 先在 Orb 里跑 20 分钟 CI,再 push 上去又跑 20 分钟 CI,"这太疯狂了"。
Ball 说 PR 系统对 Agent 来说是坏的。设计师也不再只画 Figma,而是直接在 Orbs 里写原型、迭代、ship、fix。
12. 从 Bug 报告到用户回访:一条 Agent 链路
Ball 用一个具体流程展示了 "流程为 Agent 设计" 是什么意思。Amp 里用户报 Bug 时,会收集客户端和服务端的 diagnostic bundle,自动发到 Slack,然后任何人都可以一键从这个 Bug 开一个 Agent thread。Agent 拿到 bug report ID 后,能读取全部数据、诊断、修复、验证;之后还可以自动发邮件给用户致谢、说明修复内容、必要时给 credits。
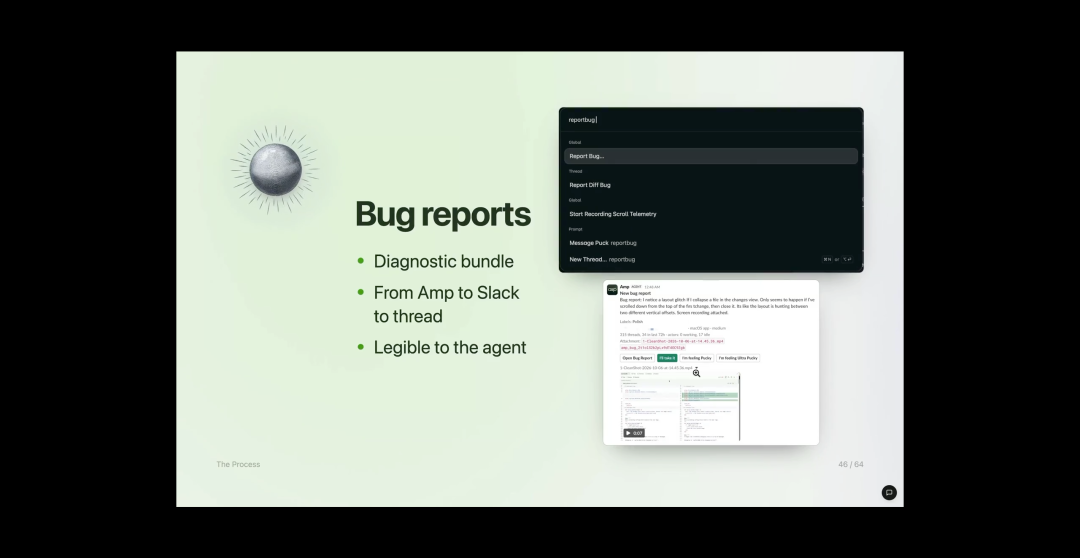
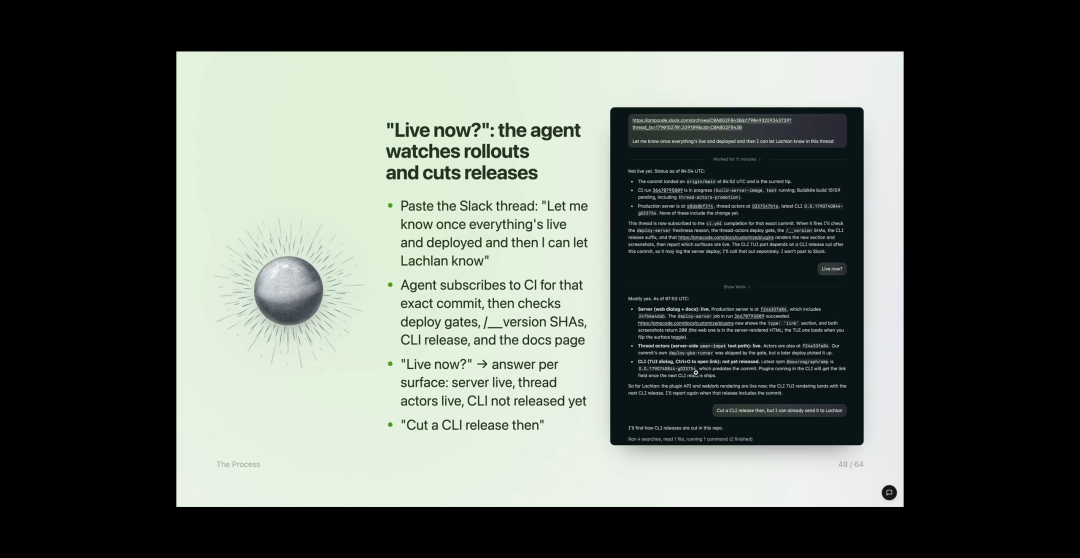
Agent 还会 watch rollout 和 cut release。他展示了一个 Slack 线程:有人问 "这个功能上线了吗?" Agent 订阅了对应 commit 的 CI,检查 deploy gates、版本 SHA、CLI release、docs page,然后分 surface 回答:server 已上线、thread actors 已上线、CLI 还没 release。最后 Ball 说 "那切一个 CLI release",Agent 就去做了。
事故响应也是一样。Amp 经历了一个艰难的 8 月之后,他们做了一个 get system health 插件,能查询所有监控和日志 API。现在每次告警,大家第一件事就是问这个插件 "系统健康吗?"
13. Eval agent-friendliness:用 Agent 验证 Agent
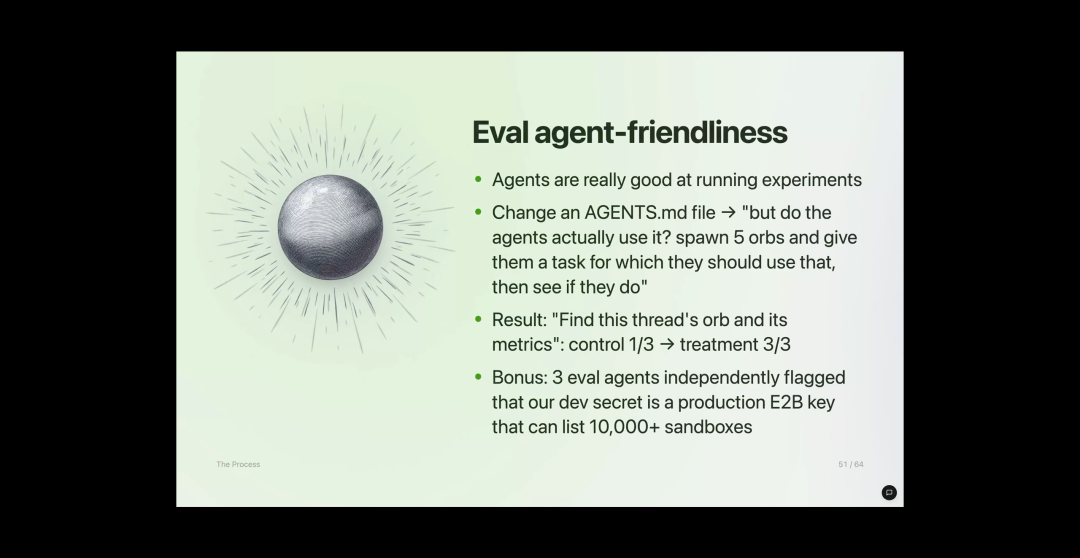
Ball 经常做的一件事是 eval agent-friendliness。你改了 AGENTS.md,但 Agent 真的会照做吗?他的做法是:让 Agent 自己 spawn 5 个 Orb,做控制组 vs 实验组,看在不同请求下 Agent 是否用了你新加的规则。
他说这些模型极其擅长跑实验——"它们出生在整天跑 eval 的 model house 里"。他展示了一个例子:某个 eval 不仅让 treatment group 成功找到 Orb 和指标(3/3 vs 控制组 1/3),三个 eval Agent 还独立发现他们的 dev secret 其实是一个能列出 10,000+ sandbox 的 production E2B key。
14. 案例:Orb 内存不足,从报告到生产验证
分享最后用一个完整案例串起了所有点。有人报告 "Orb 内存不足",Ball 在 Slack 上点了 "I'll take it",然后从 Puck 开始了一个 Opus 5.5 thread,要求 "调查并实现改进:报告内存占用 top 5 的进程,并在 UI 里给出警告"。
Agent 读取了 bug report、日志、BigQuery、类似 bug 的 threads、canaries,连它自己运行在 Orb 里这件事也用上了(可以检查 cgroup 和内存管理)。一小时后 Ball 没等它,回头再看时 Agent 已经给出建议:先 ship 一个带 feature flag 的版本,再做自动处理。Ball 确认后,Agent 包了 feature flag,部署到生产,然后 spawn 了一批 Orb 故意跑高内存来验证,最后 Ball 自己录了段视频告诉 Agent "确实能跑"。
他说这个流程里很多事他自己永远不会做:手动处理 feature flag、研究 cgroup、写脚本占内存、在生产验证。Agent 比他快 50 倍。
15. takeaway:这不只是 Prompt 技巧,是系统重构
Ball 的分享如果要总结成一句话,就是:Agent 的最大收益不在 "更好的 Prompt",而在把 Agent、代码库、流程重新设计成一体。
具体 actionable 的点包括:
- 用最新模型;
- Prompt 说 What 不说 How;
- 让 Agent 横向覆盖 SDLC,给它插件接触生产;
- 用 Orbs 这类 ephemeral 环境移除本地开发负担;
- 把代码库和生产知识做得对 Agent 可读;
- 要求无可辩驳的证据;
- 只审查承重代码;
- 异步、批量、不要等 Agent;
- 用 Agent 自己做 eval;
- 以及,如果你还按 2016 年的流程让 Agent 帮你写代码然后走 PR/CI,那你可能只拿到了一小部分价值。
当然,Amp 是一个在构建 Agent 工具的团队,自身就是 Agent-native 的试验田。其他团队照搬时,安全、合规、组织成熟度都会是约束。但 Ball 给出的这套框架,至少提供了一个清晰的参照系:当 Agent 足够好时,该改的不只是编辑器里那几行 Prompt,而是整个开发环境的设计。类似 Amp 这样的 Agent-native 工程实践,在云栈社区里也有不少开发者持续讨论。
References
[1] How Thorsten Ball Uses Amp, Amp Chronicle: https://ampcode.com/time-capsules/6
[2] YouTube: https://www.youtube.com/watch?v=Z7l1EHfCMU8
 发表于 昨天 23:31
|
查看: 7|
回复: 0
 /1


