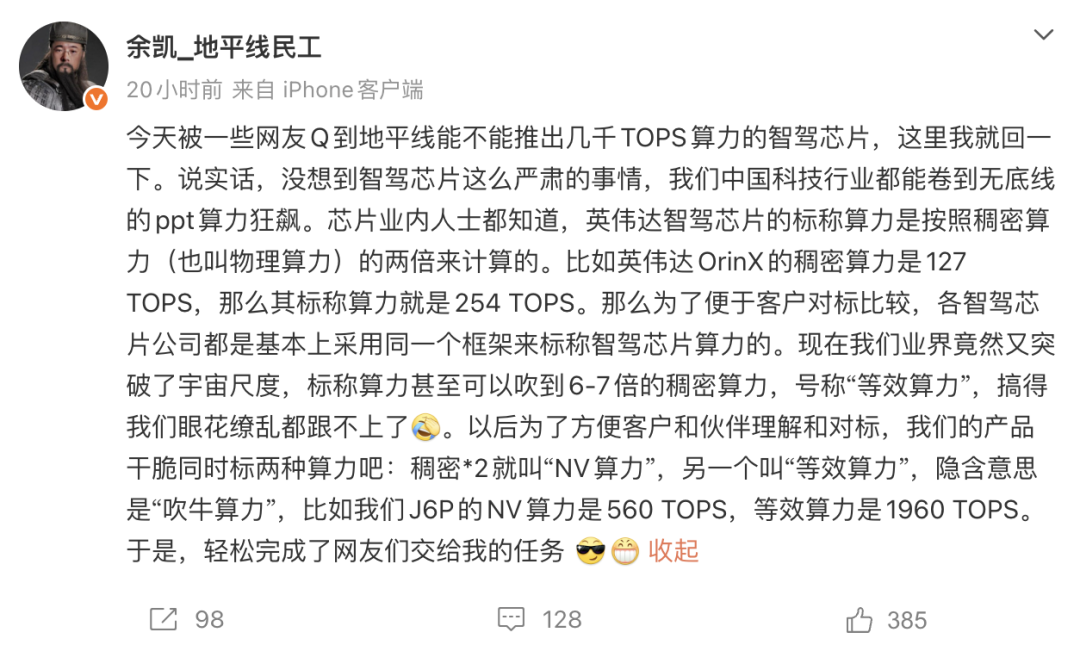
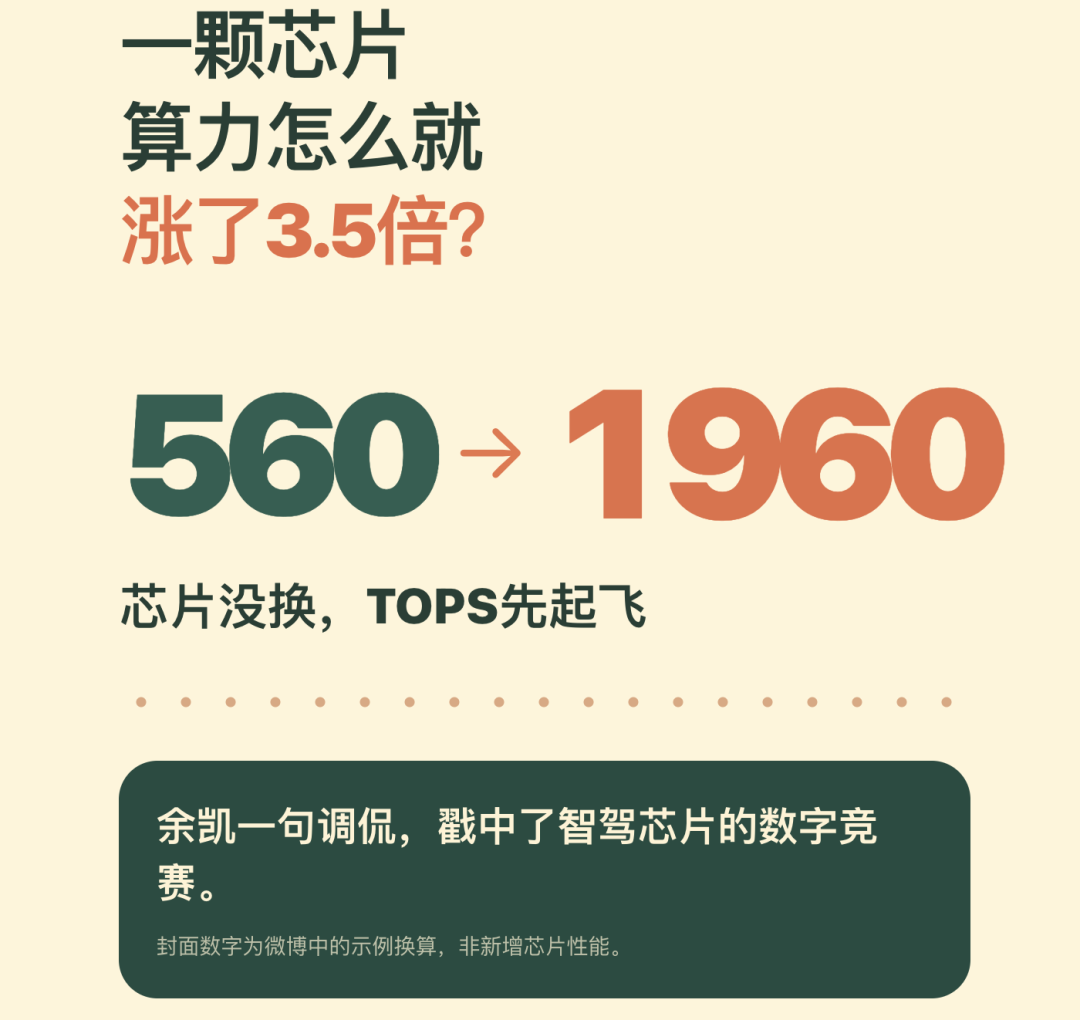
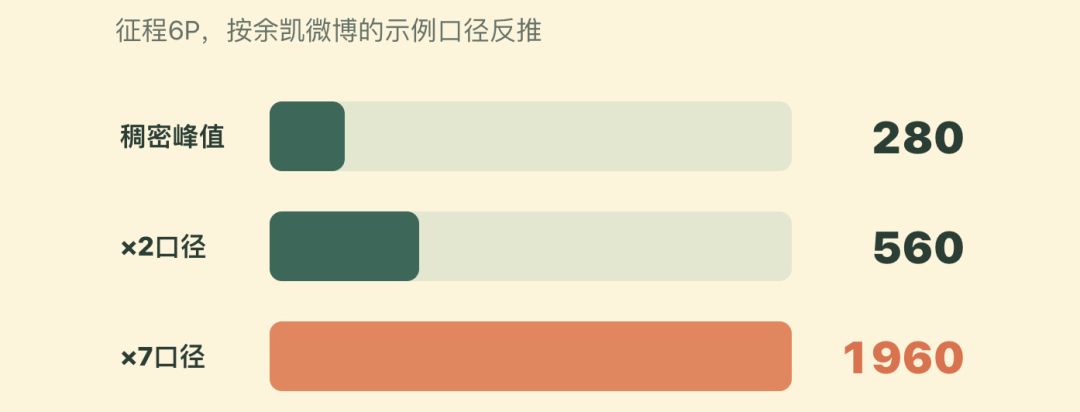
10月30日,地平线创始人余凯的一条微博,把智驾芯片行业的"算力竞赛"直接摆到了台面上。他拿征程6P举了个例子:按稠密峰值乘2的标称口径,这颗芯片是560 TOPS;要是换成某些宣传里的"等效算力"口径,同一颗芯片又能写成1960 TOPS。芯片没变,数字却膨胀了3.5倍——性能并没有因为换了个单位就增加。
车载AI芯片的评价体系已经乱了。半导体公司习惯展示理论峰值,整车企业更关心特定模型的实际运行效率,而消费者看到的,只是越来越膨胀的TOPS数字。
端到端、VLA和世界模型正在进入汽车,真正稀缺的资源变成了带宽、数据流、算子支持、功耗约束和稳定的推理时延。智能驾驶芯片的未来当然还要拼算力,但前提是:同样精度、同样模型、同样功耗下,TOPS必须在同一个尺度上衡量。
第一部分:算力是怎么被"算"大的
余凯这条微博火药味不轻。起因是有网友来问:地平线能不能推出几千TOPS的智驾芯片?他的回答也干脆:当然可以——只要把算力的计算口径一起放大,征程6P也能从560 TOPS变成1960 TOPS。芯片没有重新发布,计算单元也没有增加。
这场关于几千TOPS的争论,算是把过去几年智能汽车行业一直没讲明白的参数问题,盖子彻底揭开了。
算力究竟是怎么被放大的?TOPS,全称是每秒万亿次操作,描述的是计算硬件的理论吞吐上限。它离一辆车在真实道路上的表现,还有不小的距离。
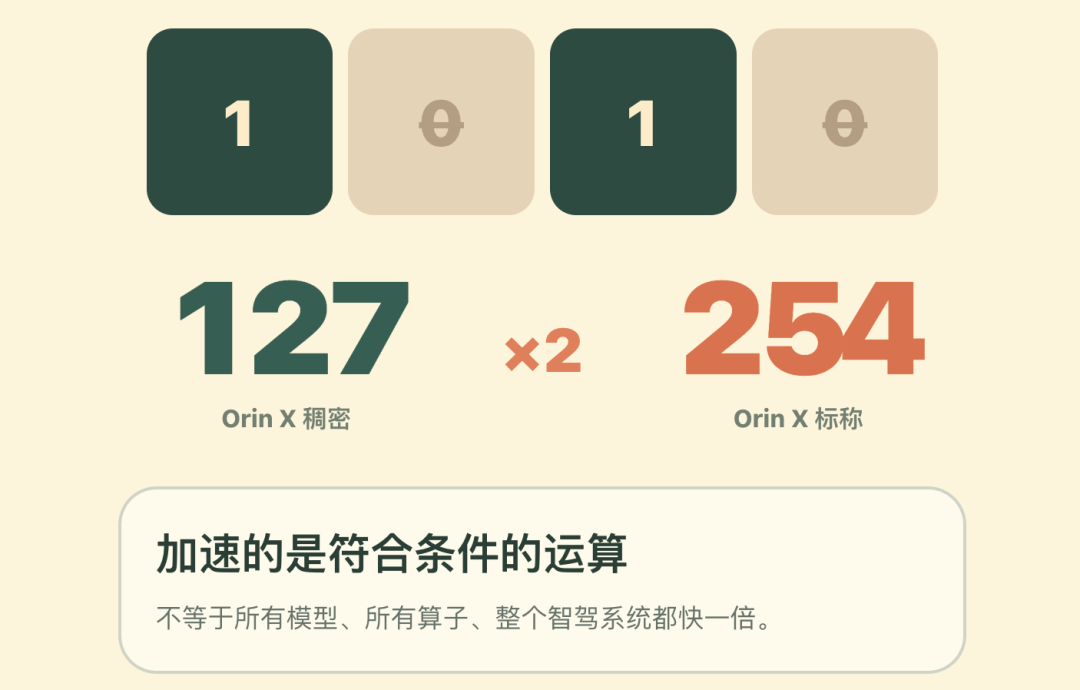
乘2这个口径,技术源头在英伟达Orin X的公开标称:254 INT8 TOPS。其中127 TOPS是稠密峰值,254 TOPS是稀疏标称。英伟达Ampere架构支持一种2:4结构化稀疏——在符合条件的权重块里,四个值保留两个非零值,硬件跳过部分零值计算,让满足条件的张量运算获得更高的吞吐上限。英伟达自己的TensorRT文档也明确列出了DLA结构化稀疏在模型格式、卷积、通道数等方面的限制。
换句话说,不是所有算子都能翻倍,更不是整套智驾系统都能自动提速一倍。
既然乘2都未必可靠,行业为什么突然开始热衷几千TOPS?
早几年的辅助驾驶任务还比较清楚:检测车辆、行人、车道线、红绿灯,再配合规则系统完成决策。但进入端到端和VLA阶段之后,车辆需要把连续视频、空间关系、历史状态甚至语言信息一起送进模型。模型结构、参数量、输入分辨率和运行频率,每一个变量都在重新定义硬件资源需求。
智能驾驶芯片于是从一个后台部件,变成了发布会上的主角。
车企希望通过自研或深度定制,把软件模型和芯片架构绑得更紧:减少不必要的数据搬运,把常用算子做成高效率执行路径,提高片上存储命中率,让模型在低功耗下依然保持帧率。
专业芯片供应商则要同时支持不同整车厂、不同算法团队,在灵活性、开发工具和交付规模之间做平衡。
一个"1280 TOPS"或"2000 TOPS"的大数字,混入了不同芯片的计算精度、稀疏条件、模块范围和"等效"换算。数字越大越容易记住,比较的基础却越来越薄弱。任何宣称"等效"的企业,到底拿什么模型、什么基准平台、什么精度,才算出这个倍数?
专用架构在特定任务上的效率高于通用架构,这本来是芯片创新的价值。但把某个模型上的效率优势转写成通用TOPS,再塞进不同芯片的理论峰值排行榜里,两种完全不同的指标就被混成了一锅。
第二部分:自研的智能驾驶芯片该用什么说话
买芯片只看TOPS,就像买车只看马力。马力当然重要,但光有马力解释不了整车的加速、刹车和赛道成绩。智驾芯片也是一个道理:算力决定潜在上限,系统设计决定你到底能用上多少。
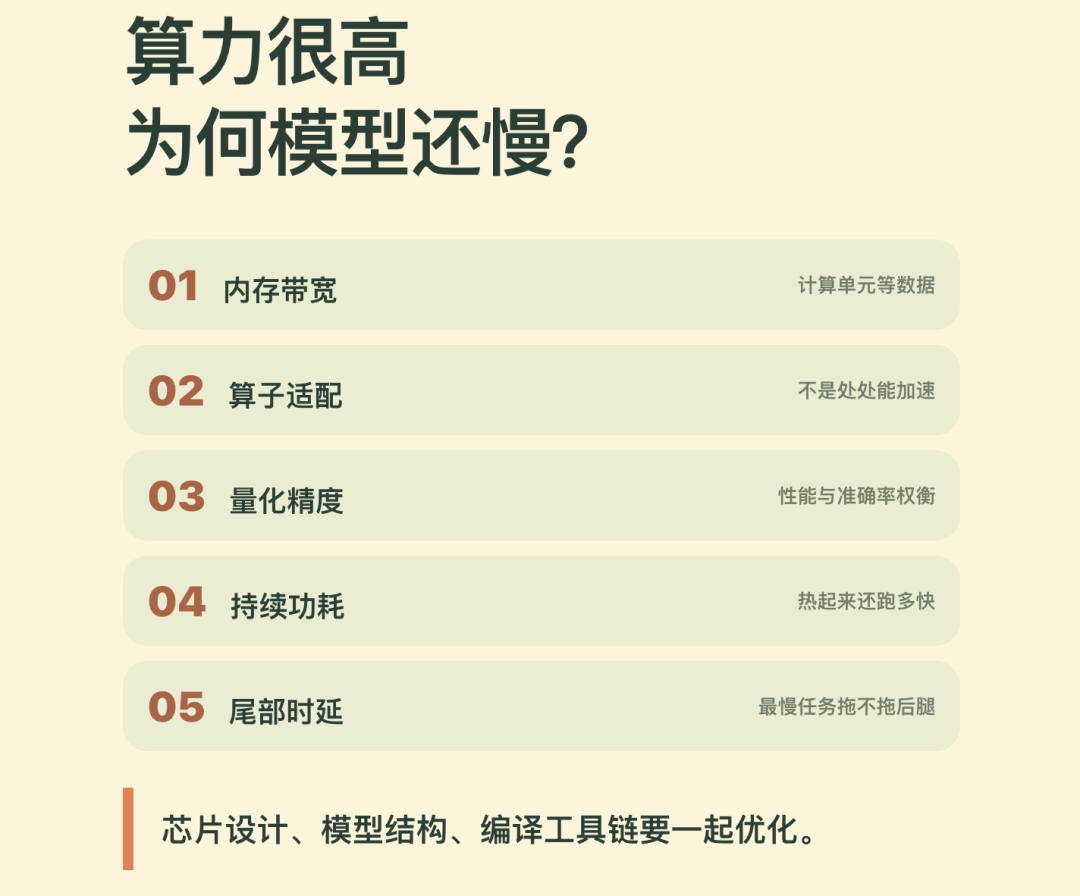
先看内存带宽和数据搬运。大模型运行时,权重、激活值和多路摄像头数据在持续流动。如果算力单元只能空等数据,TOPS再高也得闲着。片上缓存、内存带宽、编译器的数据布局优化,才真正决定了模型能跑多快。
再看算子适配与精度。同样一个网络,在INT8、FP8、FP16或混合精度下的运算能力并不相同。量化和稀疏化可以改善速度与功耗,但必须验证精度损失、支持范围以及实际部署的网络结构。用于Transformer、注意力机制、归一化和后处理的部分算子,不能简单套用卷积层的加速倍数。
持续功耗与长尾时延同样关键。汽车是一个温度变化大、同时运行多项任务的边缘计算环境。持续运行30分钟后会不会降频?摄像头输入、感知、规划和监控并发时,最慢的1‰请求需要等多久?在城市复杂交通里,这些问题的解释力远强于"理论峰值多少万亿次"。
假设一套系统以10Hz更新规划,周期就是100毫秒。摄像头采集、预处理、模型推理、后处理、规划和执行,每一步都要占用时间。计算单元跑得再快,只要数据准备和软件调度拖住了关键路径,输出还是可能赶不上周期。需要说明的是,100毫秒只是这个示例的周期,并不是所有辅助驾驶系统的统一安全标准。
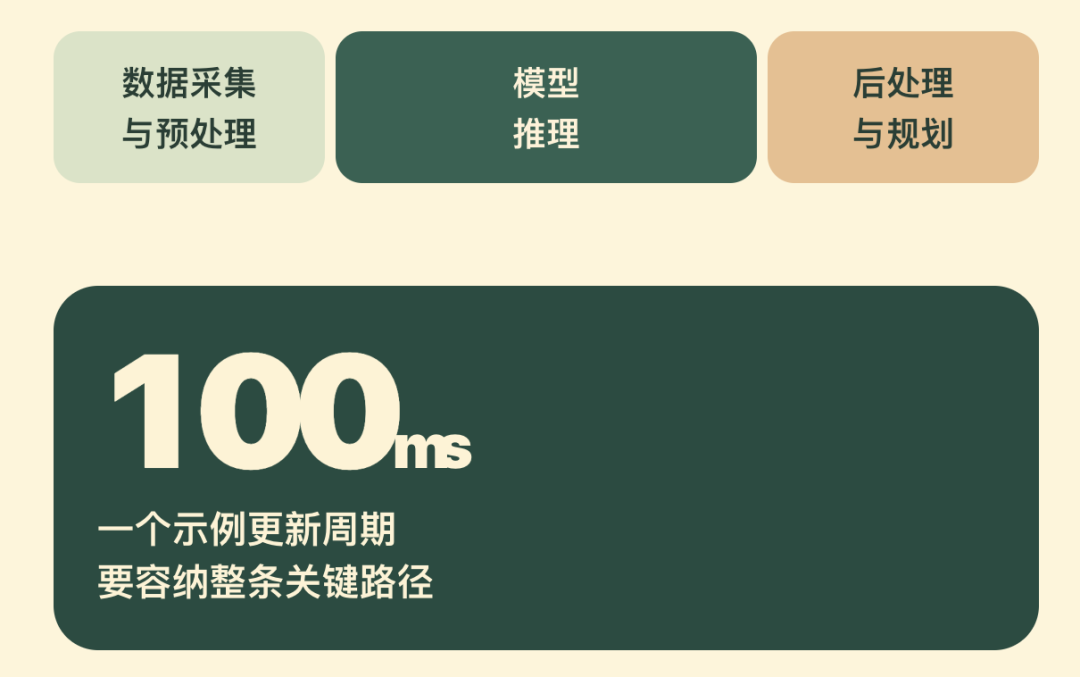
业界正在建立更贴近车辆真实负载的基准。MLCommons的MLPerf Automotive就把时延作为核心评价对象,并引入了99.9百分位时延等指标,把衡量标准从"每秒能算多少次"推进到"一个可复现任务究竟多久完成"。
对地平线这样的独立供应商来说,真正的难题是服务多家整车厂。每家模型不同、更新周期不同、传感器组合和成本目标也不同。芯片不能只为一个网络做极致优化;编译器、算子库、工具链、调试能力和车规交付,每一项都是客户付费购买的能力。
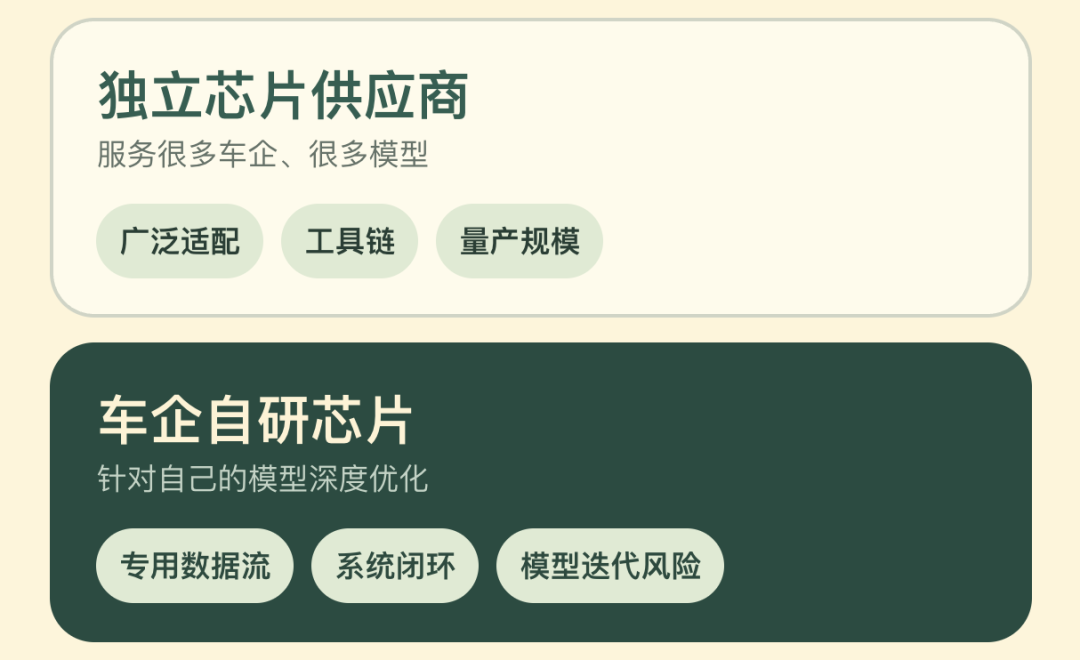
对于自研芯片的车企,机会在于软硬件联合设计。可以根据自己的模型确定数据流、缓存和算子结构,把某一套系统做得非常高效。代价是开发周期长,而且模型架构一旦变化过快,就可能出现芯片为旧模型定制、新模型却已经换路的风险。
这两条路线,一个偏开放适配和规模化,一个偏单一系统的高效闭环。判断谁是赢家,不能只看谁在发布会上拿出了更大的数字。
芯片与内存成本、整机板卡和散热成本、模型迁移周期、量产稳定性、持续OTA能力,以及真正跑出来的安全表现——消费者买到手的,其实是整套系统的表现。
下面这份"算力说明卡",可以作为参考。
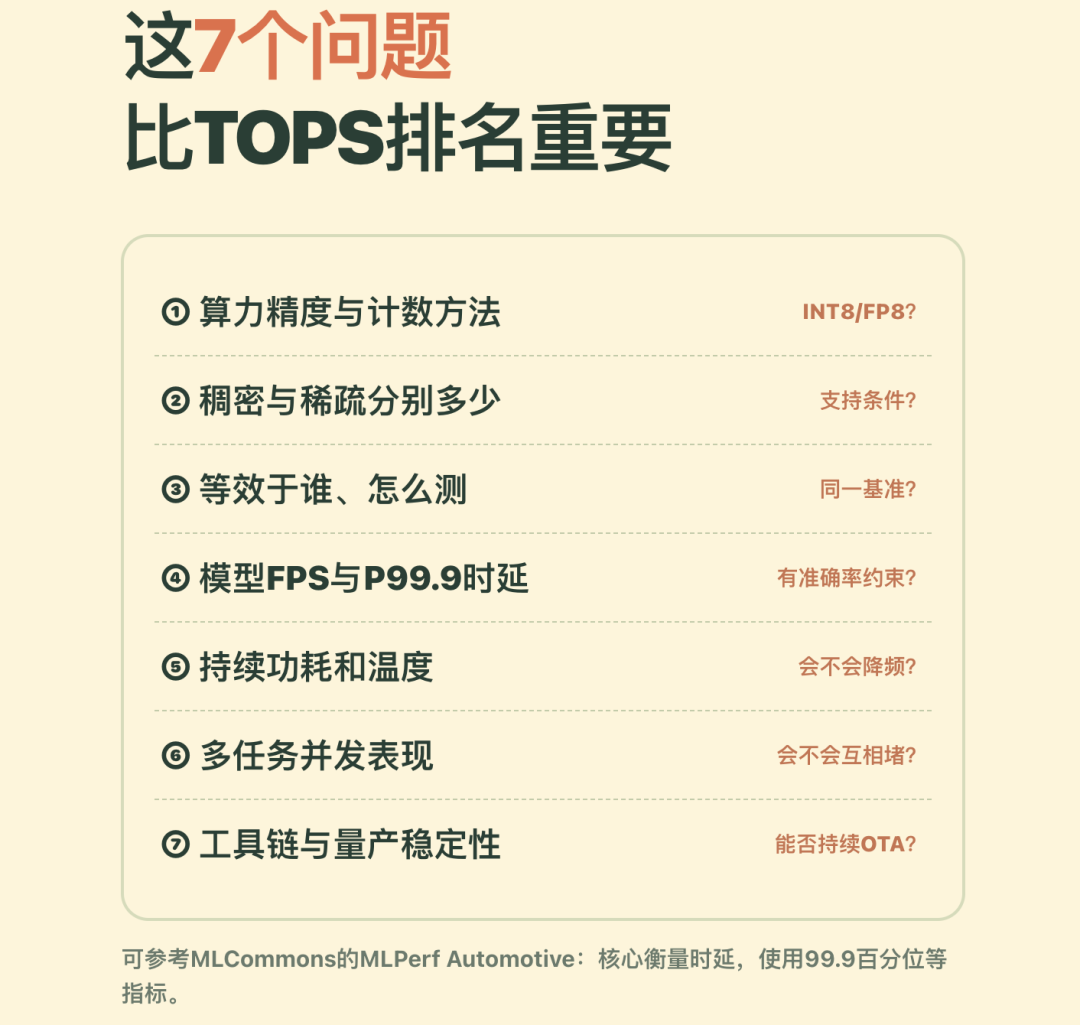
峰值口径:是单芯片还是多芯片?INT8、FP8还是其他精度?MAC按几次操作计数?
稀疏条件:稠密与稀疏分别多少?支持什么稀疏模式,覆盖哪些算子?
等效基准:等效于哪颗芯片、哪个软件版本、哪个模型、什么精度和batch?
真实运行:给出有准确率约束的FPS、端到端时延以及P99/P99.9尾时延。
功耗散热:在持续功耗和车内温度条件下测试,而不是只记录短时峰值。
系统并发:多个摄像头和任务同时运行时,关键路径时延是多少?
汽车行业已经经历过续航数字、快充功率和激光雷达线数的宣传竞赛,今天轮到了TOPS。消费者同样需要一个简单的判断入口。让一个足够复杂的模型,在同样功耗下跑得更快、更稳定,再把数据公开出来,价值会比一个孤零零的TOPS数字大得多。
 发表于 昨天 19:29
|
查看: 6|
回复: 0
 /1


