一个机器学习模型能输出每只股票的收益预测,组合经理接下来要面对的问题是:这些预测应该全部使用吗?是直接对每只股票估计均值和协方差,还是只做十分组?如果信号很弱,十分组是否仍然合理?
常见回答有两个极端。学术上倾向于收缩:保留所有维度,但把估计结果向稳定目标压缩。实务中则倾向于粗化:分组、倾斜、等权,主动减少使用预测的细节。真正合理的粒度应当取决于预测质量,而不是事先固定。
这项研究把等权、十分组、参数倾斜、最小方差和常见收缩规则放进同一个“粒度网格”,并给出一条直观原则:每多使用一个预测或协方差维度,都要付出估计误差成本。信号不足时,少就是多;预测没有排序能力时,规则应退回等权。
研究结果尤其适合纠正一种惯性:模型越复杂,不代表组合就应该越复杂。一个高质量预测模型,也可能最适合只分成四组。
一、组合选择中的三个维度:交易什么、相信多少、放多大
粒度并不只是分组数。研究把组合拆成三个相互独立的选择:
- 作用空间:实际交易哪些基础组合,决定协方差在多少维空间估计;
- 预测压缩:在选定的空间里保留多少预测信息,决定使用多少维收益信号;
- 仓位长度:最终把方向性组合放大或缩小多少。
如果直接对 $N$ 只股票使用全部样本均值和样本协方差,作用空间和预测维度都接近 $N$。如果只交易一个等权组合,两个维度都缩到很低。十分组则介于两者之间:先用预测排序,再在少数组上使用信息。
这个分解解释了一个常见误区:预测模型和组合模型可以分别复杂。模型可能使用数百个特征,但最终组合只需要识别少数稳定的收益方向。把所有预测点值原样送进优化器,不一定比少数稳健分组更好。
二、每个使用维度都有价格
组合损失可以概括为三部分。粗化会减少第三类和第二类成本,但会增加第一类成本。保留全部细节则相反。
在相应假设下,每多使用一个预测维度,噪声价格与历史观测数 $T$ 相关。它可以理解为估计夏普比率的方差量级,而不是对所有市场都成立的交易成本常数。
这意味着,一个维度是否值得保留,不应只看它在样本内有没有解释力,还要看它提供的真实信号能否超过估计噪声。弱信号通过更多维度进入组合,可能只是让优化器更精确地拟合历史噪音。
协方差也有类似问题。若只交易 $K$ 个基础组合,协方差估计就从 $N$ 维降为 $K$ 维。随着 $K$ 降低,矩阵求逆带来的误差通常会减弱,但被舍弃的方向也可能包含有效信号。
三、常见组合规则都在同一个网格上
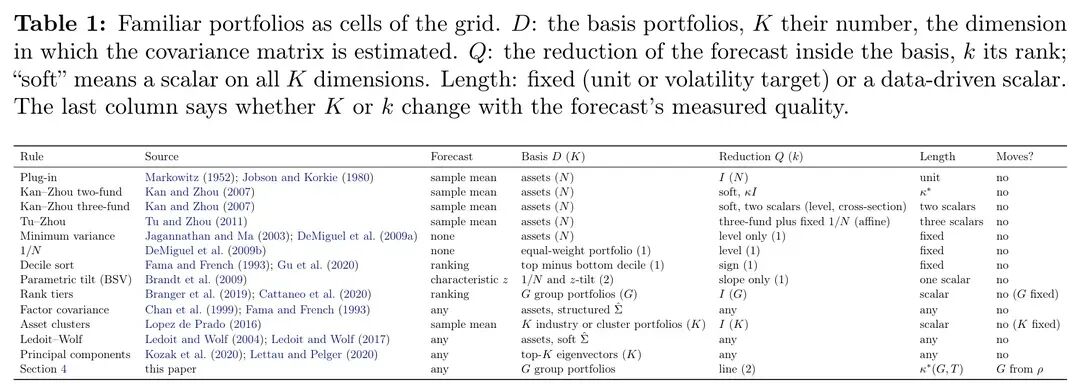
常见组合规则的作用空间、预测压缩和仓位长度;重点看多数规则的维度事先固定,只有自适应规则根据预测质量改变分组数。
直接代入(Plug-in)组合在全部资产上使用全部均值和协方差,保留维度最多,也最容易受到估计误差影响。
最小方差不使用收益预测,主要压缩收益均值环节,但仍需处理高维协方差。
等权只交易一个平均组合,放弃预测方向,换取最低估计需求。
十分组用预测排序,但固定分组数,预测强弱不会改变结构。参数倾斜在等权基准上增加一个方向,结构更简单,却也固定了使用预测的方式。
排序分组(Rank tiers)使用多个排序组,但组数通常由研究者预设。它们都占据网格上的一个固定点,没有回答“当前预测究竟值得使用多少维”。
四、最优分组数为什么出现三次方
先看一个教学化简。设分组过少时,组内信号损失随组数减少而增加;分组过多时,估计噪声随组数增加而扩大。对总损失求导并令导数为零,可以得到一个直观的解。
课程|算法与数据结构全面精讲:从基础到进阶 一线大厂核心算法深度解析与实战指南,系统讲解算法与数据结构核心知识,覆盖从基础结构到动态规划、图论、搜索与排序等高级算法,并通过一线互联网公司面试真题深度剖析,帮助学习者掌握算法设计与分析思想。
所以,最优分组数随“信号/噪声”比值以三次方根增长,而不是线性增长。信号稍强时,合理分组数通常不需要增加很多;噪声稍弱时,也不应立即切成很多组。
研究给出的可计算规则具有相同直觉。公式涉及资产数 $N$、历史月数 $T$ 以及预测与下一期收益之间的滚动秩相关 $\rho$。若 $\rho$ 接近零,直接使用一个组,即等权。
例如取一组典型的参数值,连续最优值约为四组,而不是机械地使用十组。若严格执行离散候选网格,3.92 距离 3 比距离 5 更近,因此实际取 3。论文讨论中的“约四组”与离散候选网格属于不同精度口径,复现时应明确记录。实际实现中,研究把估计值舍入到上述候选,并用历史样本估计 $\rho$,避免使用持有期之后才出现的信息。
理论推导还区分了使用阶梯形分组均值与拟合一条直线的情形。两者的最优分组数不必完全相同,后者涉及协方差估计和可交易信号分解。实务公式采用较容易测量的 $\rho$,部分原因是对比两个夏普比率更难精确估计。这里不能把某个闭式最优解当作任何资产池都成立的普遍定律。
五、从预测排名到组合权重:六步流程
自适应规则可以拆成六步。
第一步,按当期预测对 $N$ 个资产排序。这里使用的是排名,而不是预测点值的绝对大小。
第二步,用滚动秩相关估计预测质量,并按公式确定分组数。没有排序能力时只有一个组。
第三步,为每个历史月份重建当时的分组,并计算各组等权收益。不能拿当前成分倒填历史,否则过去的高收益组会被事后选择,产生前视偏差。
第四步,在组均值上对组排名拟合一条直线。这样预测端只使用截距和斜率所代表的低维信息,而不是自由使用每组一个独立预测值。
第五步,在组空间估计协方差并求组合权重。若 $H$ 是资产到组的映射,$\Sigma_G$ 是组协方差,$P_\ell$ 表示直线压缩,权重可写作:
$$w = H\, \Sigma_G^{-1}\, P_\ell\, q$$
其中 $q$ 表示经过直线压缩后的组级预测。实际实现中还需对权重做归一化和缩放处理。
第六步,用可行缩放控制最终仓位长度,或者改为波动率目标。缩放改变大小,不改变组内和组间的基本方向。
当信号趋近于零时,规则只剩一个等权组合,自然退化为 $1/N$。这一点很重要:等权不是模型失败后的无奈选择,而是低信息状态下的最优候选之一。
六、实证:固定十分组在弱预测上付出更大代价
实证覆盖 1989—2023 年,每年末从大型美国股票中重新抽取 100 只,平均 100 次抽样。比较历史均值、动量、双特征组合、十五特征组合、偏最小二乘和机器学习六种预测。其中偏最小二乘与机器学习的组合构建涉及高维特征与降维技术,课程会系统讲解相关模型评估与集成方法,适合延伸学习。
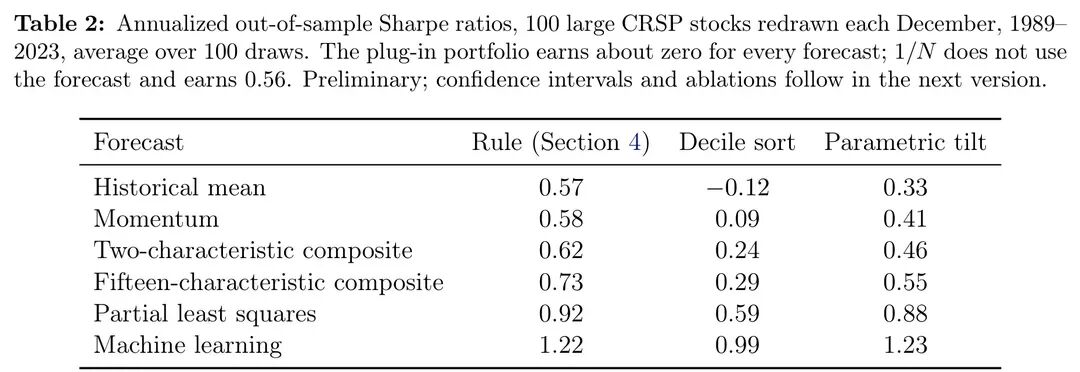
不同预测质量下,自适应规则、固定十分组和参数倾斜的样本外夏普;表注同时标明结果仍属初步,置信区间和消融检验留待后续。
主要数值如下:
| 预测方式 |
自适应规则 |
固定十分组 |
参数倾斜 |
| 历史均值 |
0.57 |
-0.12 |
0.33 |
| 动量 |
0.58 |
0.09 |
0.41 |
| 双特征组合 |
0.62 |
0.24 |
0.46 |
| 十五特征组合 |
0.73 |
0.29 |
0.55 |
| 偏最小二乘 |
0.92 |
0.59 |
0.88 |
| 机器学习 |
1.22 |
0.99 |
1.23 |
等权基准的夏普约为 0.56,直接代入组合接近零。固定十分组在历史均值和动量等弱预测上表现较差,说明把弱信号强行切成十份,会放大估计噪声。
随着预测质量提高,自适应规则的表现改善,但机器学习预测下参数倾斜为 1.23,略高于自适应规则的 1.22。因此,研究并不证明自适应规则在所有情况下都最优,而是说明固定粒度会在不同预测质量下产生不同代价。
这组结果也提示一个实际检查方法:如果十分组只在强预测上有效,就不应把同样的分组方式套到所有信号上。组合结构应成为信号诊断的一部分,而不是建模结束后才随意决定的容器。
七、对机器学习投研流程的启示
第一,把预测评价与组合评价分开。IC、RMSE 或分类准确率回答预测问题,分组数、协方差维度和换手回答组合问题。预测指标更高,不保证需要更细的仓位。系统学习机器学习模型评估与实现,可参考该课程,覆盖从数据预处理、特征工程到模型构建与评估的完整流程。
第二,使用滚动 rank IC 估计当前可用粒度,并冻结计算规则。每次只能使用调仓前数据,不能根据全样本 IC 选择历史分组数。
第三,为弱信号设置等权回退。若 rank IC 接近零或方向不稳定,直接减少分组,而不是继续调参寻找一套看似可用的权重。
第四,组内等权、组间低维拟合可以降低估计需求。对 A 股,还需额外处理行业中性、市值约束、涨跌停和 ST,否则最高组可能只是某种风格暴露。
第五,分别记录收益提升来自哪里:更好的预测、更少的估计维度、更低的换手,还是恰好避开了某次回撤。没有这些分解,很难判断粒度规则是否真正稳健。
八、局限:理论和实证都仍有边界
论文明确标注为初步版本,置信区间和消融检验留待后续。表中的夏普是多次抽样的平均结果,不应被理解为已经完成显著性确认的固定收益。
理论依赖独立同分布、正态收益、稳定的组均值和协方差等假设。实际资产的收益厚尾、状态切换和特征暴露时变,都可能改变最优粒度。
历史分组必须按每个月当时的成员重建,这一要求非常严格。如果使用当前成分回看历史,组均值会携带事后选择偏差,再优美的公式也无法挽救回测。
研究还没有完整计入交易成本、市场冲击和容量。分组数减少通常有利于降低复杂度,但不等于必然降低换手,权重和缩放方式仍需单独检查。
九、结语
预测粒度是一种需要估计和验证的组合决策,而不是建模习惯。弱信号下保留更多维度,往往是在为估计噪声付费;强信号下过度粗化,又会浪费有效信息。
这项研究给出的最实用原则是:让组合复杂度服从预测质量。能稳定排序时才增加分组,不能排序时退回等权;组内保持简单,组间只使用低维信息。对量化研究员而言,比追求更细预测更重要的是先回答:这些预测中有多少内容值得真实资本去使用。
参考文献
[1] Salcher L, Stöckl S, Hanke M. Less Is More: Forecast Granularity, Estimation Error, and Portfolio Choice[R]. Preliminary working paper, 2026.
 发表于 昨天 12:13
|
查看: 19|
回复: 0
 /1


