一、预测准确,就意味着理解市场吗?
一个 AI 模型能预测未来 15 分钟的股票收益,就能算是理解了金融市场吗?
论文《Towards Financial World Modeling》(2026年10月13日)给出的回答是否定的。预测涨跌只是金融决策的一部分。要判断一笔交易是否值得执行,模型还需要理解波动风险、流动性、市场所处状态,以及资产之间的关联。布朗大学、芝加哥大学和约翰斯·霍普金斯大学的研究者们,围绕这些需求系统考察了金融世界模型的基础——表征。所谓表征,就是模型如何把复杂行情压缩成可供后续分析和决策使用的市场状态。
论文的价值并不在于提供了一个“更会赚钱”的模型,而在于它重新审视了一个基础问题:我们该如何判断 AI 究竟从金融数据中学到了什么?
二、思路:为金融世界模型搭建“状态地图”
金融世界模型不应只是输出一个收益预测值,而应支持对市场演化及行动后果的推演。不过,本文尚未实现完整的动态模拟与交易规划系统,研究重点放在前置环节:检验不同编码器构建的“市场状态地图”到底保留了哪些有用信息。
研究首先从数据入手。作者与数据提供商 Massive 合作构建了 Market-1T 数据集,覆盖 2008—2025 年美国市场交易的股票,包含近一万亿条一秒级聚合观测。每条观测包含 11 项特征,涉及最优买卖报价及数量、成交价格摘要、成交量和成交笔数,能够按金融含义进一步聚合到分钟等更长时间尺度。
其次,研究把评测放到不同市场阶段中进行。作者从 18 年历史中抽取 32 个月作为评测期,主要实验针对每个评测月,仅使用此前六个月的数据训练,并另设五个月选择超参数。实验股票池依据前一个月的信息动态调整,降低未来信息泄露和幸存者偏差的影响。
最后,论文比较 18 种编码器训练策略,包括监督学习与 14 种自监督策略,并设置未经训练的随机编码器作为基线。评价分为两个维度:一是能否保留未来收益、波动变化和买卖价差变化的预测信息;二是能否保留交易日、公司身份和共同收益因子等市场结构。
换句话说,研究不仅问“预测准不准”,还问“模型把什么看作相似,又把什么区分开来”。
三、实证结果:预测能力与市场理解并不等价
1. 多任务监督学习表现突出,自监督并非天然占优
在 15 分钟预测任务上,多任务监督模型的收益、波动变化和价差变化 Rank IC 分别为 0.0311、0.0941 和 0.2455。Rank IC 衡量预测排序与实际结果排序的相关程度,并非预测准确率;这些结果表明,共享表征能够同时保留多类预测信息,但价差变化任务仍是专门训练的监督模型略胜一筹。
更值得注意的是,随机初始化、未经训练的 ViT 在配合充分拟合的岭回归探针后,也构成了不弱的基线。其三个任务的 Rank IC 分别为 0.0170、0.0694 和 0.1692,多种自监督方法并未稳定超越它。在价差变化预测上,所有参评自监督方法均低于这一基线。
这提醒我们:采用复杂预训练目标,不等于获得更有用的金融信息;有效性必须通过强基线检验。
2. 会预测,不代表掌握了市场结构
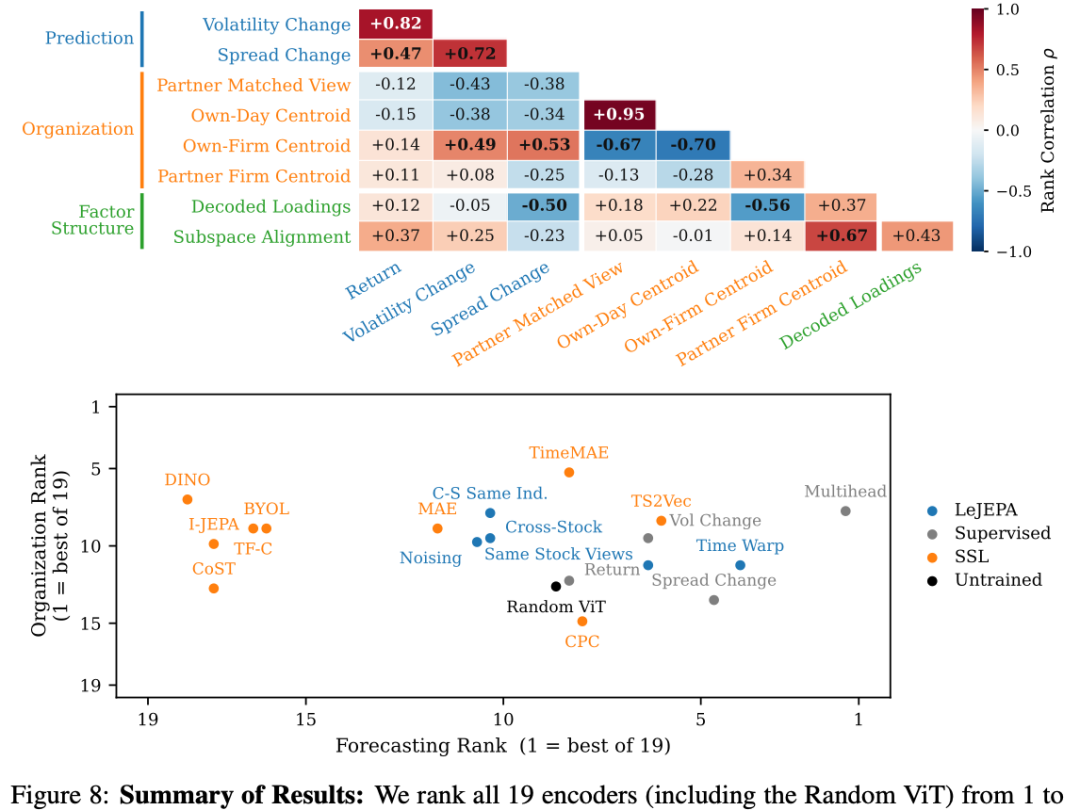
论文发现,各方法在预测能力和潜在空间组织能力上的综合排名相关系数仅为 -0.19,两类能力并不一致。
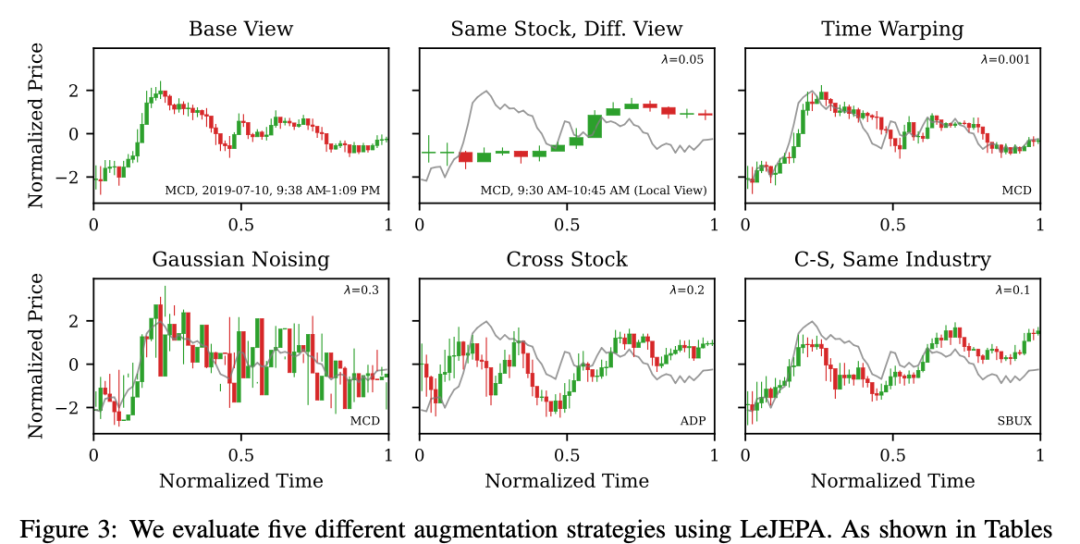
数据增强方式还会改变模型关注的内容。例如,把同一股票的不同片段配成训练对,更容易形成按公司身份聚集的表征;把同一时刻的不同股票配对,则更强调市场共同变化。这意味着,自监督学习并不是“没有假设”,训练样本如何配对,本身就在决定模型应当保留什么、忽略什么。
3. 大模型不一定更合适
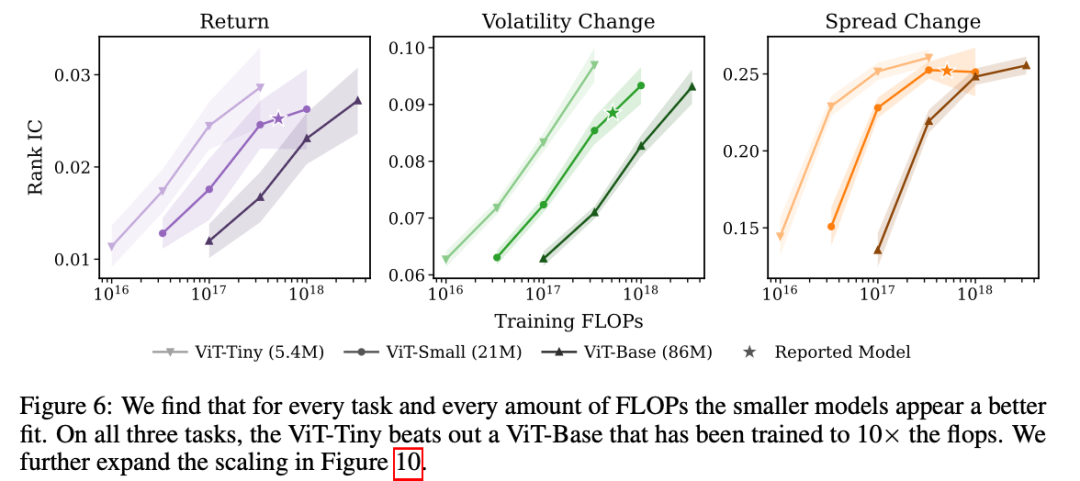
在论文考察的任务和计算预算范围内,小型编码器表现出更高的计算效率。这并不证明大模型无用,而是说明参数规模不能脱离数据、任务和训练方式单独讨论。
4. 市场阶段与交易实现,不能被模型排名掩盖
在论文的方差分解实验中,评测月份解释了三个预测任务中约 97%–99.9% 的表现变化,明显超过随机种子的影响。因此,在单一时期反复实验,不能替代跨市场阶段检验。
此外,在 2,448 种投资组合实现配置中,组合构建、调仓及执行假设对夏普比率的影响可以超过编码器选择本身。预测信号能否转化为收益,仍取决于交易成本与实现方式。
四、结论:金融 AI 需要的不只是一个预测分数
这篇论文最重要的启示,是金融表征质量具有多个维度。一个适合收益预测的表示,未必适合风险建模、流动性判断或跨资产关系分析;更好的预测指标,也不自动意味着更好的交易结果。
研究的边界同样清晰:它主要考察美国股票数据上的状态表征,尚未证明模型能够可靠模拟交易行动对市场的影响,也没有完成自主决策的金融世界模型。
但这正是其价值所在。相比直接追逐“万能交易 AI”,作者先搭建数据与评测基础,再检验模型究竟保留了哪些信息。对于关注量化投资与金融 AI 的读者,这篇论文提供了一把更审慎的尺子:评价模型,不仅要看它预测对了什么,还要看它理解了哪些关系,以及这些能力能否经受不同市场环境的检验。
参考文献与资源:
 发表于 前天 17:22
|
查看: 3|
回复: 0
 /1


