做旅行计划时,你一开始定下了预算,后来订了车票,临出发又遇到天气变化。让 AI 重排行程时,最初的预算和已经订好的车票还得算进去。资料越多、对话越长,模型能读下多少是一回事,能不能在需要时用上前面的信息,才决定新方案能不能照着走。
对轻量模型来说,用好前面的信息,还得算一算要多花多少计算。我们以 Ling-3.0-tiny 的架构为起点。这是百灵于 2026 年 8 月 11 日正式开源的轻量级混合推理模型,总参数 7.9B,每个 token 激活约 1.3B。
在这次预训练实验里,我们用 Tiny 原有的做法作对照,试了两种分段记忆的方法。先看四个要点:
- 长文本为什么难。 Tiny 的部分注意力层采用 Kimi Delta Attention(KDA),像是边读边更新一份大小固定的「笔记」。文本越长,挤进同一份笔记的信息越多,较早的细节就可能更难用上。
- 把笔记分段记。 Ling Delta Attention(LDA)给每段留一份压缩笔记,再按当前内容给前面各段分配权重。简化版 Uniform Ling Delta Attention(ULDA)保留分段,省去逐段打分,让前面各段的权重相同。
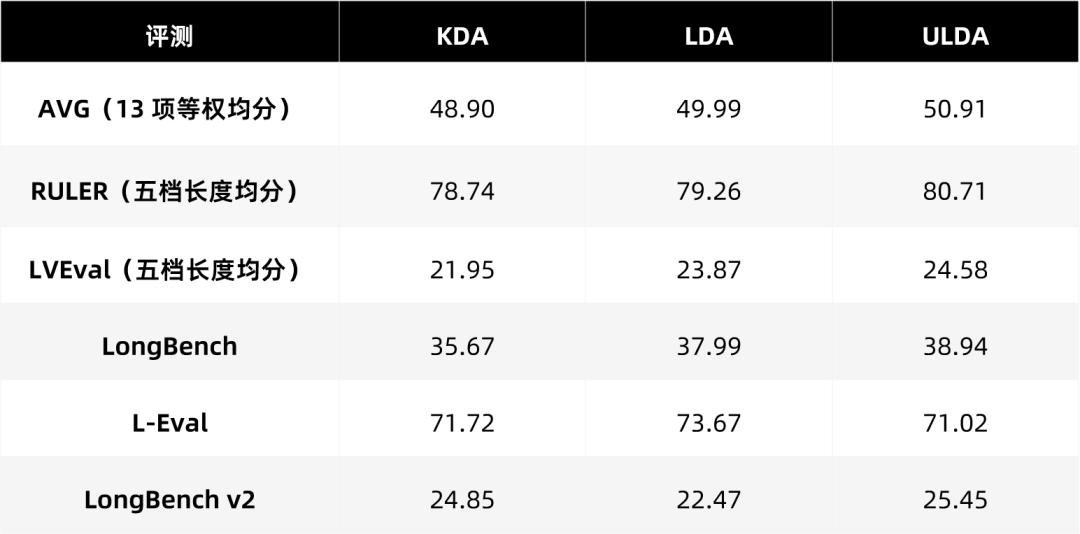
- 省掉打分,长文本均分仍然提高。 在相同的训练节点中分别取各方案的最好成绩,13 项长文本评测均分从 KDA 的 48.90 提高到 LDA 的 49.99(+1.09 分)和 ULDA 的 50.91(+2.01 分)。三组的最优通用评测均分接近。
- 简化了读法,仍有额外开销。 ULDA 可以合并前面各段的笔记再读。在单 GPU 的注意力内核测试中,两种分段方案仍比 KDA 耗时更长。评测上的提升能否延续到真实任务,还需要验证。
为什么越往后,越难用上前面的信息
回到旅行规划的例子。对话里可能已经讨论过好几版行程,天气是刚补充的,预算却在最早几轮就定了。模型在最后一轮重新安排交通和住宿时,需要同时考虑这些在对话里相隔很远的条件。
在 KDA 层里,「笔记」的大小是固定的。这样可以省去逐个保存历史 token 的开销,但新信息仍要写入同一份笔记,较早的条件可能更难利用。分段方案想验证的是:如果前面各段有自己的笔记,模型能不能更好地结合前后信息?
分段记下来,再试两种读法
两种方案都保留当前段的处理结果,再把前面各段的信息加进来。区别在于,历史信息怎么合在一起。
第一种,按当前内容给历史各段分配权重。 LDA 根据当前内容给各段打分,再把所有历史段的读取结果按权重合起来。随着当前内容变化,同一段历史的分量也可以变化。
第二种,让历史各段用同样的权重。 ULDA 省掉了逐段打分。逐步生成时,可以把已读完各段的「笔记」累加起来,融合历史信息时直接读取合并后的笔记。相同的权重只用于历史各段;模型仍根据当前内容读取历史,当前段的结果单独保留。
这里的「笔记」是模型内部的压缩表示。分段按固定长度切开,不会自动识别文件或主题,也不等于逐字存下原文。
两种读法,长文本评测表现如何
我们用 Ling-3.0-tiny 的架构做了三组预训练对比:一组保留原来的 KDA,另外两组分别用 LDA 和 ULDA 替换 KDA,其余结构保持不变。
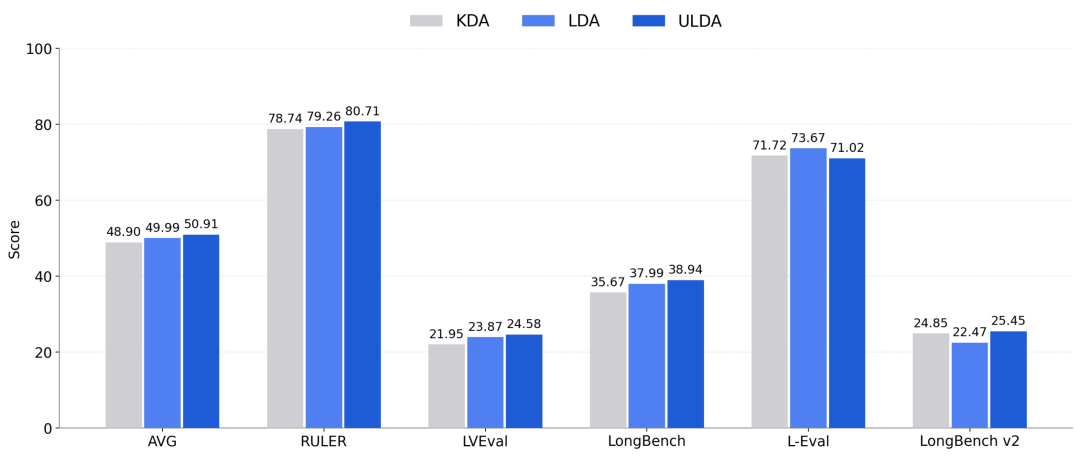
在共同记录的 15 个训练检查点中,我们分别取各方案长文本均分最高的检查点,再看该检查点的整组成绩。13 项长文本评测中,LDA 和 ULDA 的最优均分分别比 KDA 高 1.09 分和 2.01 分。整体提升不代表每一项都更好:例如,ULDA 在 RULER、LVEval 和 LongBench 上高于 KDA,在 L-Eval 上则低于 KDA。
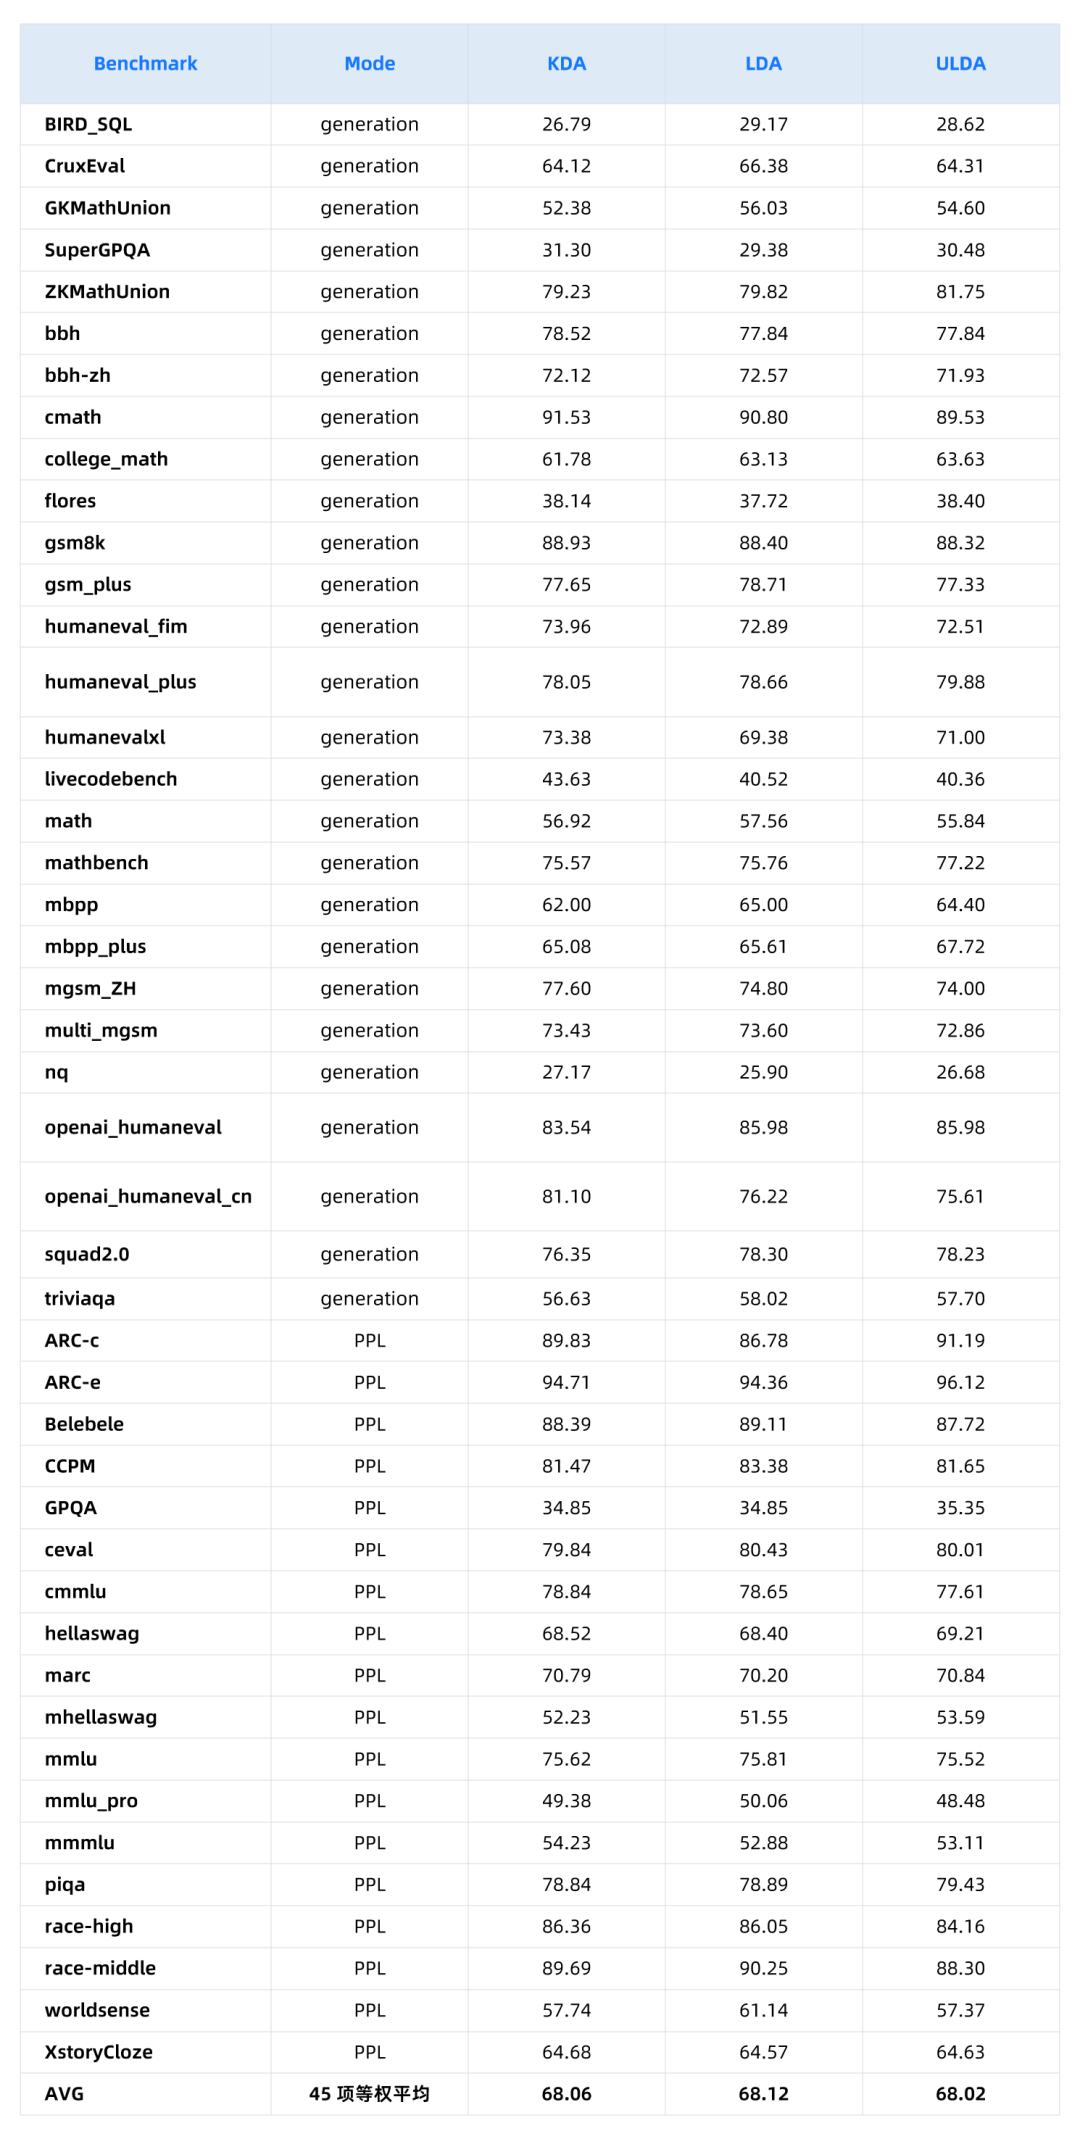
三组模型的 45 项通用评测最优均分在 68.02 到 68.12 之间,整体接近。单项成绩有升有降,详细结果与选取模型检查点的口径见文末。
多用上前文,也要算上多花的时间
在单 GPU 的注意力内核测试中,两种分段方案都比 KDA 耗时更长。随着输入变长,LDA 需要给更多历史段打分;在这组测试覆盖的长度范围内,ULDA 的解码内核耗时随输入长度变化较小,但读取历史状态、将它与当前段结果合并,仍有额外开销。
这些是注意力计算内核的测试结果。到了应用里,还要看整次请求花多久、并发时能处理多少请求,以及新方案能否减少因漏掉前文而导致的返工。
下一步,我们会通过后训练和真实任务继续验证:比如更新旅行计划时,能否更可靠地保留早先的预算和行程约束;同时优化处理长输入和生成回答的计算开销。更少漏掉关键条件,额外等待又能控制在可接受的范围内,这才是这项研究要回答的智效比问题。
技术补充
实验怎么做、成绩怎么取
模型沿用 Ling-3.0-tiny 的 24 层结构:每 4 层包含 3 个 KDA 层和 1 个多头潜在注意力(MLA)层。对比实验分别将 KDA 层替换为 LDA 或 ULDA,其余结构保持不变。两种分段方案的训练序列长度为 256K tokens,分段大小为 16K tokens。能力评测结果均来自预训练阶段。
- 长文本评测: 在三组模型共有的 15 个训练检查点(checkpoint)中,各自选取长文本原始均分最高的检查点,并读取该检查点的整组成绩。13 项成绩按等权平均,包含 RULER 和 LVEval 各自的 16K、32K、64K、128K、256K 五档长度,以及 LongBench、L-Eval、LongBench v2。图中的 RULER 和 LVEval 分别展示五档均分,AVG 仍按原始 13 项计算。
- 通用评测: 27 项生成式评测与 18 项 PPL 类评测,采用任务准确率或任务分数,共 45 项等权平均。KDA、LDA、ULDA 的最优通用均分分别为 68.06、68.12、68.02。
ULDA 在 RULER、LVEval、LongBench 上分别比 KDA 高 1.97、2.63、3.27 分。并非每项都提升:ULDA 的 L-Eval 为 71.02,低于 KDA 的 71.72;LDA 的 LongBench v2 为 22.47,低于 KDA 的 24.85。
训练曲线与内核测试
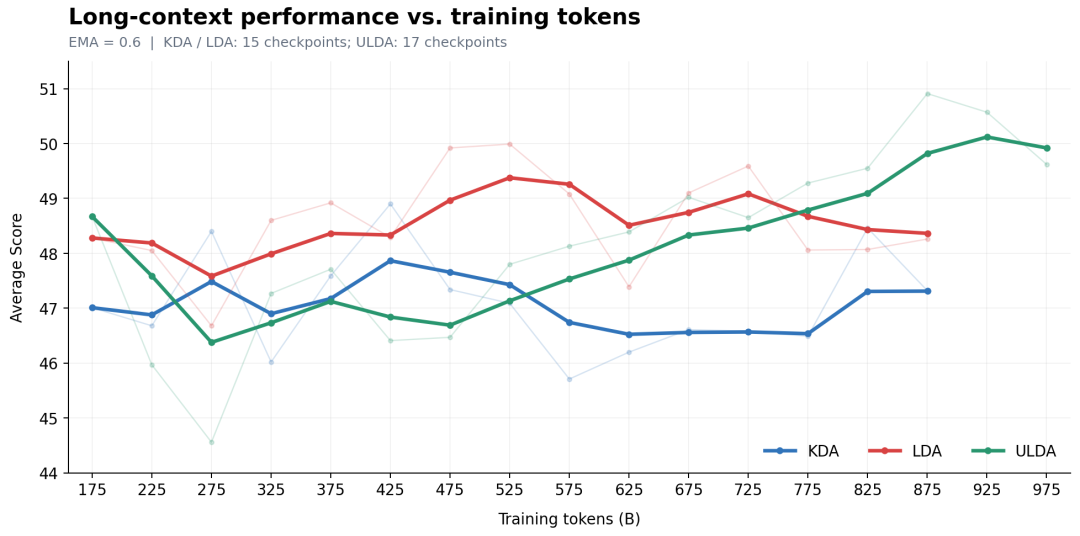
浅色线和点为原始成绩,深色线为 EMA 平滑曲线(系数 0.6,初始值取首个原始分数)。LDA 在约 325B—575B 训练 tokens 的多个检查点领先于 ULDA,并在约 525B 时达到自身最高原始均分;ULDA 前期波动较大,约 625B 之后整体呈上升趋势,在约 875B 时达到 50.91。图中另外展示的约 925B、975B 两个 ULDA 检查点分别为 50.57、49.62,不纳入主结果使用的共同 15 个检查点。
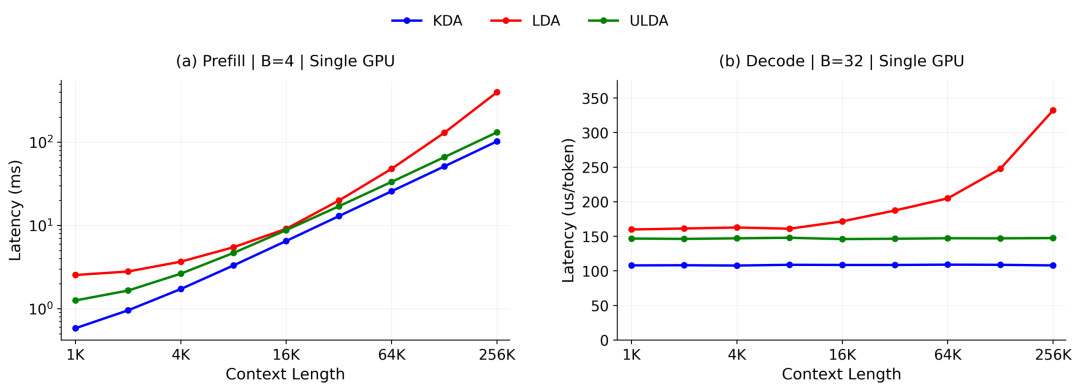
分段大小固定为 16K tokens,单 GPU 测试。左图为处理输入(prefill)的耗时,batch size 为 4、单位为 ms;右图为生成(decode)的耗时,batch size 为 32、单位为 μs/token。图中数据为内核耗时,整模型的响应时延和服务吞吐需要另外测量。
LDA 与 ULDA 的输出形式
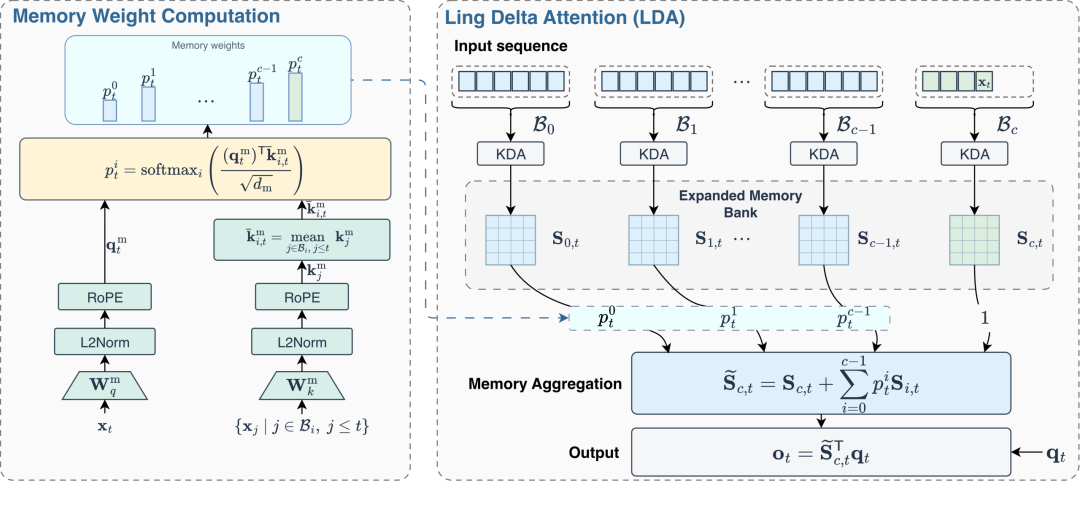
左侧为内容相关的记忆权重计算,右侧为各段状态的读取与融合。
每个 bucket 的 KDA 状态矩阵维度为 dk × dv。LDA 使用独立的 query/key projection 产生记忆匹配表示,再经 softmax 计算 memory weight。历史 bucket 使用完整 summary,当前 bucket 只使用截至当前 token 的前缀 summary,以保持因果性。
设当前 bucket 编号为 c,此前共有 c 个历史 bucket;S_{c,t} 表示当前 bucket 截至 token t 的状态,S_i 表示历史 bucket i 的最终状态,q_t 为主 KDA query。两种输出形式如下。
LDA:
$$
\\tilde{S}_{c,t} = S_{c,t} + \\sum_{i=0}^{c-1} p_t^i S_i
$$
其中,softmax 在包括当前 bucket 在内的全部可见 bucket 上归一化,历史权重之和为 1;当前局部输出的系数始终为 1。
ULDA:
$$
\\tilde{S}_{c,t} = S_{c,t} + \\frac{1}{c} \\sum_{i=0}^{c-1} S_i
$$
由于历史各段采用相同权重,且状态读取是线性运算,ULDA 在递归推理时可以先累加已完成的历史状态,再统一读取,无须逐段读取后相加。模型整体还包含 MLA 等结构,总显存与服务成本仍需单独评估。
长文本评测类别汇总
通用评测完整成绩
相关资料
- Ling-3.0-tiny 模型介绍与使用说明:支持推理与智能体任务,提供 BF16、FP8、INT4 三种精度的权重,可按设备条件选择本地部署方案。
- Kimi Linear 论文,KDA 的相关技术背景。
 发表于 昨天 19:12
|
查看: 1|
回复: 0
 /1


