摘要:在100万 token 下,HySparse2 的预填充算力降到 HySparse 的 1/2.92,KV 缓存从 6.72GB 降至 2.69GB。
论文文献
题目:HySparse2: Hybrid Sparse Attention with Two-Level KV Sharing
地址:https://arxiv.org/abs/2609.26368v1
作者:共15位,全部出自小米 LLM-Core。通讯作者兼 Team Lead 是罗福莉(Fuli Luo)——小米大模型团队负责人,2025年11月由 DeepSeek 加入小米;此前在阿里达摩院主导多语言预训练模型 VECO 并推动 AliceMind 开源,是 DeepSeek-V2 的核心研发成员之一。第一作者 Jianyu Wei 出自中国科学技术大学与微软亚洲研究院(MSRA)联合培养项目,长期做 LLM 推理系统与算法—系统协同设计,代表工作有 nn-Meter、T-MAC、BitNet.cpp。
机构:LLM-Core Xiaomi(小米大模型 Core 团队),小米集团的大模型研发部门,由雷军推动成立,负责人即本文通讯作者罗福莉。团队产出 MiMo-V2 系列、MiMo-Audio、MiMo-V2-Flash 等技术报告;本文的 HySparse2 是 MiMo-V3 架构的先行披露。
关联阅读:小米LLM-Core:HySparse——以全注意力层为选择器的混合稀疏注意力
论文摘要
长程、多轮的智能体(agent)通常只生成很短的行动,却要处理来自工具与环境的长观测。这种不断增长的上下文要求高效的预填充(prefill)、紧凑的 KV 缓存存储,以及准确的长上下文检索。为满足这些需求,作者提出 HySparse2——一种带两级 KV 共享的混合稀疏注意力架构。
在外层,KV Bridging 采用 YOCO 风格的 self-decoder 与 cross-decoder 结构,但只在全注意力层之间架桥。self-decoder 使用混合滑动窗口注意力(SWA),cross-decoder 使用混合稀疏注意力。cross-decoder 中全注意力层的 KV 缓存,由 self-decoder 中全注意力层的隐藏态生成。在内层,HySparse2 保留 HySparse 的核心 KV Reuse 设计并做两处改进。第一,把 block 级稀疏替换为 token 级稀疏,以获得更精细的长上下文检索。第二,从稀疏层中移除独立的 SWA 分支,改为把最近 token 的滑动窗口强制纳入稀疏选择。
这种两级 KV 共享使得 cross-decoder 的全部 KV 缓存都能由 self-decoder 的隐藏态构造。因此,预填充可以在 self-decoder 之后就退出,跳过所有 cross-decoder 层。在 80B-A3B MoE 模型上,HySparse2 在长上下文检索与多轮智能体任务上优于 HySparse 与 Hybrid SWA,同时大幅降低预填充计算量与 KV 缓存存储。
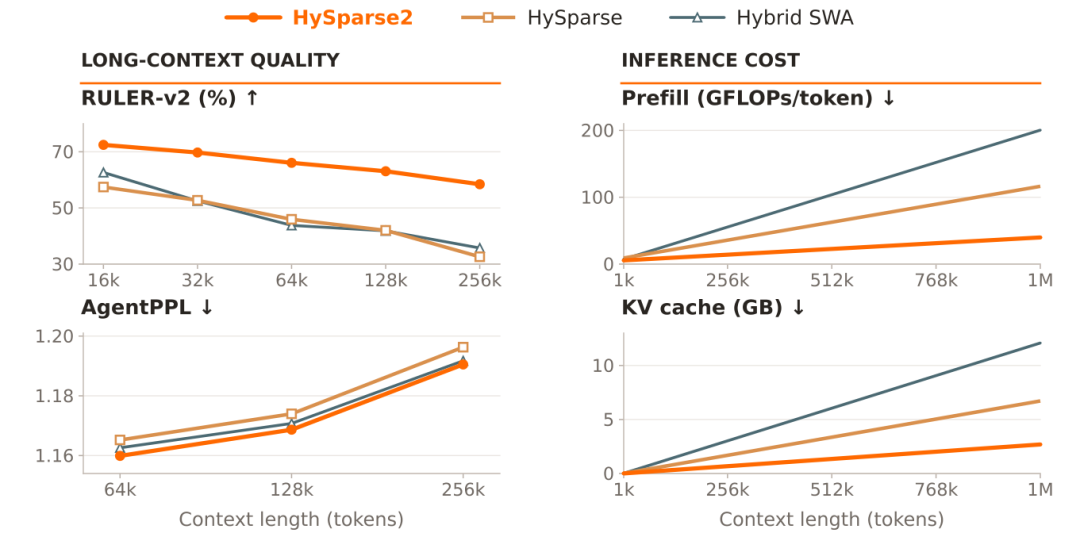
Figure 1 是全文的论点总纲:左侧两图对应质量指标,右侧两图对应成本指标。图中左上 RULER-v2 子图的纵轴刻度标为 30/50/70,属非标准标注,具体数值一律以正文与 Table 2 为准,不以此图为读数依据。
论文内容
1、背景与问题
1.1 研究背景
长程、多轮的 agentic 推理正在让推理变成输入主导:一次短动作或工具调用,可能返回一段远长于动作本身的长文档、搜索结果或执行轨迹,而这些内容必须先被 prefill、才能继续解码。随轮次累积,模型还要在不断扩张的历史里检索并组合证据,注意力计算与 KV 缓存随之一起增长。论文把这类负载的要求拆成三条——高效的 prefill、紧凑的 KV 缓存、准确的长上下文检索,并分别梳理了现有做法。
1.2 问题
前作 HySparse 用全注意力层与稀疏注意力层交替排列,让每个全注意力层把选择索引与 KV 缓存一并传给后续稀疏层,从而在不蒸馏辅助 indexer 的前提下降低了注意力计算与缓存。但在 agentic 场景下它仍存在三处不足:prefill 仍要遍历全部层、KV 缓存还能再小、检索精度还不够。
1.3 研究目标
本文的目标是在不蒸馏辅助 indexer这个前提下把上述三件事一起改善——让 prefill 在模型中途就退出、进一步压缩 KV 缓存、同时提升长上下文检索精度。三者并不彼此独立:省算力与保能力往往此消彼长。
2、方案设计
HySparse2 的答案是「两级 KV 共享」:外层负责跨解码器桥接,内层负责块内复用。
2.1 KV Bridging:跨解码器共享
模型按 YOCO 分为 self-decoder 与 cross-decoder,但只在两者的全注意力层之间架桥。对配对的第 i 层(self)和第 j 层(cross):
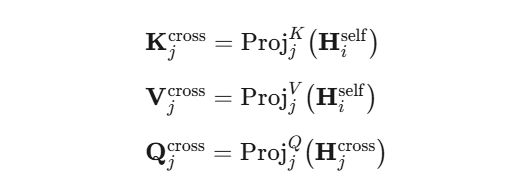
直觉是:K/V 从 self-decoder 第 i 层的隐藏态投影而来,Q 仍取自本层自己的隐藏态。每层保留独立的 K/V 投影,所以「共享来源」并不等于「共享缓存」——同源的层依然构造出各自不同的 KV 缓存。这一设计还允许两个 decoder 采用不同的注意力配比,使一个 self 全注意力层可以供给多个 cross 全注意力层。
2.2 KV Reuse:token 级复用
保留 HySparse 的 block 内复用,并做两处修改:其一,把 block 级 top-k 换成token 级 top-k,全注意力层对单个 token 做选择,后续稀疏层复用这些 token 的 KV 条目;其二,删掉独立的 SWA 分支,改为把最近的一小段窗口强制纳入稀疏选择(128 个强制本地 token),窗口内其余名额再按分数取。
第二处修改是「prefill 能早退」的关键。原文的论证是:cross-decoder 若保留独立 SWA 分支,就必须用自身隐藏态的投影去构造一段 KV 后缀;而这段后缀依赖更早层不断扩张的隐藏态、随深度线性增长,形成级联依赖,迫使 cross-decoder 处理远长于窗口的 token 后缀。要么在 prefill 阶段把这些状态计算出来(否则 cross-decoder 无法整体跳过),要么用 bounded replay 之类的近似方法。HySparse2 通过构造上消除这个依赖,使 prefill 完全不需要 cross-decoder 计算。
2.3 架构图解读
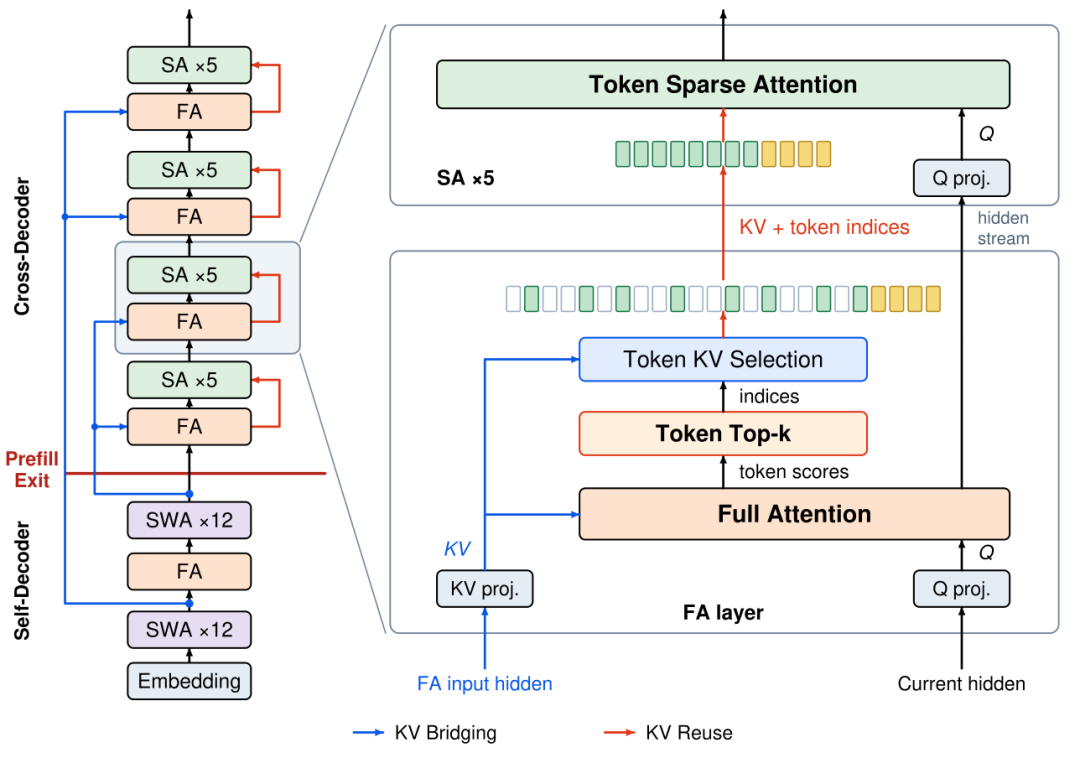
Figure 2 左侧贯穿全图的 Prefill Exit 红线标注了本方法的收益来源:49 层模型只需部署前 25 层,prefill 节点显存需求降低近一半。右侧展示了 block 内的数据流——FA 层计算 token 分数 → Token Top-k 产出 indices → Token KV Selection 同时接收 FA 的 KV 与 indices → 连同 Q 一起送入 Token Sparse Attention;同一 block 内的 SA 层经 KV Reuse 沿红色路径直接复用上述 KV 与索引。
2.4 模型配置对照
配置层面(Table 1),三种设计的差别集中在三处:全注意力层数(Hybrid SWA 9 层,HySparse 与 HySparse2 各 5 层)、KV 头数(HySparse2 用 MQA 64/1,另两者用 GQA 64/4)、以及稀疏粒度。HySparse2 的 SWA 层用 64 维部分 RoPE,全与稀疏注意力用 NoPE,长上下文扩展无需调整 RoPE。
3、实验验证
三个模型在相同数据与调度下训练,横向可比。
3.1 预训练评测
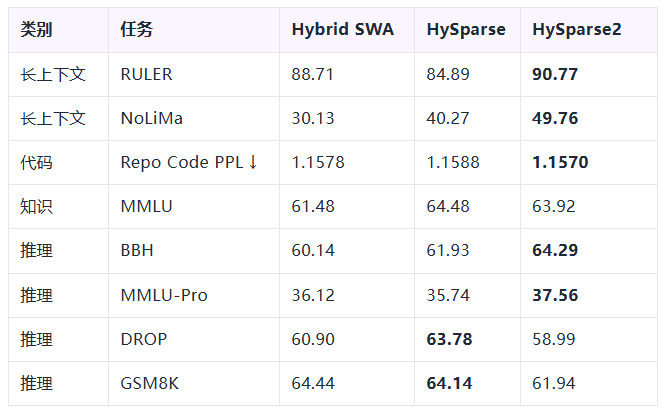
长上下文提升明确,通用能力有升有降。相对 HySparse,RULER 高 5.88 点、NoLiMa 高 9.49 点;但同一张表里 DROP 反低 4.79 点——「通用能力大体持平」严格讲只是「多数项持平」,逐项看并不均匀。
3.2 后训练评测
四项指标全面领先。轻量后训练(+100B tokens,上下文扩至 256k)后,MRCR-v2、RULER-v2、AgentPPL、LongPPL 在被评测的每个长度上都优于两个基线,256k 处 RULER-v2 达 58.45。
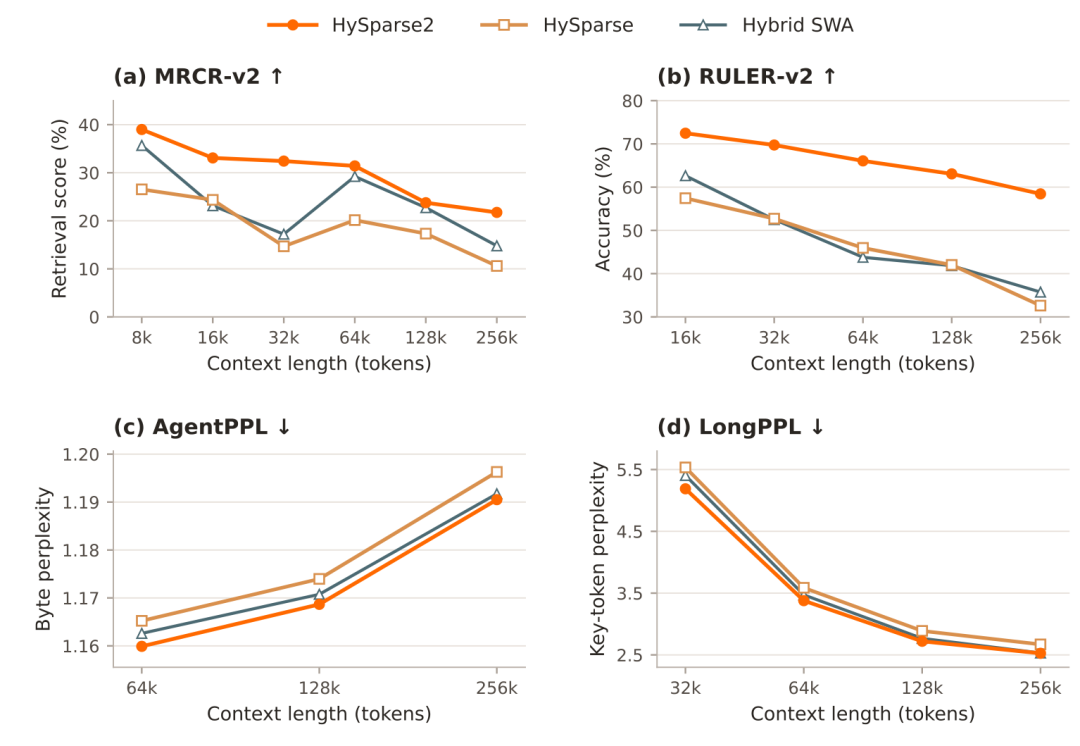
两组困惑度走向相反:AgentPPL 随上下文变长而升高,LongPPL 反而下降。原文归因于上下文增长的双重效应——更长的上下文既为关键 token 暴露更多相关信息,也引入更多中间轮次与工具输出。
3.3 成本对比
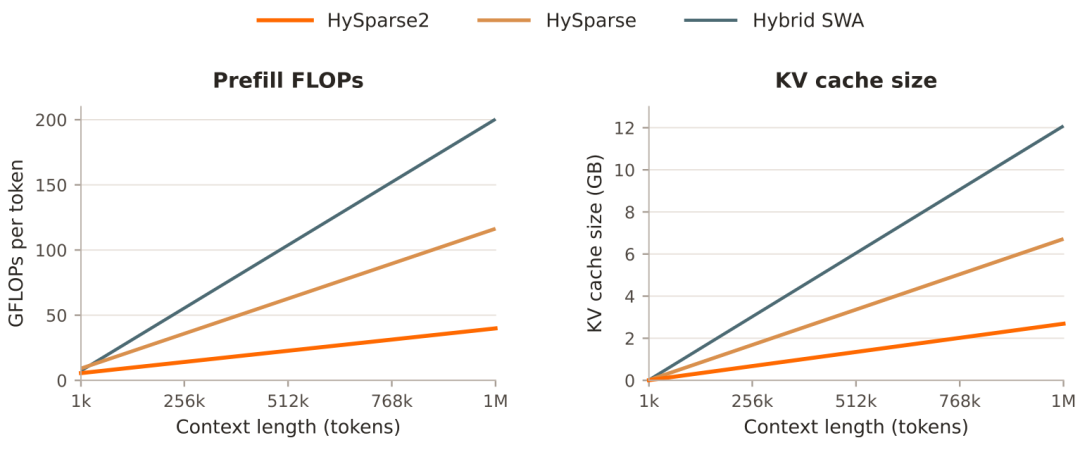
两项成本指标均存在量级差距。1M token、FP8 缓存下,prefill FLOPs 相对 HySparse 降 2.92×、相对 Hybrid SWA 降 5.02×;KV 缓存只需 2.69GB,而 HySparse 占用 6.72GB。
3.4 三组消融
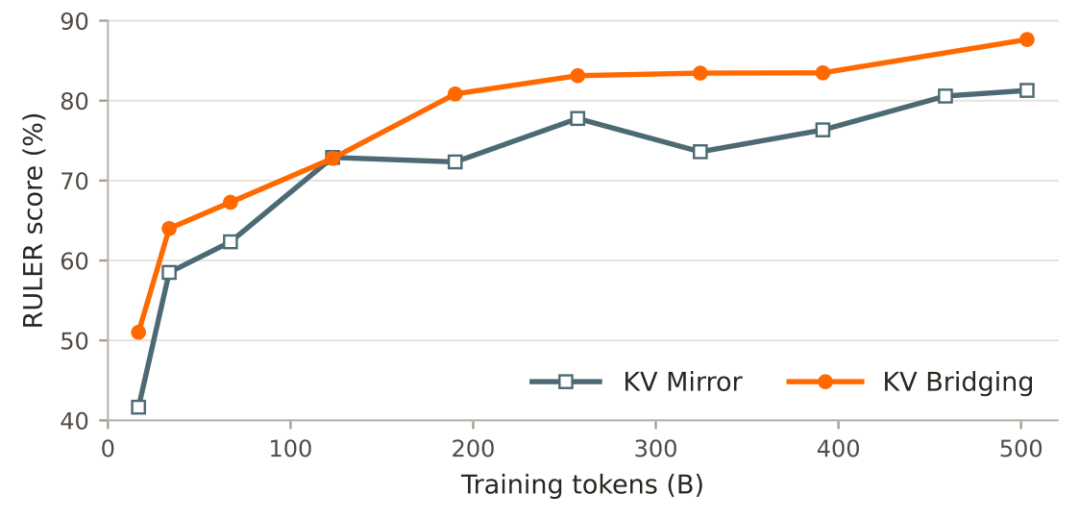
三组消融共同支持一个结论:token 级稀疏、强制本地窗口与 KV Bridging 这三个设计选择均成立。同等注意力预算下 token 级选择全面优于 block 级,RULER-v2 高 6.57 点;强制本地窗口(去掉独立 SWA 分支,改为把最近 128 token 纳入稀疏选择)在长上下文检索上取得最佳结果,代价是 GSM8K 低 5.08 点,作者判为可接受取舍;桥接的精度损失有限,预训练结束时 RULER 87.65 对 U 形连接的 KV Mirror 81.28 胜出。
论文评估
1、创新贡献
(1)解码器间的桥接位置。 self-decoder 与 cross-decoder 的划分沿用 YOCO;本文的限定是把桥接只建立在两方的全注意力层之间而非全部层,一个 self 层由此可供给多个 cross 层。
(2)稀疏选择粒度。 block 级 top-k 沿用 HySparse;本文改为 token 级 top-k,由全注意力层逐 token 打分,后续稀疏层复用被选中 token 的 KV 条目。
(3)稀疏层的本地窗口。 HySparse 用独立 SWA 分支保留本地信息;本文删除该分支、改为将最近 128 个 token 强制纳入稀疏选择,使本地 token 与全局 token 共用同一份 KV 缓存。
2、论文价值
(1)prefill 的计算深度。 此前 prefill 必须遍历全部层,长度不可缩减;删除独立 SWA 分支在构造上消除跨层 KV 依赖后,prefill 可在 self-decoder 之后退出——49 层模型只需部署前 25 层。
(2)跨解码器的注意力配比。 桥接只连全注意力层,两个 decoder 因此可采用不同稀疏配比,一个 self 层供给多个 cross 层;全注意力层数与稀疏比例成为可独立调节的设计变量。
(3)无辅助 indexer 的稀疏化。 稀疏层直接复用全注意力层自身的选择索引,不蒸馏辅助 indexer;配合 token 级选择与稀疏 kernel 进展,不引入额外选择模块的稀疏路线具备落地条件。
 发表于 昨天 23:36
|
查看: 3|
回复: 0


