提起分页,大家可能更熟悉进程隔离、虚拟内存,以及 malloc 分配内存后的按需使用。这些通常从用户态的视角来讲。
其实,内核自己也是分页机制的使用者,而且用法更丰富。用户进程看到的虚拟地址空间由内核建立和维护映射;内核则要通过页表访问物理内存,也要处理非连续物理页和外设寄存器的映射。
先看一张 ARM64 内核地址空间布局图:
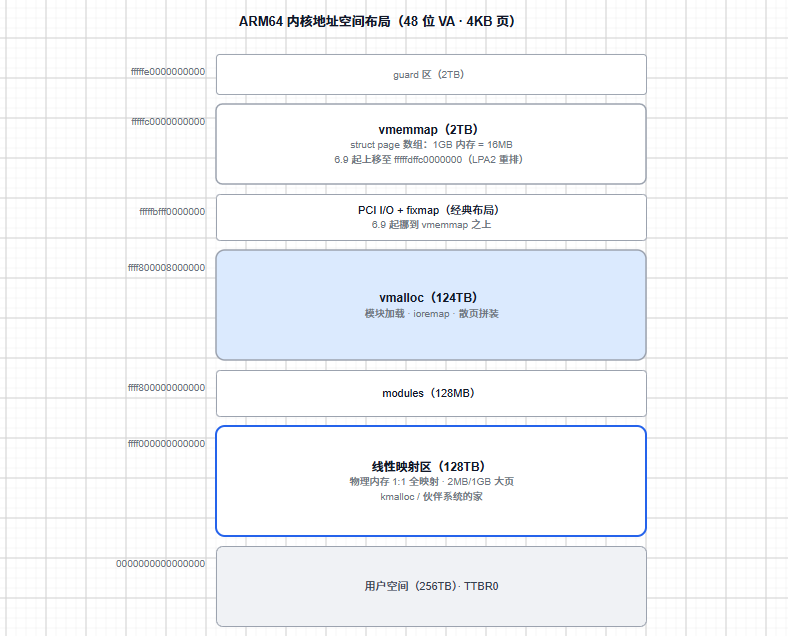
图 1:ARM64 内核地址空间布局示意。图中的具体地址和布局应结合内核版本、虚拟地址位数及配置理解。
以 48 位虚拟地址、4KB 页的常见配置为例,用户空间和内核空间分别位于虚拟地址范围的低端与高端。内核空间中有几个值得关注的区域:
- 线性映射区:图示配置下约 128TB,将适合线性映射的物理内存按固定偏移映射到内核虚拟空间。
- modules 区:图示配置下约 128MB,主要用于加载模块代码。
- vmalloc 区:有上百 TB 的虚拟地址空间,可用于将分散的物理页映射到连续虚拟地址,也可用于设备映射等用途。
- vmemmap 区:图示配置下约 2TB,用于存放描述物理页的
struct page 数组。
x86_64 等架构的区域位置可能不同,但同样会划分内核虚拟地址空间。具体布局也并非一成不变,会随内核版本和配置调整。
1、线性映射
内核经常使用线性映射区,因为它简单、高效。
所谓线性映射,是将适用的物理内存按地址顺序映射到内核虚拟空间。对映射范围内的地址来说,物理地址与虚拟地址之间有固定偏移,可以通过简单运算相互换算;CPU 实际访问时仍由 MMU 按页表完成地址转换。
伙伴系统、kmalloc 和 slab 等内核内存分配机制通常使用这些物理页,分配结果可通过线性映射访问。不过,物理内存中也可能有保留区域或不适合直接映射的区域,不能把所有物理地址都视为普通可用内存。
内核还要为物理页维护 struct page。以每个结构占 64 字节、每页 4KB 为例,1GB 物理内存约有 26 万页,对应的结构体合计约占 16MB。实际结构大小取决于架构和内核配置。
物理内存规模较大时,这些元数据也会占用可观空间,因此内核为其安排了 vmemmap 区域。例如,在上述假设下,64GB 物理内存对应的 struct page 就约占 1GB。
内核页表是怎样建立起来的?可以结合下面的流程看:
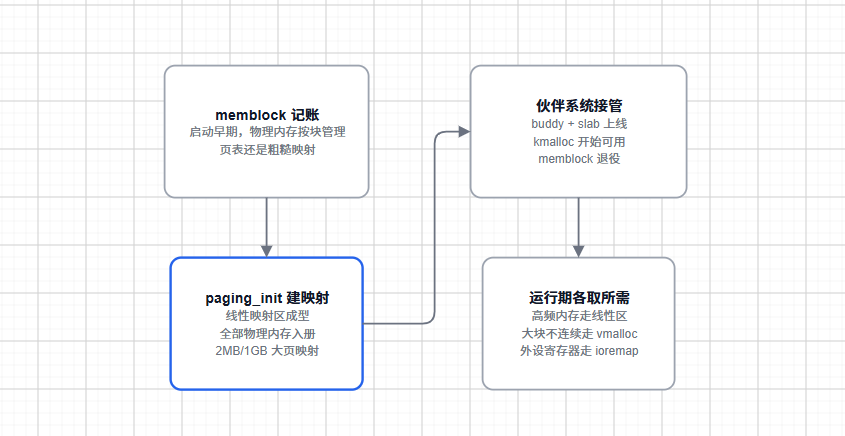
图 2:内核页表建立与内存分配器接管流程。图中 parging_init 应为 paging_init。
内核启动早期,页表还比较简单,物理内存由 memblock 记录和管理。随着 paging_init 等初始化流程完成,线性映射逐步建立,物理内存也被纳入后续管理。
对于地址和属性满足条件的区域,内核可以使用 2MB、1GB 等较大的映射粒度。具体能否使用大页,取决于架构、对齐方式、内存属性和内核配置。
为什么要尽量使用大页?TLB 条目有限,一条 2MB 映射覆盖的空间相当于 512 条 4KB 映射。线性映射通常范围大、属性相对统一,使用较大的映射粒度有助于减少页表和 TLB 的开销。
用户进程的情况则更复杂:代码段、堆、栈等区域可能具有不同权限,物理页也不一定连续,因此常用 4KB 页进行细粒度管理;满足条件时,用户空间同样可以使用大页。
启动阶段结束后,伙伴系统等分配器接管常规内存分配,memblock 的主要早期管理任务随之结束;其数据和内存是否完全释放取决于内核配置与实现。
2、vmalloc 拼装
线性映射本身按固定偏移对应物理地址。如果要求一段线性映射地址连续,对应物理地址也需要连续;但内核有些需求只要求虚拟地址连续,并不要求物理地址连续。
例如,模块加载需要内核虚拟地址空间,而相关内容和内存页未必在物理地址上连续。vmalloc 适合处理这类需求:它申请一段连续的内核虚拟地址,再将分散的物理页映射进去。
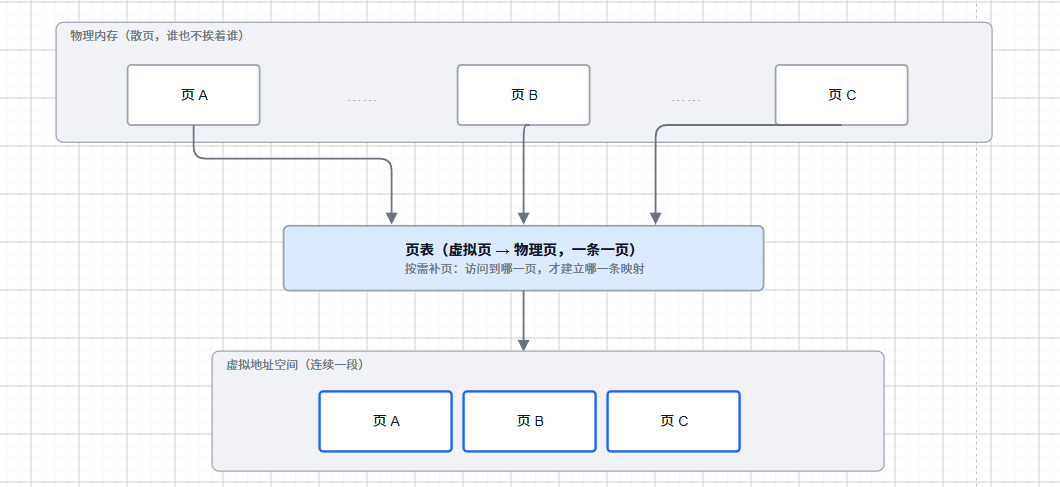
图 3:vmalloc 散页拼接示意。图中的“访问到哪一页才建立哪一条映射”不能概括普通 vmalloc 的分配行为。
原理可以概括为:虚拟地址连续,物理页可以不连续,由页表建立对应关系。CPU 使用虚拟地址访问内存,地址转换由 MMU 完成。
普通 vmalloc 通常在分配过程中就分配物理页并建立映射,并不是等到首次访问每一页才分配。某些架构和内核版本曾通过 vmalloc_fault 等机制处理内核页表映射的同步问题,这与按访问逐页分配物理内存不是一回事。
copy_from_user 则可能访问尚未驻留的用户页,从而触发缺页处理。缺页处理可能睡眠,因此在中断处理、持有自旋锁等原子上下文中,不能使用可能睡眠的常规用户内存访问路径。GFP_ATOMIC 是用于不能睡眠场景的内存分配标志,并不意味着可以在原子上下文中随意处理用户页缺页。
下面写一个最小模块,观察 vmalloc 分配得到的虚拟地址和物理地址。
// vmalloc_demo.c
#include <linux/module.h>
#include <linux/vmalloc.h>
#include <linux/mm.h>

static char *buf;

static int __init vmalloc_demo_init(void)
{
    int i;

    buf = vmalloc(4 * PAGE_SIZE);
    if (!buf)
        return -ENOMEM;

    pr_info("buf virtual: %px\n", buf);
    for (i = 0; i < 4; i++) {
        struct page *p = vmalloc_to_page(buf + i * PAGE_SIZE);
        phys_addr_t pa = page_to_phys(p);

        pr_info("page[%d]: virtual %px -> phys %pa\n",
                i, buf + i * PAGE_SIZE, &pa);
    }

    return 0;
}

static void __exit vmalloc_demo_exit(void)
{
    vfree(buf);
}

module_init(vmalloc_demo_init);
module_exit(vmalloc_demo_exit);
MODULE_LICENSE("GPL");
注意:查询 vmalloc 内存对应的物理页应使用 vmalloc_to_page;virt_to_phys 不适用于这种映射。
Makefile:
# Makefile
obj-m += vmalloc_demo.o
KDIR ?= /lib/modules/$(shell uname -r)/build

all:
    $(MAKE) -C $(KDIR) M=$(PWD) modules

clean:
    $(MAKE) -C $(KDIR) M=$(PWD) clean
准备好与当前运行内核匹配的构建文件后,编译并运行:
make
sudo insmod vmalloc_demo.ko
dmesg | tail
sudo rmmod vmalloc_demo.ko
一组 dmesg 输出示例:
buf virtual: ffff80000d210000
page[0]: virtual ffff80000d210000 -> phys 0x00000000f4a23000
page[1]: virtual ffff80000d211000 -> phys 0x000000008e47c000
page[2]: virtual ffff80000d212000 -> phys 0x000000003f09d000
page[3]: virtual ffff80000d213000 -> phys 0x00000000c8b56000
示例使用 4KB 页:虚拟地址按页连续增长,物理地址则不连续。这就是页表将散页拼成连续虚拟空间的效果。实际输出会因页大小、内存状态和运行环境而异,物理页也可能恰好连续。
3、有点小讲究
讲究一:内核映射通常由各进程共享。
在常见 ARM64 配置中,用户空间地址转换使用 TTBR0,内核空间使用 TTBR1。各进程通常共享内核空间映射,切换进程时主要切换用户地址空间;配合 ASID,可以减少不必要的 TLB 刷新。
这也有利于降低进出内核的开销。不过,具体页表切换行为还取决于架构实现、内核配置和安全缓解措施,不能一概认为所有情况下页表都不会变化。
讲究二:外设映射要使用合适的内存属性。
线性映射中的普通内存通常使用可缓存属性,外设寄存器则不一样。在 ARM64 上,普通 ioremap 映射一般使用 Device-nGnRnE 等设备内存属性;具体属性取决于所用接口和架构实现。
如果把 MMIO 当作普通可缓存内存访问,缓存、乱序或写入合并等行为都可能带来问题。这也是嵌入式调试中的常见坑:映射属性不对,外设行为就可能变得难以解释。
64 位红利
32 位时代,内核虚拟地址空间比较紧张。
以 x86 32 位经典的 3G/1G 划分为例,用户空间为 3GB,内核空间只有 1GB。受内核地址空间布局影响,超过低端内存可直接映射范围的物理内存会被作为 HIGHMEM 管理;常见配置下,这个低端内存范围约为 896MB。
内核访问这些高端内存时,需要通过 kmap 等接口建立映射,用完后再按接口要求释放,管理起来更麻烦。
到了 64 位,以前面讨论的 ARM64 48 位虚拟地址配置为例,内核高地址范围有 256TB,其中线性映射区约为 128TB。更大的虚拟地址空间使内核更容易直接映射物理内存,常见 64 位系统也不再需要 32 位时代的 HIGHMEM 机制。不过,实际可映射的物理地址范围仍受架构和内核配置限制。
来源
作者:情报小哥
 发表于 10 小时前
|
查看: 2|
回复: 0
 /1


