70 年的老算法 k-means 活跃在向量量化、检索索引和数据清洗等场景中,但大规模任务仍要反复扫描全部数据。
Meta 把 mini-batch、EMA(指数移动平均)和缩放定律重新组合,提出了 e-means。它只用 1.4~2.6 个 epoch,就达到了 Flash-KMeans 跑 25 轮的测试误差,墙钟时间最高加速 45.5 倍。
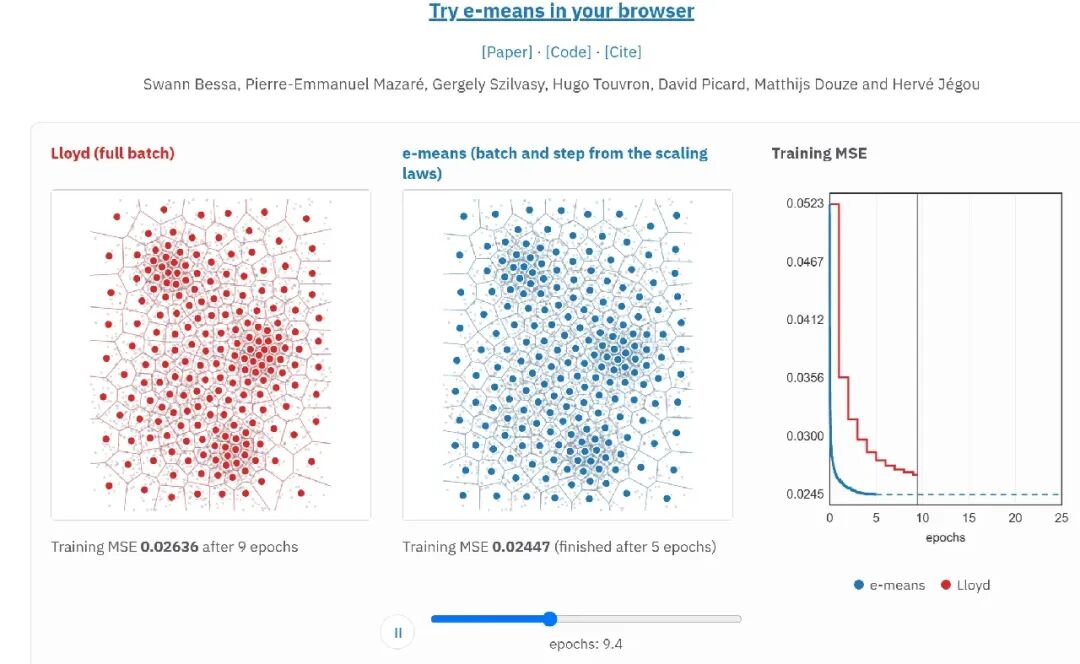
这次改进并不只是优化 GPU 内核,而是改写了优化过程本身:收敛更快,最终误差还更低。
代码已开源,位于 Faiss 仓库的 contrib/e_means 目录。
01 老算法的瓶颈:快与准难兼得
经典的 Lloyd k-means 每轮执行两步:先把全部样本分给最近的质心,再按归属重新计算均值。流程稳定,但每一轮都要对全量数据计算,通常需要多轮才能收敛。
mini-batch 版本能让误差更早下降,却常常停在更高的损失上。e-means 要解决的,正是这种速度与精度之间的取舍。
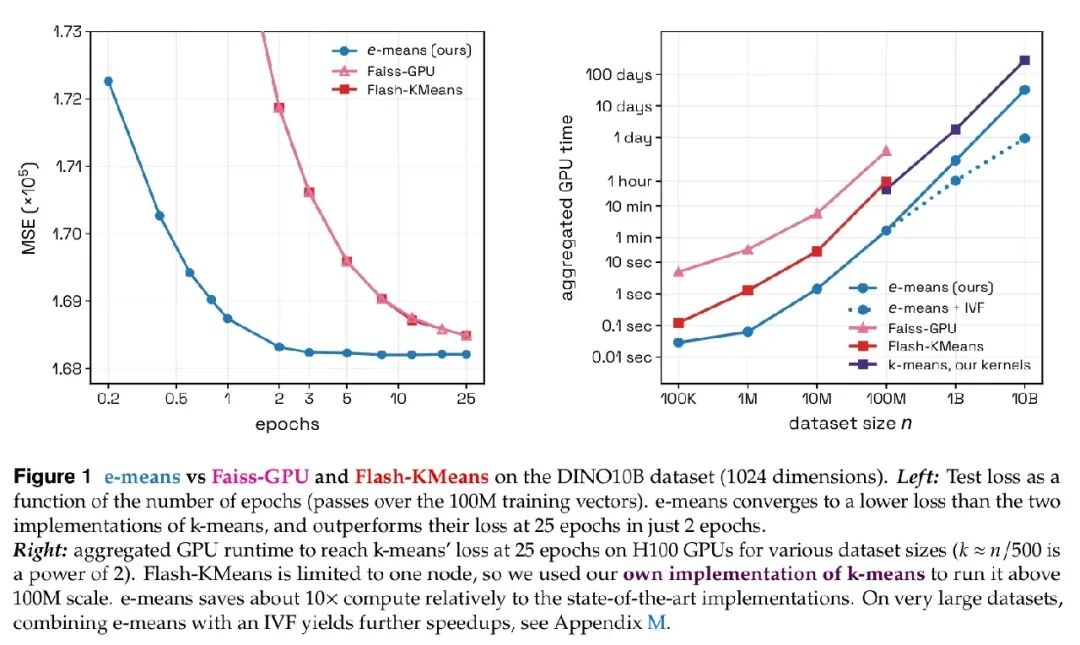
图 1:e-means 的收敛速度与 GPU 耗时
图 1 左侧显示,在 DINO10B(1024 维)数据集上,e-means 只用约 2 轮,测试损失就低于两种 k-means 实现跑 25 轮的结果。右侧给出了不同数据规模下的累计 GPU 时间,e-means 在各规模下都更省时。
02 核心改动:把全量均值换成 EMA 更新
e-means 不再等一整轮结束才移动质心,而是每处理一个 batch 就更新一次,具体分为五步:
- 先分配:样本仍归入最近的质心。
- 再滑动平均:分别更新各簇的计数 N 与向量求和 S,质心随时按
c = S/N 读出。
- 逐步降温:步长采用余弦衰减,前期移动快,后期更稳定。
- 救活死簇:每 5 个 batch 检查一次低计数簇,通过拆分供体簇让它重新被利用。
- 最后收尾:训练误差取末轮均值,泛化误差用慢速 EMA,额外开销很小。
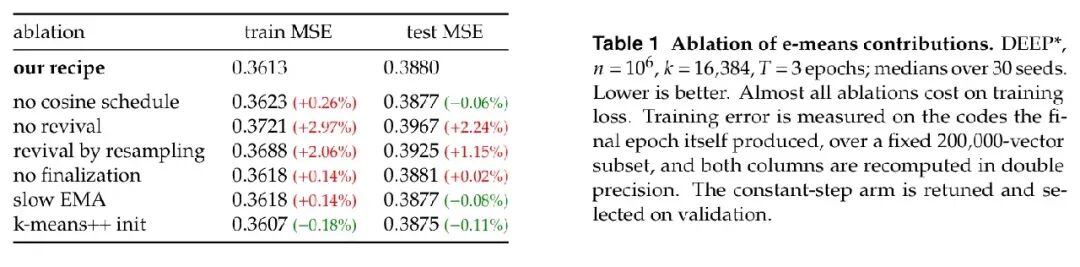
表 1:e-means 各组件的消融实验
哪个组件最关键?消融结果指向死簇复活。去掉它,训练 MSE 上升 2.97%,测试 MSE 上升 2.24%。k-means++ 初始化虽然略有收益,但顺序计算成本高,所以默认仍使用随机初始化。
03 不用扫参:把批大小和步长交给公式
以往 mini-batch 方法好不好用,很依赖调参。作者用 7.5 万次优化运行拟合了两条缩放定律,只需输入样本数 n、簇数 k、轮数 T 和批大小 B,就能自动给出峰值步长与批大小。
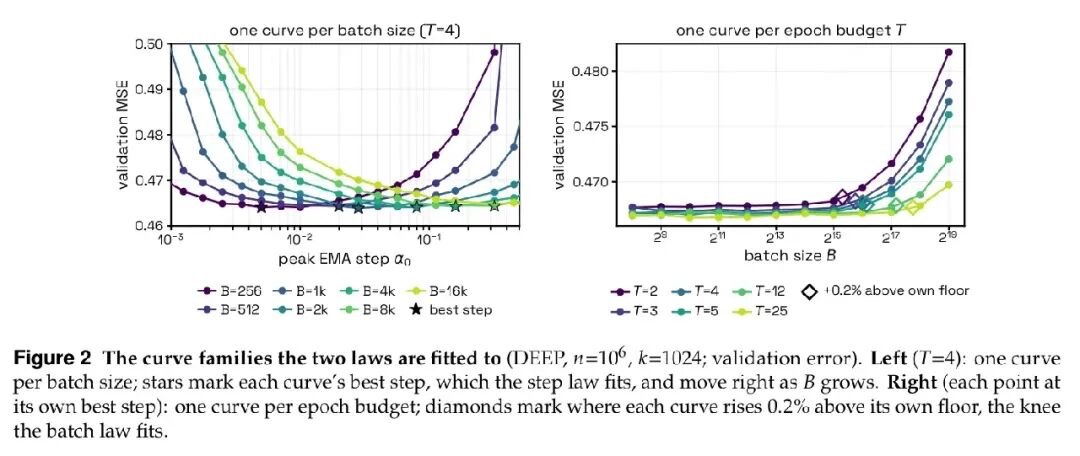
图 2:步长与批大小的缩放定律
图 2 左侧是步长的低谷:步长太小会欠训练,太大则不稳定。右侧用来找批大小的拐点,判定标准是误差比自身最低点高出不超过 0.2%。在留出数据集上,这条规则带来的额外 MSE 中位数为 0.19%,与设计目标接近。
这意味着调参不再靠反复试错,而是按问题规模直接计算。
04 45 倍怎么来的:是最高值,不是平均值
实验统一比较达到 Flash-KMeans 25 轮测试 MSE 所需的时间。e-means 只需 1.4~2.6 轮,对应 9.5~45.5 倍的墙钟加速。
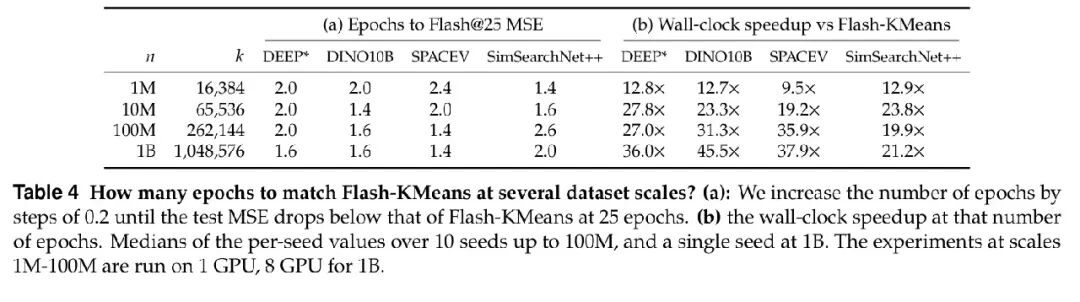
表 4:不同数据规模下的轮数与墙钟加速比
标题中的 45 倍来自 10 亿向量、1,048,576 个簇的 DINO10B 配置:e-means 用 1.6 轮达到基准误差,墙钟加速 45.5 倍。
看这组数字时要留意实验口径。1M~100M 规模取的是 10 个种子的中位数,1B 规模只有单个种子的结果,并且使用了 8 张 GPU。因此,45.5 倍是特定配置下的最高结果,不能理解为所有任务都能快 45 倍。
05 不只是跑得快,收敛质量也更好
如果只在早期领先,mini-batch 的老问题就没有真正解决。作者因此进一步比较了完全收敛后的损失分布,并加入了使用 k-means++ 初始化的 Lloyd 基线。
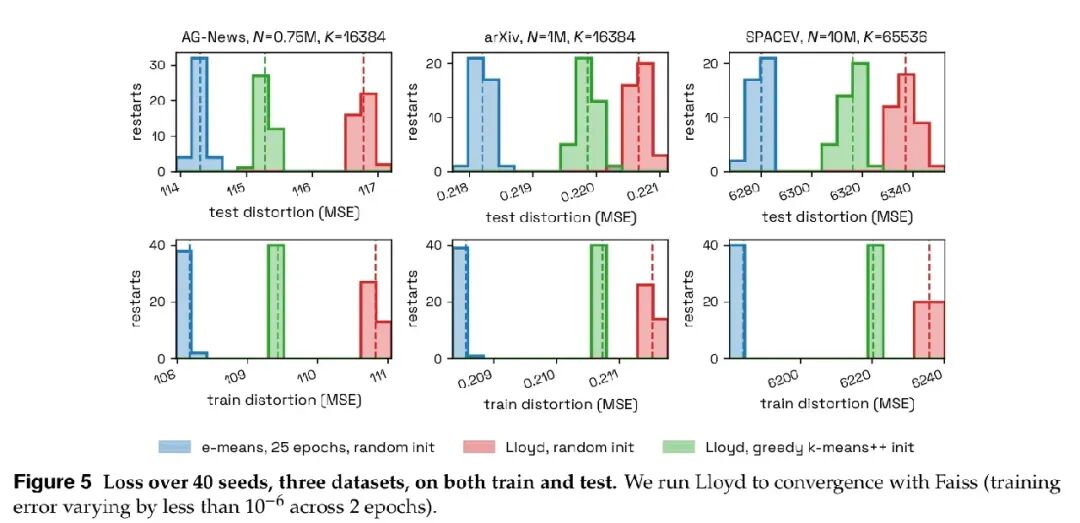
图 5:40 个随机种子下的收敛损失分布
图 5 覆盖 AG-News、arXiv 和 SPACEV 三个数据集,每个数据集 40 个随机种子。无论看训练误差还是测试误差,随机初始化的 e-means 都落在更低的区间,甚至优于带 k-means++ 初始化的 Lloyd。
这篇论文真正的突破,不在于单独换上 EMA,而是把 EMA、步长调度、死簇复活、自动配参和 GPU 实现做成了一套完整方案。
它也有适用边界:缩放定律主要面向高维嵌入,在极低维或超小数据集上不一定最优。对向量检索、量化和亿级数据聚类来说,e-means 更像一次可以直接落地的优化器升级,而不只是一项跑分纪录。
论文信息
- 论文:e-means: outperforming k-means (in one-tenth the epochs)
- 作者:Swann Bessa、Pierre-Emmanuel Mazaré、Gergely Szilvasy、Hugo Touvron、David Picard、Matthijs Douze、Hervé Jégou
- 单位:FAIR at Meta,École Nationale des Ponts et Chaussées
- arXiv:2611.09501
 发表于 6 小时前
|
查看: 0|
回复: 0
 /1


