前言
2026年初,加拿大外包巨头Telus Digital发布了一份调查报告,在安全圈引起不小的震动。受访的1000多名员工中,67%承认用个人账号访问生成式AI工具处理工作事务,其中57%还输入过公司敏感数据,包括客户信息、源代码和财务数据。
这组数字暴露的不只是某一家企业的问题,而是整个行业在AI浪潮面前,数据管控体系几乎全面失效的现实。
本文从这份报告出发,拆解"影子AI"的技术风险链条,分析企业现有安全架构为什么防不住,并给出基于2026年最新技术栈的落地方案。
目录
一、调查数据背后:到底发生了什么
二、"影子AI"的风险链条远比你想的长
三、现有企业安全架构为什么拦不住
四、2026年技术栈下的防御方案
五、落地建议:别只盯着技术
一、调查数据背后:到底发生了什么
Telus Digital这份报告的调查对象覆盖北美、欧洲和亚太地区的多个行业。几个核心数据值得拆开来看:
- 67%的员工使用个人账号访问ChatGPT、Claude、Gemini等工具处理工作内容。 这不是"偶尔用一下",而是已经形成了工作习惯。很多人每天打开个人版ChatGPT处理邮件摘要、写代码、整理会议纪要,就像十年前用个人QQ传工作文件一样自然。
- 57%的人往AI工具中输入过公司敏感数据。 内容包括客户PII(个人可识别信息)、内部代码仓库片段、财务报表草稿、产品规划文档等。有个真实案例:某半导体公司工程师把芯片设计的Verilog代码贴进ChatGPT,让它帮忙debug,而这段代码背后是几千万美元的研发投入。
- 超过30%的受访企业没有任何AI使用政策。 连纸面上的规定都没有,更谈不上技术层面的管控。
问题的核心不是员工"不守规矩",而是GenAI工具太好用,企业提供的替代方案要么不存在,要么体验差到没人愿意用。试想一下:用个人版ChatGPT三分钟搞定报告摘要,还是走内部审批等两天才拿到企业版AI的访问权限?答案不言自明。
二、"影子AI"的风险链条远比你想的长
不少管理者觉得"不就是用了个AI嘛,能有多大事"。实际上,敏感数据进入个人AI账号的那一刻,一条完整的风险链就已经启动了。
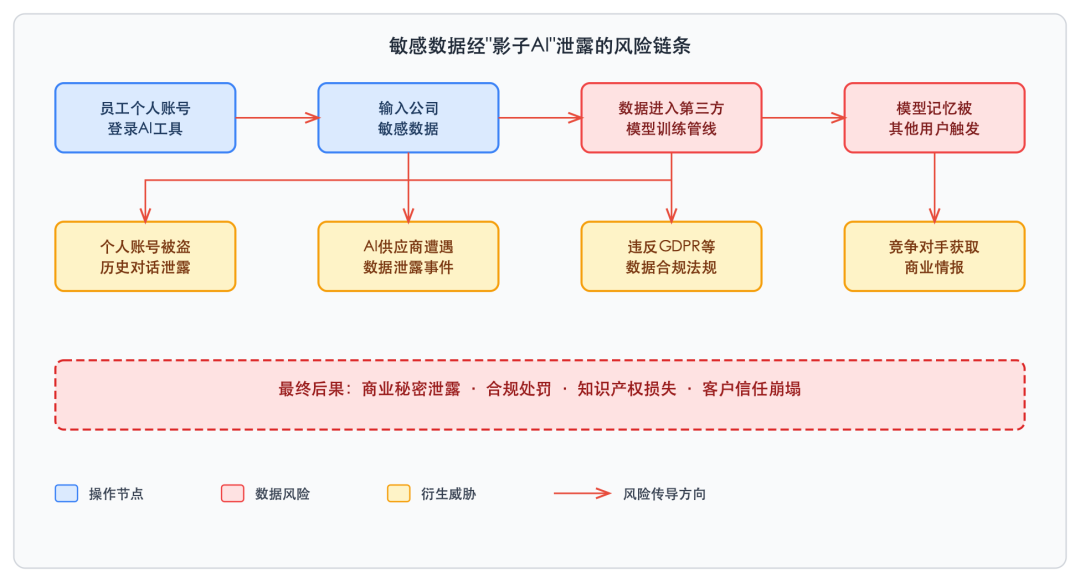
具体来讲,风险至少有三层。
第一层:训练数据污染。 个人版AI服务的用户协议通常默认允许将对话内容用于模型改进。贴进去的代码、客户名单、产品roadmap,都可能成为下一轮训练数据的一部分。各大厂商虽然都声称有脱敏机制,但2025年底Google和OpenAI先后被研究人员证明,可以通过特定prompt技巧从模型中"榨出"训练数据片段。
第二层:账号安全。 个人账号通常没有企业级的MFA强制策略和异常登录检测。员工的个人Gmail被钓鱼攻击拿下后,攻击者拿到的不只是邮箱,还有ChatGPT里几个月的工作对话记录,里面可能藏着数据库连接串、API密钥和内部架构图。
第三层:合规黑洞。 GDPR要求数据处理必须有合法基础和明确的处理者协议。员工用个人账号把欧洲客户数据丢给OpenAI,企业和OpenAI之间没有DPA(数据处理协议),这直接就是违规。2026年欧盟AI法案全面生效后,这类行为的罚款上限是全球年营收的7%。
三、现有企业安全架构为什么拦不住
传统企业安全体系建立在一个基本假设上:数据通过可控的通道流动,安全团队在通道上设卡拦截。GenAI把这个假设彻底打破了。
网络层DLP(数据防泄露)失效。 传统DLP靠关键词匹配和正则表达式识别敏感数据外传。但员工在浏览器里访问 chat.openai.com 时,输入框里的内容通过HTTPS加密传输,网络层DLP看到的只是一堆加密流量。就算用SSL解密中间人代理,AI对话的上下文语义也很复杂,关键词匹配的误报率高得离谱:拦下正常工作的次数比拦住真正泄露的多得多,最后安全团队自己都把告警关了。
终端DLP跟不上节奏。 终端Agent理论上可以监控剪贴板和浏览器输入,但AI工具的交互模式太灵活了:可以打字、粘贴、上传文件、拖拽,也可以用API调用,或通过浏览器插件自动发送。每一种方式都要单独适配,而AI工具每隔几周就更新一次界面,终端DLP的策略永远慢半拍。
访问控制形同虚设。 就算公司封了ChatGPT的域名,员工掏出手机照样能用,或者换个小众AI工具,安全团队连域名都不知道。2026年叫得上名字的GenAI SaaS就有上千个,还有大量开源模型可以本地运行。这样封得过来吗?
四、2026年技术栈下的防御方案
既然堵不住,就得换思路:疏堵结合,让员工在企业可控的环境里使用AI,同时在数据层面做好防护。下面是基于2026年技术栈的方案架构。
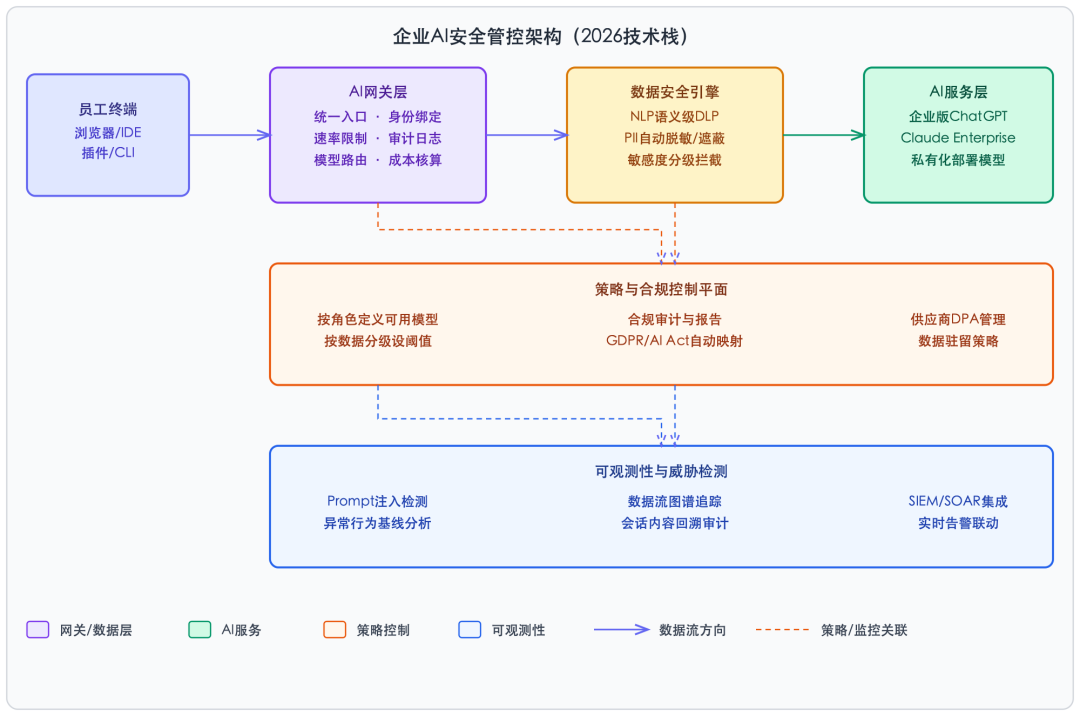
4.1 AI网关:统一入口是第一步
2026年这个领域已经出现了几个成熟产品,Cloudflare AI Gateway、Portkey、Kong AI Gateway都可以拿来用。核心思路是:所有AI调用都必须经过企业网关,不允许直连。 网关要做四件事:
- 身份认证:绑定企业SSO,消灭个人账号使用场景
- 流量路由:根据任务类型分发到不同模型
- 速率限制和成本控制
- 全量审计日志
技术上,网关以反向代理的形式部署,拦截所有发往AI API的请求。员工在IDE里用Copilot、在浏览器里用AI助手,底层的API调用都会被透明地导向网关。对终端用户来说,体验和直接使用没有区别。
如果企业需要同时接入多家模型厂商,也可以借助 RouteFast.ai 这类模型API中转服务统一管理调用入口,再叠加自己的审计与脱敏策略。
4.2 语义级DLP:从"关键词匹配"到"理解内容"
这是整个方案里技术含量最高的一环。传统DLP靠正则匹配"身份证号""信用卡号"这类固定模式,但对于自然语言描述的敏感信息,比如"张总上个季度给了王某150万的回扣",它根本认不出来。
2026年的做法是用小型语言模型(比如Llama 3.3 8B或Qwen3 4B)部署在网关侧,对每一条发送给AI的prompt做实时语义分析。模型经过微调,能识别出:这段内容里有没有客户PII?有没有商业秘密特征?有没有代码里嵌入的凭证信息?
检测到敏感内容后,系统会按预设策略执行三种操作之一:
- 放行:内容不敏感
- 脱敏后放行:自动把"张三 130xxxx1234"替换成"[姓名] [手机号]",AI处理完后再反向还原
- 拦截并告警:高度敏感内容直接阻断
这里要说一下性能问题:在网关侧跑一个推理模型,延迟会不会炸?实测下来,4B参数的模型在单张A10G上对512 token的prompt做分类,P99延迟在80ms以内,对交互式AI对话来说几乎无感。
4.3 私有化部署 + VPC隔离
对于真正高敏感度的场景,比如金融建模、药物研发、军工设计,最稳妥的方案还是私有化部署。2026年的好消息是,这件事的门槛已经大幅降低:
- Claude Enterprise的VPC部署选项(Anthropic 2026年Q1正式推出)支持模型完全运行在客户自己的AWS/Azure/GCP VPC内,数据不出租户边界。
- vLLM + 量化技术让70B参数的开源模型(如Llama 3.3 70B、DeepSeek-V3)可以在4张H100上跑出可用的推理性能,中型企业也能负担得起。
- Confidential Computing(机密计算)技术在2026年已经进入生产可用阶段。Intel TDX和AMD SEV-SNP支持在加密的可信执行环境中运行AI推理,即使云厂商的管理员也无法访问明文数据。
4.4 可观测性:看见才能管住
最后一个关键组件是AI使用的可观测性平台。企业需要知道:谁在用AI?用了哪个模型?发了什么内容?得到了什么回答?有没有异常模式?
这不是事后审计的问题,而是实时监控。比如某个财务部门的员工,连续三天在下班后大量向AI输入包含数字和公司名称的内容,这种行为基线偏离必须能被捕捉到。技术上,AI网关产生的全量日志要接入企业现有的SIEM系统(Splunk、Sentinel等),再配合专门的AI安全规则包做实时分析。
五、落地建议:别只盯着技术
技术方案能解决70%的问题,剩下30%是管理问题。几点建议如下。
先给替代品,再堵旧路。 在封杀个人AI账号之前,先把企业版AI平台部署好、测试好、推广好。如果员工发现企业版的体验比个人版还好(响应快、功能全、还不用担心合规),自然会迁移过来。三星在2023年那次著名的ChatGPT泄露事件后,花了18个月自建AI平台,2025年内部使用率达到了92%。
按数据敏感度分级管理,别一刀切。 市场部写个公众号文案,用公有云AI完全没问题;研发团队处理核心代码,则走私有化部署。把所有场景都按最高安全级别管,只会逼着员工重新回到个人账号上去。
定期做"AI使用摸底"。 Telus Digital这份报告之所以引发关注,是因为大多数企业根本不知道员工在怎么用AI。每个季度做一次匿名调查,摸清有多少"影子AI"行为在发生,比事后救火有效得多。
把AI安全纳入入职培训。 不是那种PPT念完签个字就算了的培训,而是拿真实案例(比如三星泄露事件、Telus Digital这份报告)让员工理解风险。很多人真的不知道个人版ChatGPT会用对话内容做训练,告诉他们,他们自己就不敢乱贴了。
67%这个数字其实不意外。GenAI已经是这个时代的"水电煤",不可能让员工不用。企业真正该做的,不是和人性对抗,而是把基础设施建好,让合规使用AI成为阻力最小的路径。技术手段已经够用了,剩下的就是决策层的认知和执行力问题。想系统了解更多相关技术,可以前往云栈社区的人工智能板块继续学习。
 发表于 1 小时前
|
查看: 3|
回复: 0
 /1


