前言
2026年11月,一个名为"America's AI Deployer Council"(美国AI部署者委员会,简称AADC)的组织正式亮相。它的成员不是OpenAI、Google这类模型开发商,而是沃尔玛、摩根大通、联合健康等七家在各自行业大量使用AI的企业。
它们的诉求很直接:AI监管规则不能只让"造锤子的人"说了算,"用锤子盖房子的人"也得坐上谈判桌。
这件事看似是一场政策博弈,背后折射的却是AI产业链上"开发"与"部署"两个环节之间日益加深的裂痕。谁更了解AI落地时的真实风险?谁更有资格定义"负责任的AI"?下面从技术架构和产业实践的角度,拆解这场话语权争夺战。
一、AI开发者 vs AI部署者:一条产业链上的两种视角
过去三年,全球AI监管讨论几乎被硅谷的模型公司主导。欧盟《AI法案》的分级框架、美国白宫的AI行政令,背后的技术咨询大多来自OpenAI、Anthropic、Google DeepMind这些公司。道理也简单:模型是它们造的,它们最清楚模型能干什么、不能干什么。
但"能干什么"和"实际怎么用"之间,存在巨大的鸿沟。
举个例子:一个大语言模型本身可能不会歧视任何人,但当沃尔玛把它接入招聘筛选系统,或者联合健康把它用在医疗理赔审核里,歧视风险就跟具体业务场景绑在一起了。
模型开发商可以说"我的模型在通用测试集上偏见指标很低"。部署者面对的却是另一类问题:"这个模型在我们内部40万条历史理赔数据上微调之后,对某些疾病编码的拒赔率异常偏高。"
AADC成立的核心逻辑就在这里:模型的通用安全不等于应用场景的安全,而后者只有部署者自己能评估。
二、AADC的七家成员与它们的AI实践
AADC首批七家成员涵盖零售、金融、医疗、物流、能源等行业,每家在AI应用上的投入都达到数亿美元量级。先看三个具体案例。
沃尔玛目前在供应链管理中部署了基于Transformer架构的需求预测系统,覆盖4700家美国门店的库存调度。2025年,这套系统帮助降低了12%的食品损耗。但它也出过事故:训练数据中缺少极端天气场景,导致飓风季备货严重不足。
摩根大通的AI用途更为敏感,包括用大模型做合同条款审查、反洗钱交易监控和信贷风险评分。2026年初,摩根大通公开披露,其内部LLM Ops平台已经管理超过600个生产级AI模型,每天处理约3亿次推理请求。
联合健康在医疗理赔自动审核上使用AI,每年涉及的理赔金额超过2000亿美元。2024年底,它因AI自动拒赔系统引发集体诉讼。这件事直接促成了联合健康在AI治理上的立场转变:与其让外部监管用不懂医疗业务的通用规则来管,不如自己主动参与规则制定。
其余成员包括联邦快递(物流调度优化)、雪佛龙(油气勘探数据分析)、迪尔公司(John Deere,农业自动化)以及洛克希德·马丁(国防领域AI应用)。
这些企业有一个共同特征:AI不是它们的产品,而是它们业务流程的核心基础设施。
三、监管分歧的技术根源:模型安全 ≠ 应用安全
开发者和部署者的监管分歧,本质上是两套技术评估体系的冲突。
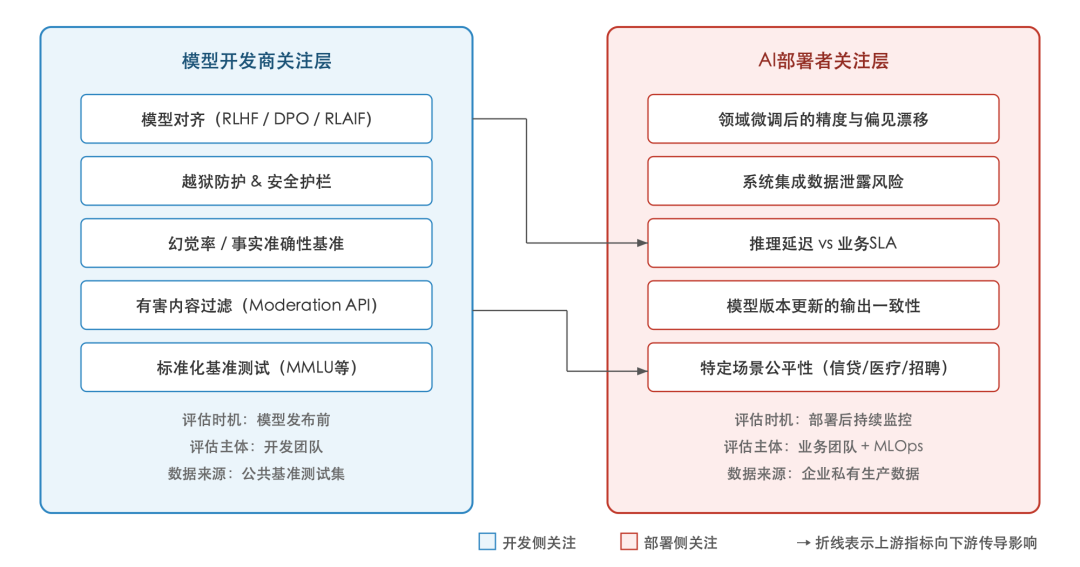
模型开发商关注的安全维度包括:
- 模型对齐(alignment)
- 越狱防护(jailbreak resistance)
- 幻觉率(hallucination rate)
- 有害内容过滤
这些指标在模型发布前,就可以用标准化基准测试(benchmark)来衡量,比如 MMLU、TruthfulQA、HarmBench 等。
部署者关注的维度则完全不同:
- 领域适配后的精度衰减
- 与现有IT系统集成时的数据泄露风险
- 推理延迟对业务SLA的影响
- 模型更新导致的输出一致性断裂
- 最棘手的一项:特定业务场景下的公平性问题
下图对比了两者关注点的差异:
一个很有说服力的案例来自摩根大通。2025年,OpenAI升级了 GPT-4o 的一个小版本,调整了 tokenizer 的处理逻辑。这个改动对绝大多数用户无感,但摩根大通的合同审查系统依赖特定的 token 边界来做条款分割,升级后出现了约3%的条款漏检率。整个排查过程花了两周,直接影响了数百份合同的审查进度。
这类问题,模型开发商不可能预见到。但在监管框架里,如果把责任全部压到开发商头上,要求它们为所有下游场景的安全负责,结果只能是开发商用更严格的使用限制来自保。这反过来会卡死部署者的创新空间。
四、部署者视角下的AI治理技术架构
AADC在成立声明中提出了一套"部署者主导"的AI治理框架。从技术角度拆解,它的核心是在模型API和业务系统之间建立一个AI治理中间层,把风险管控的主动权从开发商手里接过来。
下面是这套架构的概念图:
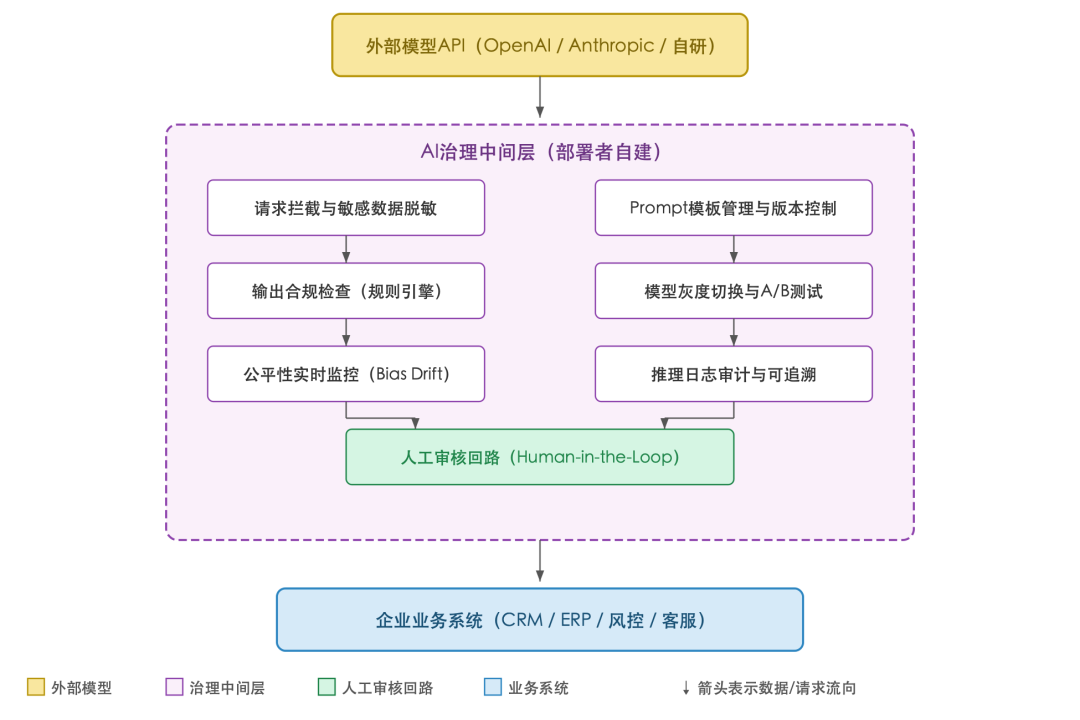
这套架构在技术上并不新鲜,2026年已有不少成熟的开源方案可以支撑:
- 请求拦截层:用 LiteLLM Proxy 做统一网关
- 敏感数据脱敏:Microsoft Presidio
- 输出合规检查:Guardrails AI 或 NVIDIA NeMo Guardrails
- 公平性监控:Fiddler AI 或 Arthur AI 的实时漂移检测
- 推理日志审计:接入 LangFuse 或 Weights & Biases Weave
关键不在技术实现,而在于谁来定义这些检查规则。AADC的立场是:规则应该由部署者根据自己的行业法规和业务场景来定,而不是由模型开发商一刀切地内置到模型里。
比如在医疗场景下,联合健康需要的公平性指标,和信贷场景下摩根大通需要的完全不同。前者关注不同病种、年龄段的理赔通过率差异,后者关注不同种族、收入水平的信贷评分偏差。如果让模型开发商在模型层面做统一的"公平性对齐",结果大概率是两边都不满意。
五、这场博弈对中国AI产业的启示
中国AI行业目前的监管格局,和美国有相似的结构性问题。《生成式人工智能服务管理暂行办法》主要约束的是模型提供方,而真正大规模使用AI的银行、保险、制造业企业,在规则制定中的参与度偏低。
2026年的中国市场有个很明显的趋势:越来越多的大型企业选择不直接调用外部大模型API,而是基于开源模型(如 DeepSeek-V3、Qwen3、GLM-5)做私有化部署。这种模式下,企业同时扮演"部署者"和"二次开发者"两种角色,模型安全和应用安全的边界也就更加模糊。
从实操层面看,有三点值得关注。
第一,AI治理中间层正在成为企业级AI架构的标配。 不管监管怎么定,企业自己都需要在模型和业务之间加一道"关卡"。2026年,国内已有几家云厂商(阿里云PAI、华为昇腾、百度智能云)把这层能力做成了产品化方案,提供从数据脱敏到输出审计的全链路治理工具。
第二,行业特定的AI评测标准,比通用 benchmark 更有实际价值。 金融行业的银保监系统已经在牵头制定金融场景AI模型评测规范,覆盖反欺诈、信贷评分、智能客服等细分场景。这个方向和AADC的诉求高度一致。
第三,部署者的技术话语权,需要技术能力来支撑。 AADC那七家公司之所以能组团发声,前提是各自都有几百人规模的AI工程团队,能独立评估模型质量、搭建治理系统。国内大部分传统企业还达不到这个门槛,短期内可能更依赖第三方AI治理服务商来填补能力缺口。
写在最后
AADC的成立不是在反对AI监管,而是在争论"谁来监管"和"怎么监管"。这群企业的潜台词是:让OpenAI来定义什么是"安全的AI",就像让药厂自己定义什么是"安全的药"一样荒谬,医院和药监局也得说上话。
这场争论没有标准答案,但有一点可以确定:随着AI从实验室走进生产线,"谁更懂AI的风险"这个问题的答案,正在从模型开发商向实际使用者一端倾斜。规则制定权的重新分配,只是时间问题。
 发表于 1 小时前
|
查看: 2|
回复: 0
 /1


