B200 显卡的估值被 Silicon Data 标到约 7.1 万美元。这个数字并不是二手成交价,而是按它继续运行、出租能带来的收益推算出来的。玩家买显卡关心还能跑多少帧,算力买家则会多问一句:它还能挣多少钱?
显存够大,还得喂得够快
B200 是 Blackwell 架构的数据中心 GPU。一次 DeepSeek-R1 对话背后,服务器要读取模型参数、进行大量矩阵运算,再逐步生成回答,B200 就能承担这些工作。
它通常在多卡服务器里协同运行。按 8 卡 DGX B200 的官方规格均摊,每颗 GPU 有 180 GB HBM3e 显存、8 TB/s 显存带宽。对比 H100 SXM 的 80 GB 和 3.35 TB/s,容量是 2.25 倍,带宽约 2.4 倍。
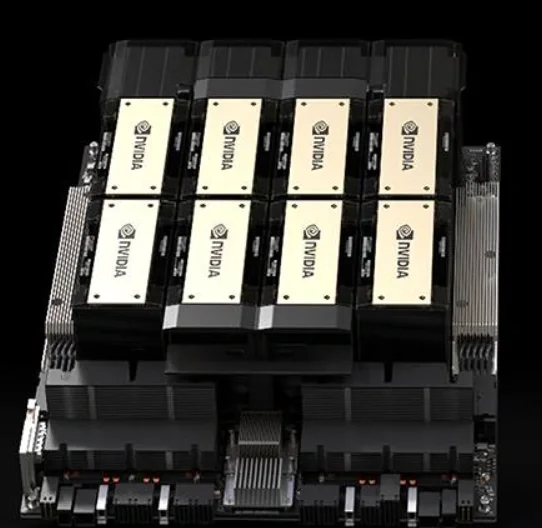
这两项提升,都关系到推理服务能接多少活。显存里要放模型参数,还要留出空间保存对话缓存。用户一起涌进来,或者一次塞进长文档,缓存需求都会增加。容量更大,部署模型和容纳并发请求就多了一些余地。
带宽则影响数据送到计算单元的速度。生成回答时需要反复读取数据,计算单元等得久,出字也会被拖累。不过,显存容量和带宽增加,并不意味着回答速度同比提升,实际表现仍取决于模型、软件和负载。
我更在意这些规格最后能换来多少有效产出。同一小时里,让更多用户以可接受的速度拿到答案,才有机会摊薄每次推理的成本,也给运营者支付更高租金留出空间。
七万美元,算的是未来的活
有了产出,才能往下算设备值多少钱。现金流折现的做法,是估算 GPU 剩余使用寿命内的租金收入,扣掉电力、机位、人工等运营成本,再考虑利用率随时间的衰减,以及资金的时间价值,折算成今天的金额。
这也解释了硬件老化与估值上涨为什么可能同时发生。假如租金预期提高,新增收益可以抵过老化带来的价值损耗。估值模型里,设备的剩余赚钱能力发生了变化。
会计折旧仍会照常计算,但用了几年的账面价值,未必能代表设备现在还能带来多少收益。
卡能到货,还得能开工
未来收入要落地,先得把 B200 用起来。
家用 GeForce 也能跑模型,B200 这类设备则需要服务器和机房配套。DGX B200 里的 8 颗 GPU 通过 NVLink 高速互联,整机最大功耗约 14.3 千瓦,供电与散热都要按整套系统安排。电力和散热没到位,GPU 再贵也只能待岗。
交付时间同样有价。假如新服务器还要等,二手设备却能更早交付、接入现有机房并承担订单,那么多付的钱,就可以与提前开工带来的收益一起算。
租用也得看何时可用、租多久。同样写着 B200,需要提前预留与立即可用,对赶上线的团队价值不同。
新卡进门,旧卡未必退休
即使顺利开工,今天的收入预期也不会一直固定。任务减少、利用率下降,或者电力与机位成本上升,都会压低未来收益。更高效的新硬件出现,也可能让客户用更少的钱完成同样的工作,影响 B200 的租金和估值。
不过,新卡上市并不会让所有旧卡同时失去用途。A100、H100 仍能承担较小模型推理、语音识别等任务。在机房里,资历老不等于能提前退休。只要既有设备做这些工作仍然划算,运营者就有理由继续用。
我会把稳定的任务量放在买卡之前。已经有活排着队,提前开工值得算账;项目还在试水,先租能少背一笔闲置成本。7.1 万美元的估值里,真正昂贵的,是那些被预期会持续到来的订单。
如果项目急着上线,你会为能立即开工的二手设备多付钱,还是先租算力等新机? |  发表于 昨天 23:16
|
查看: 2|
回复: 0


