从整体架构到子帧流水、编解码、传输与同步控制
一条音视频链路即使能够稳定处理每秒 60 帧,也可能显示着几百毫秒之前的画面。原因往往藏在缓冲、调度和交接边界里:采集等完整帧,编码等参考图像,网络等打包,接收等乱序恢复,显示等刷新。每个环节只多等一点,端到端延迟就会不断累积。
超低延迟设计的核心,是让同一帧的不同部分在不同模块中同时前进,并且给每一次等待设置明确的理由和上限。它同时要求数据正确、播放连续和尾部延迟可控。
从图像与声音产生,到远端屏幕和扬声器呈现,每一层都需要同时解决处理粒度、数据有效性和播放期限。下文以 Zynq 的 VCU 子帧路径为具体案例,逐层解释可迁移的设计原理。图中的抽象时序和预算属于示意或工程假设,不能替代整机实测。
01 从一帧画面的旅程理解延迟
1.1 延迟、吞吐和抖动分别描述什么
延迟是某一份内容从起点到终点经历的时间。吞吐是单位时间处理多少内容。抖动是延迟或到达间隔的变化程度。三个指标相关,但不能互相代替。
一个内部排队 6 帧、每秒稳定输出 60 帧的系统,吞吐可以完全合格,但仅这部分排队就可能贡献约 100 ms。另一个系统平均延迟很小,却偶尔停顿 100 ms,也难以承担持续交互任务。
帧周期由帧率决定:T_frame = 1000 / fps,单位为 ms。30 fps 对应 33.33 ms,60 fps 对应 16.67 ms,120 fps 对应 8.33 ms。这里表示相邻帧的时间间隔,不代表每个模块一定需要一个帧周期完成运算。
1.2 必须先定义测量边界
视频的完整边界应包括曝光、读出、ISP、内存、编解码、网络、显示扫描和面板。音频的完整边界包括 ADC、采集 DMA、算法、传输、播放 DMA、DAC;若测量到麦克风和扬声器,还要说明声传播距离。
滚动快门按行曝光和读出,屏幕也可能按行扫描。同一帧顶部与底部的测量结果可能不同,因此需要说明测量区域。一次光学变化跨越曝光窗口时,还会出现亮度积分和检测阈值问题。软件时间戳不是自动等价的光学时间戳。
工程上可先固定一个基线:1080p60、单路、8 bit NV12、受控有线网络、固定显示刷新率;然后分别验证分辨率、码率、网络和负载变化。没有边界定义的“低于 20 ms”难以比较,也无法复现。
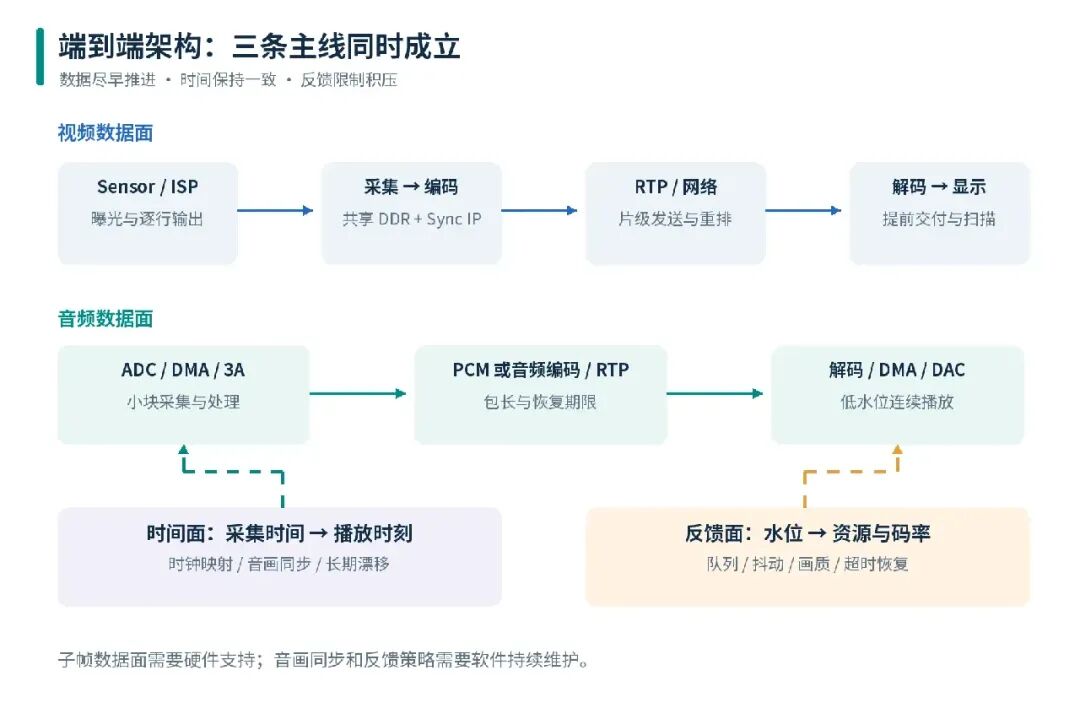
图1 视频与音频并行传输,共同依赖时间映射和反馈控制。Sync IP 位于采集与编码之间;显示侧采用另外的时序保护。
1.3 把延迟拆成处理、等待和呈现
对同一份可追踪内容,可以把沿途时间分成三类:真正计算或搬运的服务时间、排队或凑齐输入的等待时间、为了同步和输出硬件而产生的呈现时间。优化需要先判断属于哪一类。
减少代码计算量只能影响服务时间;降低 queue 水位针对排队;禁用未来帧前瞻针对数据依赖;切换低处理延迟面板则影响呈现。用一个编码器开关解决全部问题,通常不会奏效。
流水重叠后,端到端延迟应沿同一图像区域或同一声学事件的依赖路径计算。不能把各模块处理整帧的总时长全部相加,也不能把首片输出时间当成整帧可显示时间。首个可见像素、指定区域更新和完整画面更新,必须分别定义。
02 架构的三条主线:数据、时间和反馈
2.1 数据面负责尽早推进有效内容
视频路径是 Sensor/输入接口、ISP、采集 DMA、编码器、RTP 打包、网络、解包、解码器、显示控制器、面板。音频沿独立路径推进:ADC、DMA、3A、编码或 PCM 打包、网络、解码、播放 DMA、DAC。
在 Zynq 案例中,VCU 硬件承担视频压缩和解压缩,PL 组织采集、显示、同步及互连,PS 运行控制、驱动、媒体框架和网络等软件。具体 IP 与 DDR 拓扑要服从板级设计。VCU 不提供音频编解码,音频需使用独立的软件或硬件路径。
2.2 时间面负责让内容在正确时刻呈现
采集时间戳应描述内容产生的时间。编码完成时间、网络发送时间和显示提交时间描述的是处理进度。把这些不同含义的时间戳混在一起,会掩盖真正延迟,也会破坏音画同步。
时间面需要维护采集时钟、RTP 媒体时钟、接收端时钟和显示/声卡时钟之间的映射,并决定目标播放时刻。目标播放时间必须容纳可接受的处理与传输变化,但不能因为队列增长而无上限后移。
2.3 反馈面负责阻止延迟持续增长
反馈指标至少包括编码帧大小、实际发送速率、发送积压、网络丢包、到达抖动、解码耗时、显示错过刷新次数和音频缓冲水位。发现网络容量下降时,应调整码率、画质或帧率;发现 CPU 或 DDR 竞争时,应调整资源分配或负载。
仅扩大队列会把短暂不足变成越来越旧的画面。稳定系统必须满足长期处理能力大于输入负载,并为突发保留余量。优先级可以改变竞争顺序,但不能制造额外带宽。
2.4 硬件执行路径与控制路径分开考虑
媒体软件提交的是描述符、地址、格式、时间戳与任务参数;实际像素搬运和编码往往由 DMA、VCU 与显示硬件执行。CPU 占用不高,并不证明链路没有瓶颈:硬件可能正在等待 DDR,或者软件还没有提交足够的输出空间。
控制路径应提前准备后续任务和 buffer,使硬件尽可能连续运行;但已准备的 buffer 不应变成大量陈旧帧排队。硬件描述符深度、可用输出池和实际媒体积压应分别监测。
另外,Sync IP 解决生产与消费的地址进度关系,不负责端到端时间同步。它不能代替网络时钟校准,也不会自动让音频与视频的采集时间一致。
03 从帧级串行交接到子帧流水
3.1 四种模式的本质差异
以 VCU 为例,可以把低延迟能力分成四个层次。关键差别是模块之间按整帧交接,还是能按片或更小的区域推进。
| 模式 |
采集到编码 |
编码到解码 |
解码到显示 |
消除的主要等待 |
| Normal Latency |
帧级 |
帧级 |
帧级 |
常规缓冲与编码结构 |
| Reduced Latency |
帧级 |
帧级 |
帧级 |
输出重排序 |
| Low Latency |
帧级 |
slice 级 |
帧级 |
编码输出和解码输入的整帧交接 |
| Xilinx Low Latency |
子帧并行 |
slice 级 |
提前交付并行扫描 |
进一步减少采集和显示边界等待 |
普通 Low Latency 仍需采集完整帧后再交给编码器,也通常在解码完成后才交给显示。Xilinx Low Latency 进一步允许生产者和消费者同时访问同一帧缓冲,但需要专门保证访问安全。
3.2 流水线为什么能够变快
假设一帧分为 N 个等大小工作单元,经过 K 个阶段,每阶段处理一个单元的时间均为 τ。忽略启动开销、资源竞争和额外等待时:
- 每阶段等整帧:完成该帧约需 K × N × τ。
- 每单元及时交接:完成该帧约需 (N + K - 1) × τ。
例如 N=8、K=4,示意结果分别为 32τ 和 11τ。减少的是阶段之间的等待,计算本身并没有凭空消失。真实系统各阶段速度不同,最慢阶段会限制吞吐,启动门槛、跨块依赖和显示刷新还会增加延迟。
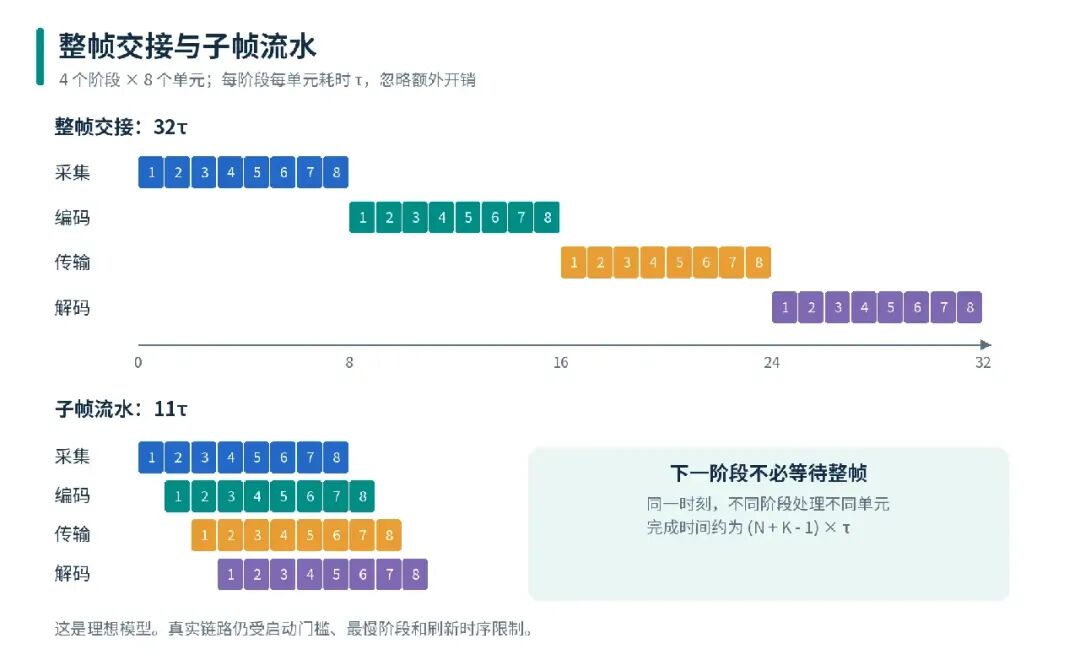
图2 每个小块代表一个工作单元,颜色代表处理阶段。图中单位为抽象时间 τ,不是 VCU 实测毫秒值。
3.3 三项能力不能混为一谈
零拷贝解决重复搬运;slice 输出解决码流生成后的交接粒度;子帧同步解决一帧尚未全部完成时的安全读写。系统可以同时支持零拷贝和多 slice,却仍然在某个模块等完整帧。
因此,验收必须逐个检查:采集是否提前交付、编码是否提前产生码流、网络是否立即发送、解码是否立即消费、显示是否具备安全的提前扫描能力。
04 Sensor 与 ISP:低延迟从图像产生时开始
4.1 曝光、读出与帧周期
曝光是像素积累光信号的过程;读出是把像素测量值输出到后级的过程。滚动快门不同图像行的曝光窗口存在时间偏移。缩短曝光可以减少运动模糊及时间积分范围,但不自动缩短整帧读出。提高帧率也需要 Sensor、接口、ISP、DDR 和后端同时承受更高负载。
时间戳需要绑定明确事件,例如帧起始、曝光起始或曝光中点;不能把 DMA 完成时刻直接命名为拍摄时刻。若要从帧起始换算到某一图像行的曝光时刻,应依据 Sensor 时序、行周期及曝光设置建立模型,并用外部信号验证。
4.2 ISP 中最容易隐藏的帧等待
空间滤波通常只需要局部行窗口,但时域降噪需要历史图像,某些多帧 HDR、去交错、畸变校正或电子防抖实现还可能引入额外帧缓存。算法名字并不能决定延迟,需要查看该实现的数据依赖和输出时机。
检查 ISP 的每个节点:输入最少需要几行或几帧,输出是否允许逐行推进,是否插入格式转换或额外缩放,输出 buffer 是否只能在帧尾完成。若 ISP 已经缓存整帧,后级 Sync IP 只能优化其后的等待。
4.3 行缓存的直观估算
若某滤波器必须等待 r 行、输入行周期为 T_line,则启动等待的量级是 r × T_line。实际还要加内部计算和握手开销。这个估算有助于区分“几十行窗口”和“整帧缓存”的差别,但不能忽略消隐、像素打包和时钟域转换。
05 共享内存与 Sync IP:提前读,怎样仍然正确
5.1 普通帧缓冲的交接方法
常见 V4L2 采集路径先提交空 buffer,DMA 写完整帧,驱动报告完成,再由应用或媒体框架交给编码器。上半帧可能很早就已写好,却仍然等待最后一行。
VCU 的定制子帧路径允许采集与编码共享同一个尚在填充的 buffer。Sync IP 监视生产者写入,对编码器读请求进行 AXI 事务级控制:目标区域可安全读取就放行,否则暂缓该读取。它不是 CPU 自旋等待,也不是把整帧复制到另一个缓冲区。
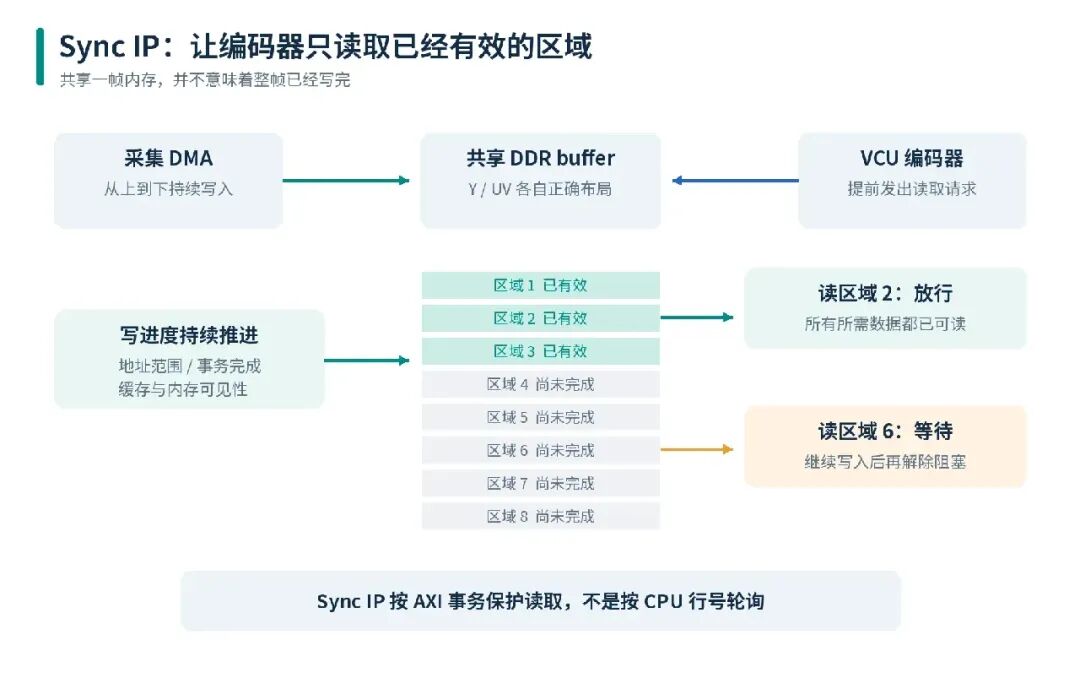
图3 行号用于解释进度,实际实现按照 AXI 事务和配置的地址范围跟踪;亮度、色度及对齐必须分别正确处理。
5.2 early dequeue 的真正含义
流程可概括为:先配置当前缓冲区的同步地址范围,再提前把 buffer 交给编码器;编码器提交读取,采集端填充数据,Sync IP 使编码器只能读到已经准备好的区域。
提前交付只表示后级可以在同步机制保护下使用该 buffer,并不表示整帧已经完成。early dequeue 和 OMX 提前回调用于表达这种提前交接,后续实际完成事件仍需单独处理。
这不是标准 V4L2 任意驱动都具备的行为。普通驱动直接提前调用完成通知,会破坏已有的完成语义;没有配套硬件同步和媒体组件支持,可能读到旧数据或正在更新的数据。
5.3 缓存一致性、完成同步、生命周期是三件事
| 问题 |
需要的机制 |
不能代替它的东西 |
| 两个设备如何共享内存 |
DMA-BUF 导入导出、各设备 DMA 映射 |
一个 CPU 虚拟地址 |
| CPU 与设备如何看见正确内容 |
正确缓存属性和 DMA API 协议 |
仅仅传递文件描述符 |
| 设备是否已经产生所需数据 |
完成事件、fence 或子帧进度保护 |
cache flush |
| buffer 何时能够回收 |
引用和在途任务生命周期管理 |
early callback |
| 行布局如何解释 |
stride、offset、format、modifier 等元数据 |
仅宽度与高度 |
Linux DMA-BUF 框架支持跨设备共享,dma-fence 表达异步硬件操作完成,dma-resv 管理相关 fence。但默认按一次完整任务通知的 fence,不会自动描述“前几行可读”。子帧访问需要额外的进度协议。
设备 DMA 地址也不一定等于 CPU 物理地址。IOMMU 存在时,不同设备可能使用不同的 IOVA 映射。不能把一个设备看到的地址未经验证直接交给另一个设备。
5.4 NV12 为什么不能只盯着亮度进度
NV12 包含 Y 平面和交错 UV 平面。编码器处理某个区域时,需要的亮度和色度都必须有效。色度垂直采样率、行跨度、平面偏移、对齐与编码块访问范围都会影响安全边界。
一般正确性条件是:消费者即将读取的整个区域,都已经被生产者写好并满足内存可见性要求。单一行号比较只是概念示例,不能替代实际硬件地址和事务规则。
5.5 零拷贝依然消耗 DDR 带宽
1080p NV12 的有效图像大小约为 1920 × 1080 × 1.5 = 3.11 MB。60 fps 下,一个完整读或写方向约为 186.6 MB/s。4K60 对应约 746.5 MB/s。
仅采集写、编码输入读、解码输出写、显示读四个方向,若落在同一个系统内,就分别达到约 0.75 GB/s 和 2.99 GB/s。这还未包含参考图像、重建、码流、对齐填充和其他业务。若发送端、接收端分板,应分别计算各板带宽,不能将四个方向全部归到一块板上。
所以零拷贝减少额外复制,却不会消除设备必要的内存访问。最坏带宽和服务延迟必须实测。
5.6 一个共享 buffer 的完整生命周期
普通完整帧路径的生命周期近似是:空闲、采集写入、采集完成、编码读取、读取完成、回到空闲。子帧路径改变的是采集和读取可以重叠,回收条件并没有因此消失。
必须同时确认生产者已经停止写入、消费者已经结束读取、没有显示或其他下游继续持有引用,才允许复用原始图像内存。不同驱动回调的语义不同:码流片输出不代表编码器不再需要原始图像;early callback 更不代表数据全部完成。
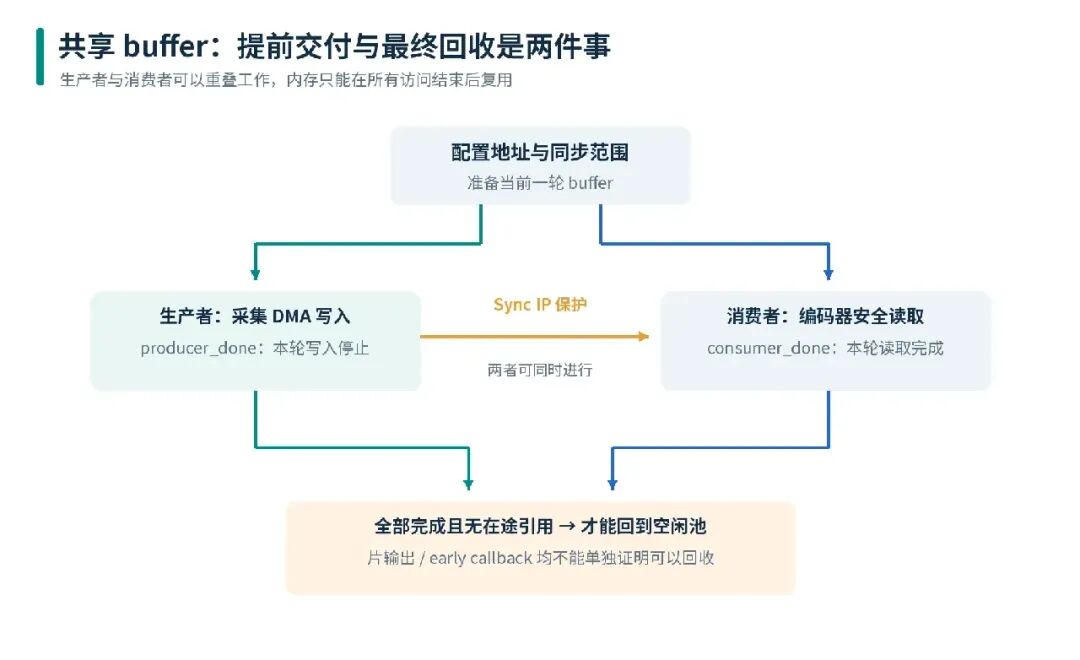
图4 “允许提前使用”和“允许回收”是不同事件。生产者与消费者各自完成后,仍需检查其他在途引用。
概念上可使用独立的状态和引用记录:producer_done 表示本轮写入已停止,consumer_done 表示本轮读取已完成,inflight_refs 表示仍在持有该内存的任务数。只有全部满足回收条件,buffer 才能重新进入空闲池。真实驱动需要锁、原子操作或对应硬件同步,不能把几个无保护布尔变量当作实现。
停止链路时也要按依赖排空:停止继续提交,取消或等待在途任务,解除下游持有,关闭同步通道,最后撤销映射和释放内存。若设备仍在 DMA 时就释放 buffer,可能损坏其他内存,而不只是出现一帧花屏。
5.7 为什么内存屏障不能替代同步 IP
内存屏障约束规定范围内的访问顺序,缓存维护解决数据可见性;二者都不会凭空生成尚未采集的像素。CPU 执行一次屏障之后,采集 DMA 可能仍然只写了图像前半部分。
子帧并发需要把“哪段数据已经产生”表达给消费者,并在设备访问入口真正限制读取。没有硬件进度保护或经过验证的等价协议时,应保留完整帧完成边界。
06 编码原理:哪些依赖会产生等待
6.1 编码器不是简单压缩一个文件
视频编码利用空间与时间上的重复信息。帧内预测根据同一图像中已重建的邻近区域预测当前块;帧间预测根据参考图像及运动信息预测当前块。预测与原始信号的差值叫残差,残差经过变换、量化和熵编码形成码流。
编码器还需要重建图像:把量化后的信息反向还原,与预测相加,经过环路处理后保存为参考。这样编码器与解码器才能依据相同重建结果预测后续内容。
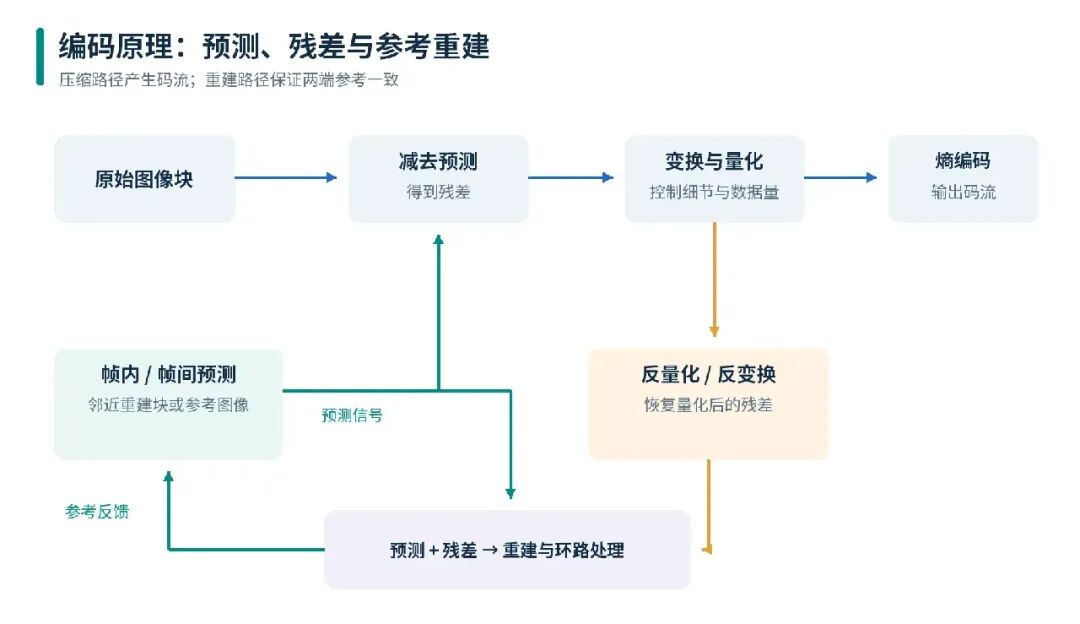
图5 参考图像存储和输出排队的用途不同。无 B 帧也仍然可能需要参考图像。
压缩收益可以用原始带宽直观理解。1080p60、8 bit NV12 的有效图像速率约为 1.49 Gbit/s,而网络视频通常只有其中一小部分。节省的大量比特,来自预测、残差量化和熵编码;它也带来了参考依赖、画质损失以及复杂度变化。
QP 是量化强度的控制量之一。较强量化通常让更多细小残差信息被抑制,从而减少码流,但纹理与细节也更容易损失。低延迟码控在复杂帧里提高 QP,本质上是在画质与及时发送之间做取舍。量化、码率与视觉质量并非对所有内容都保持简单线性关系。
6.2 H.264 与 H.265 不能按名字决定延迟
H.264 以宏块及其子划分组织预测等处理,H.265 使用 CTU 及递归编码块划分,并扩展预测、变换和环路处理能力。HEVC 通常能在相同视觉目标下节省码率,但具体效率取决于内容和配置。
更复杂的编码工具可能增加运算与依赖,但硬件实现、并行度和缓冲策略同样关键。某些硬件实现中 HEVC 的流水与缓冲设计甚至比 AVC 更适合低延迟,因此不能从算法名称直接推断产品延迟。
选择编码标准时应同时测量:相同画质下的码率、首片输出时间、末片输出时间、最大帧大小、解码兼容性和最坏处理时间。只比较相同码率下的平均编码时间不够完整。
6.3 B 帧、重排序与前瞻
若显示顺序为 I0、B1、B2、P3,且 B1/B2 参考未来的 P3,编码过程必须先获得 P3,解码顺序也需要配合这种依赖。未来参考和输出重排序会增加延迟。
本文的低延迟基线采用 Low-delay-P、B 帧为零,消除未来帧等待。一般标准中存在不同参考结构,但不能把“所有 B 图像都必然增加相同帧数”当成通用公式,应查看实际参考关系和解码输出约束。
Look-ahead 为更好的码率或场景决策预先分析后续图像,会引入额外前瞻等待。双遍编码将统计分析与正式编码分开,可能用于优化质量或码率分配;实时前瞻也需要先观察后续内容。以最低稳态延迟为目标时,必须核实模式约束及等待深度,不能只因为硬件支持就直接开启。
6.4 GOP、I 帧、IDR 与 GDR
| 概念 |
作用 |
与低延迟的关系 |
| GOP |
描述一组图像的编码组织 |
长 GOP 不等于稳态必须等整组 |
| I 图像 |
使用帧内编码 |
大小可能明显高于 P 图像 |
| IDR |
刷新参考关系的随机接入点 |
有助恢复和加入,但可能产生较大突发 |
| GDR |
在连续图像中逐步帧内刷新 |
分摊刷新负担,恢复完成需要过程 |
不是每一个 I 图像都与 IDR 具有同样的参考刷新语义。GDR 也不能简单当作“每帧都能独立解码”。接收端加入与错误恢复需要参数集、恢复语义和编码器的参考限制配合。
频繁 IDR 可以缩短等恢复点的时间,却可能产生更多码率峰值。更长 GOP 可以提高压缩效率,却会影响随机接入与错误传播。GOP 决策必须与丢包恢复策略一起设计。
6.5 参考关系决定丢包后的影响范围
对于 I0、P1、P2、P3 的参考链,即使每一帧都是按时编码,没有未来帧等待,后续 P 图像仍可能依赖前面重建的内容。P1 损坏后,解码器若使用错误隐藏继续重建,偏差可能被 P2、P3 沿参考链带下去。
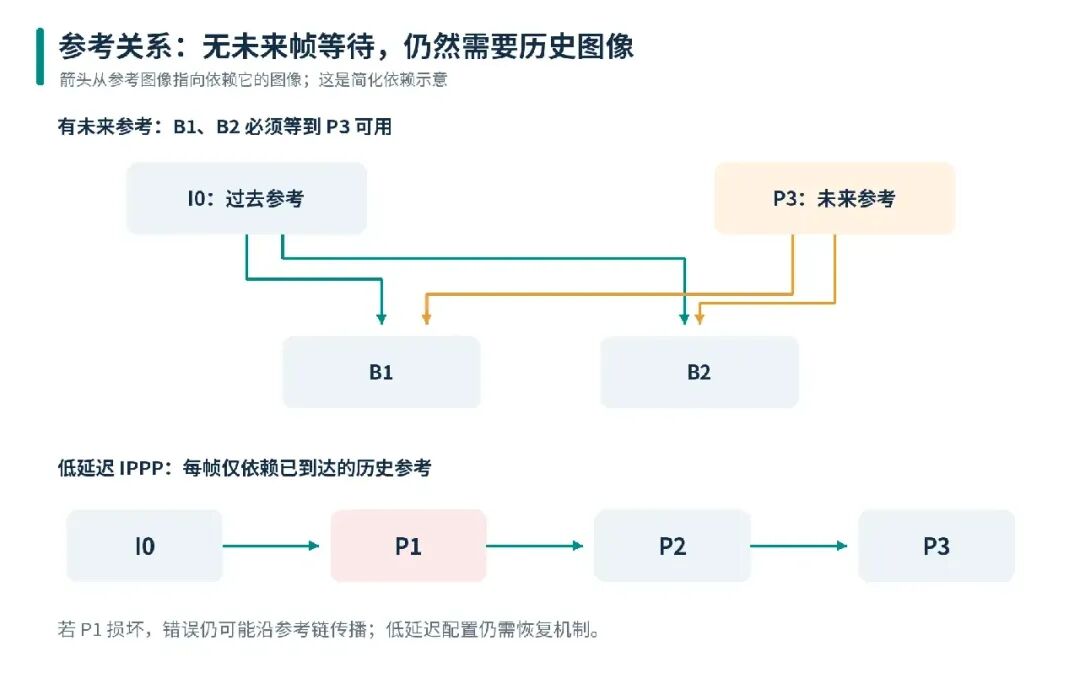
图6 上图展示需要未来参考的 B 图像为何产生等待;下图展示无 B 帧后仍存在的历史参考依赖。箭头表示参考内容流向被预测图像。
全 I 编码减少跨帧参考依赖,但通常需要更高码率,可能把瓶颈转移到网络与 DDR。IPPP 配合受控刷新通常更节省带宽,但需要处理错误传播。两种方式不能只比较编码时间,还要同时比较发送时间、画质和恢复成本。
当丢包发生时,接收端可丢弃不完整图像、使用错误隐藏,或请求刷新;发送端决定插入 IDR 或按受支持的渐进刷新流程恢复。刷新帧本身可能产生突发,因此需要避免多个接收端请求导致连续大帧。
07 Slice、NAL、AU:子帧链路的交接语言
7.1 Slice 不是一个网络小包
Slice 是编码语法上的一部分图像区域。NAL unit 是携带编码语法的封装单元,内容可以是 slice、参数集或其他信息。AU 是与一幅编码图像相关的一组访问单元数据;在本文的逐行单层视频场景,可近似按一幅图像理解。
网络包按 MTU 和传输协议组织。一个 slice 对应的 NAL 可能需要多个 RTP 包传输,也可能一个 RTP 聚合包承载多个小 NAL。四者不能简单画等号。
7.2 Slice done 使后续工作提前开始
VCU 的低延迟编码器在片完成时产生 slice_done,提前输出相应码流。后级可以发送第一片时,编码器继续处理第二片;接收端处理第一片时,发送端还在生成末尾的片。
60 fps、8 片时,帧周期除以片数约为 2.08 ms。这只是均匀片级推进的尺度。实际 slice 的编码块行对齐、复杂度和码流大小都不均匀,编码器还可能存在启动门槛,因此不能把 2.08 ms 写成必然的编码延迟或整机延迟。
7.3 分片多也有代价
增加 slice 可减少交接等待,同时增加头部、调度、回调和网络处理开销,并可能降低压缩效率。HEVC 的 slice、dependent slice segment、tile 和 WPP 也不是同一概念;并行解码工具不自动等价于已具备片级输出接口。
在这类 VCU 路径中可以从 num-slices=8 起步,分别测量 4、8、16 片等受支持配置的首片时间、尾部耗时和码率。更多分片的收益会逐渐受开销限制,其他硬件应从实际支持范围和测量结果出发。
7.4 alignment=nal 需要贯穿必要边界
如果编码器已经按 NAL 输出,而 parser 或解包器又把所有 NAL 拼成完整 AU 才继续,前面的优化就会被抵消。应检查每个组件的协商格式、输入输出 buffer 边界和实际触发时间。
NAL 对齐也不保证接收器一定无需等待帧尾:某些实现需要完整 AU 才提交解码,某些实现对最后 NAL 的边界识别依赖后续数据。必须用逐片时间戳证明链路真的在推进。
7.5 Slice 的局部独立性有边界
独立 slice 可以限制一部分帧内预测或熵编码依赖,但它仍可能使用历史参考图像。HEVC 的 dependent slice segment 还可能继承前一片段的部分上下文。因此“收到一片”不等于任何解码器都能在完全没有上下文的情况下处理它。
重建像素也可能需要环路滤波。若配置允许跨 slice 边界处理,某个边缘区域的最终可读时刻可能晚于其原始块重建时刻。显示保护应该使用处理完成后的可读边界,而不是只观察某个中间阶段的写入。
这种差别在花屏定位时很关键:码流 slice_done 只说明相应输出阶段完成,不表示该图像已经可被远端完整显示,更不表示参考图像可以立即释放。
08 码率控制:把网络突发纳入编码设计
8.1 平均码率合格,队列仍会增长
8 Mbit/s、60 fps 的平均每帧大小约为 16.7 kB,但某个复杂帧可能达到 100 kB。若可用发送速率为 20 Mbit/s,该帧仅串行发送就需要 40 ms。把它称作“8 Mbit/s 视频”并不能消除这次突发。
简化模型为 T_serialize = B_bits / C_bps。链路有效容量要扣除协议开销和竞争流量。slice 可以让发送更早开始,但不会让总字节数消失。
8.2 CBR、低延迟码控与 CPB
CBR 通常约束某一时间尺度的速率,不代表每帧同样大,更不代表以太网线上每毫秒发送的字节数完全一致。低延迟码控需要更积极地控制帧大小与突发,代价可能表现为复杂画面 QP 增大、细节减少。
CPB 是压缩图像缓冲模型,HRD 描述假想参考解码器的缓冲与移除时序;DPB 保存解码图像,承担参考和可能的输出重排序;网络 jitter buffer 用于包的乱序与到达变化。三者位于不同层面。
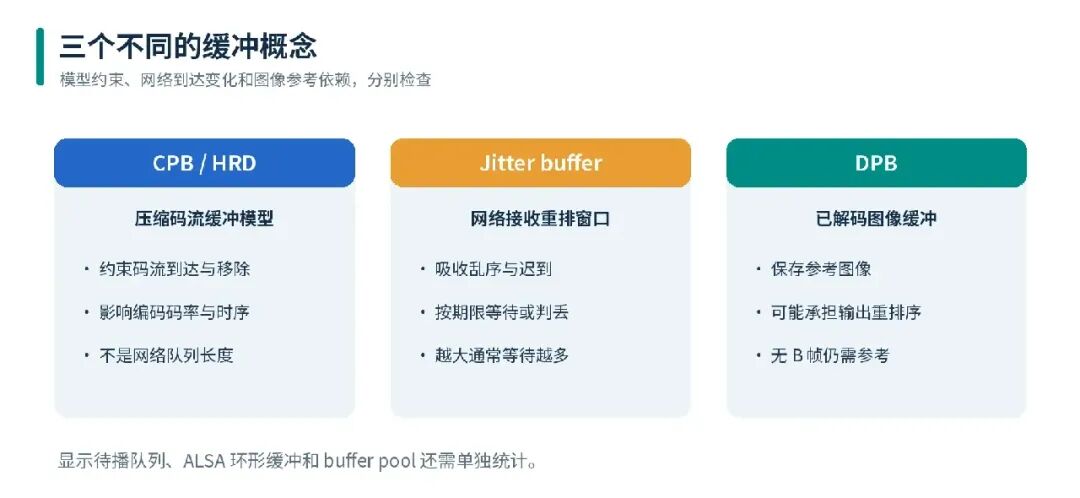
图7 应分别检查编码模型约束、网络等待、参考存储和显示排队,不能用一个“buffer 大小”概括全部延迟。
例如 cpb-size=500、initial-delay=250 是 HRD 参数,单位为毫秒。它们不是 GStreamer queue 长度,也不是 jitter buffer 的等待设置。实际播放是否按该时序等待,取决于接收实现;低延迟配置不能脱离码流约束、缓冲稳定性和互操作要求任意修改。
8.3 帧大小上限与动态码率
从架构看,限制单帧大小有助于约束网络串行发送和队列增长。可以先按可用容量与预算建立约束:B_frame_bits ≤ C_effective × T_send_budget,再检查画质是否可接受。这个式子是预算条件,不是对任意编码器行为的保证;复杂内容下还要处理超限或质量下降。
部分编码器提供 MaxPictureSize 或类似能力,但设置位置、单位、是否可动态修改以及适用码控模式取决于实现。不能把底层控制库能力直接写成一个假定存在的媒体插件属性。
动态码率调整有收敛过程。网络反馈环需要平滑、滞回和变化速率限制,不能每看到一个异常包就剧烈改变编码器。带宽下降时先抑制持续积压;恢复时逐步增加质量,观察帧大小与网络水位是否稳定。
8.4 用队列方程解释延迟增长
设某段时间内产生 B 比特,发送能力为 C 比特每秒,时间跨度为 Δt 秒,队列已有 Q 比特。忽略细节的水位关系为:Q_next = max(0, Q + B - C × Δt)。对应排队时间量级为 Q / C。
例如网络可用速率持续为 10 Mbit/s,编码器却持续产生 12 Mbit/s,每秒会新增约 2 Mbit 积压。1 秒后仅这些积压就对应约 200 ms 的额外排队。把 socket buffer 扩大只会推迟丢包,无法恢复实时性。
实际码流不是均匀流,slice 输出还会形成短时突发。因此需要同时约束长期平均负载和短时峰值;如果大 I 帧连续到达,平均值尚未明显改变,短时队列也可能已经超出播放期限。
09 传输设计:及时发送,有限等待,按期限恢复
9.1 RTP/UDP 的基础路径
受控局域网可使用 RTP/UDP 作为便于观察的基线。RTP 提供序号、媒体时间戳和载荷类型等信息;UDP 保留报文边界,但不保证送达和顺序。应用仍需负责乱序、丢包、截止时间和拥塞响应。
H.264 与 HEVC 分别具有自己的 RTP 载荷格式和分片规则,不能把一种格式的分片头直接用于另一种编码。单个 NAL 太大时使用相应分片机制;需要重组完整的相关 NAL 后再按解码器支持能力推进,不应误把 IP 分片当作媒体层分片方案。
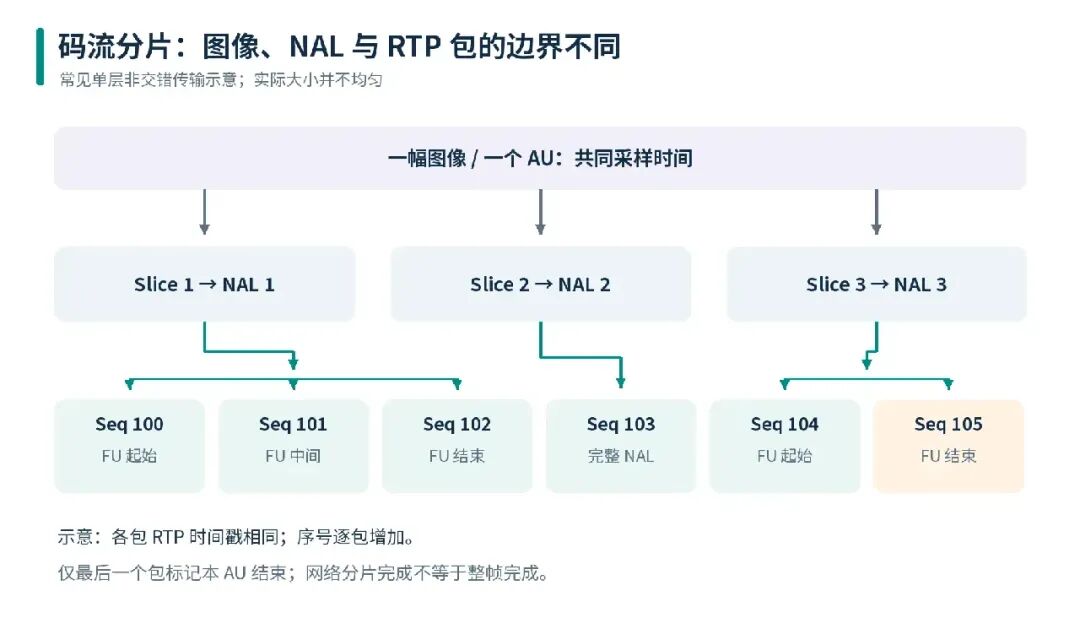
图8 同一图像的包保持一致的媒体时间语义,序号随包推进;最后一个 slice 的最后一个 RTP 包才对应此图像的结束标记。图中只展示单层、非交错的常见情形。
视频 RTP 时钟通常使用 90 kHz。同一采样时刻的图像片不应因为编码完成时间不同而随意改时间戳。H.264/HEVC 的 marker 与 AU 结束相关,不能把每个 slice 的结束都标成完整帧结束。
9.2 MTU、聚合与 pacing
路径 MTU 限制的是实际 IP 包大小。计算媒体载荷时必须扣除 IP、UDP、RTP、扩展头和可能的隧道、安全开销。1200 字节可作为某些环境的保守起点,但不是所有网络的固定最优值,应通过路径与协议确认。
过度聚合会等待更多 NAL;完全不节制的突发发送又会让交换机或无线队列瞬间增长。pacing 是把发送分布到一个受控时间窗口内。窗口过大直接增加等待,过小则失去削峰作用。应在片级及时发送的基础上,对最坏突发和截止时间做预算。
9.3 jitter buffer 的窗口应来自测量
抖动缓冲让稍晚或乱序的包有机会按顺序恢复。窗口小,延迟低,但容易把迟到当成丢失;窗口大,更能吸收变化,但内容会变旧。例如把重排窗口设为 7 ms,只表示愿意为特定到达变化保留相应等待,并不表示整个网络或接收路径只有 7 ms 延迟。
GStreamer rtpjitterbuffer 的 latency 以毫秒表示;丢失通知、重传请求及丢弃行为有各自参数,应按版本检查。设为 0 不代表链路没有延迟,也不代表丢包下仍能稳定解码。
接收重排可看一个简化例子:Seq 500 在 0 ms 到达,Seq 502 在 2 ms 到达,Seq 501 在 4 ms 到达。502 提前到达后暂存,501 补齐后即可按顺序继续。若用于此段数据的恢复截止在 6 ms,8 ms 才到达的缺失包已经不能按原计划使用。
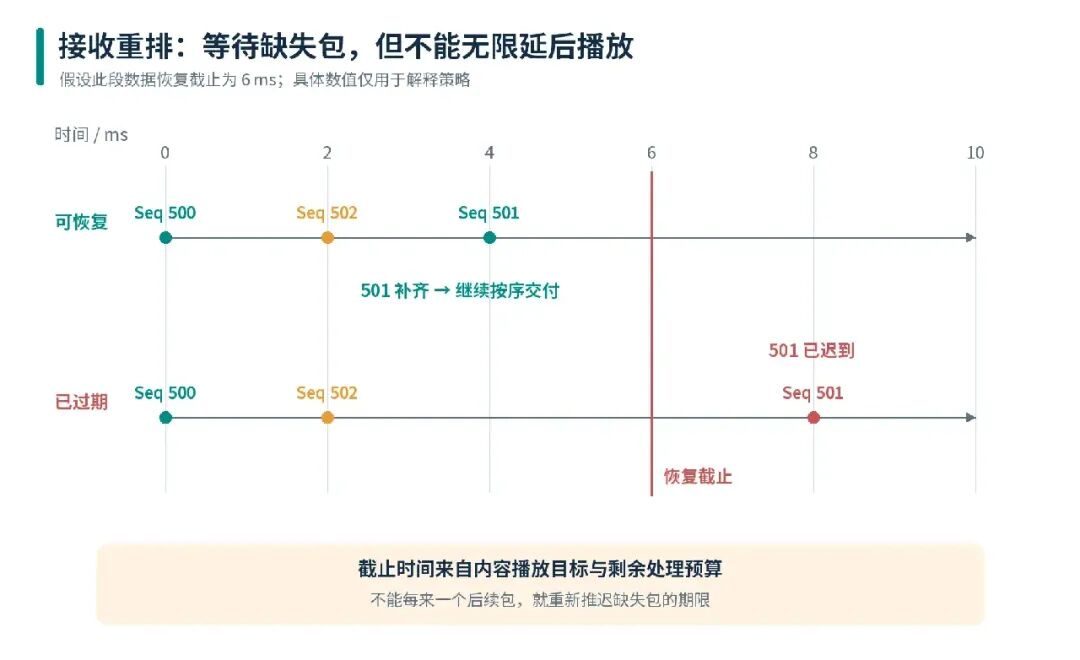
图9 这是接收策略的概念图。实际截止时刻由媒体时间映射、目标延迟和剩余解码/显示预算决定,不是机械地为每个包重新计时。
若每次收到后续包都把截止时间重新向后推,流可能永远在等前面的缺失数据。实时系统需要固定或有界调整的内容期限,迟到数据如何处理也必须与解码参考链配合。
9.4 重传和 FEC 都有时间成本
重传应满足:检测时间 + 反馈时间 + 重发传输时间 + 解码余量 < 距离播放截止的剩余时间。已经过期的数据即使最终可靠送达,也可能只增加陈旧内容的积压。
FEC 用冗余换取部分丢失恢复能力,既消耗带宽,也可能等待保护组数据到齐。短保护组等待小但效率受限;长保护组可能增加恢复等待。需要测量目标丢包模型,而不只是打开一个开关。
9.5 协议选择的架构取舍
| 方案 |
适合关注的能力 |
低延迟设计中的代价 |
| RTP/UDP |
时间戳、媒体分片、可控播放期限 |
需实现反馈、恢复与拥塞控制 |
| TCP 可靠字节流 |
顺序可靠交付 |
同一连接丢失后的后续字节交付受阻 |
| WebRTC 类实时栈 |
协商、穿透、拥塞、实时反馈 |
需核查内部缓冲和硬件片级接口 |
| 可靠重传型媒体传输 |
抗丢包和网络适应 |
恢复窗口需计入端到端预算 |
| QUIC Datagram |
在 QUIC 连接中传送不可靠报文 |
仍需媒体时间、反馈及播放策略 |
QUIC 可靠流与 QUIC Datagram 的语义不同。Datagram 扩展允许不可靠报文传送,但并不自动实现 RTP 的时间体系和抖动缓冲,也不会绕过拥塞约束。协议名称本身不能承诺某个端到端毫秒数。
9.6 Socket、网卡和封装同样会积压
send() 或 sendto() 成功,通常只能说明数据已被本机相应路径接受,不能直接当作已经出现在网线上。发送缓冲、qdisc、驱动队列、DMA 描述符和网卡都可能继续持有数据。接收端也可能因中断合并、调度延迟或读取不及时产生积压。
需要同时记录应用发送时刻与可获得的内核或硬件时间戳。缓冲容量应足以吸收允许的短时突发,但不能成为长时间存放陈旧码流的地方。若发送期限已经超出,应按媒体依赖执行丢弃或降载,不能靠持续增大缓冲掩盖问题。
RTSP 主要负责会话控制,实际媒体可以走 RTP/UDP,也可以嵌入可靠传输连接。讨论延迟时应说明具体媒体承载方式。若额外加入复用器和容器,例如将音视频复用为传输流,还要检查复用对齐、时间戳、输出刷新和解复用等待,防止片级码流重新被聚合。
10 解码到显示:保证扫描永远不追上写入
10.1 解码需要输入、参考和输出空间
解码器需要解析语法、熵解码、预测、反量化、反变换和重建等步骤,并保存必要的参考图像。硬件常把这些工作拆成多个阶段,因此既可能流水并行,也可能因为码流输入不足、参考未就绪或输出 buffer 不足而暂停。
无 B 帧消除的是相关重排序等待,不会消除 P 帧参考需求。把 DPB、熵缓冲或输出池全部减到最小,可能使硬件饥饿并增加延迟尖峰。
在实现上可以把解码输入分成四个检查点:是否具有有效参数集,相关 NAL 是否完整,参考图像是否可用,是否已经准备好重建与显示缓冲。任何一项缺失,计算单元即使空闲也无法正确推进。
参数集描述图像尺寸、编码工具和相关约束。连接中途加入、编码器重启或分辨率切换后,接收端可能需要重新获取参数集并重建缓冲配置。只发送新的 slice 而缺少必要上下文,并不能保证首帧正常出现。
解码流水内部还会在熵处理、运动补偿和像素重建之间传递任务。熵处理提前完成并不表示像素已经生成;像素写回开始也不表示所有后处理已完成。逐级事件必须按真实语义命名。
10.2 提前输出不等于解码完成
VCU 子帧路径中的定制 OMX 解码器通过 early FillBufferDone 提前交付输出 buffer。解码器继续写,显示控制器稍后开始从同一 buffer 扫描。此处没有与采集侧相同的硬件 Sync IP。
显示端根据 Vblank 时间预测并安排提交,为解码进度保留约半帧周期的领先量。60 Hz 的半帧约为 8.33 ms,但这不是任何负载下都成立的解码保证,也不等价于机械地等待“恰好一半像素完成”。
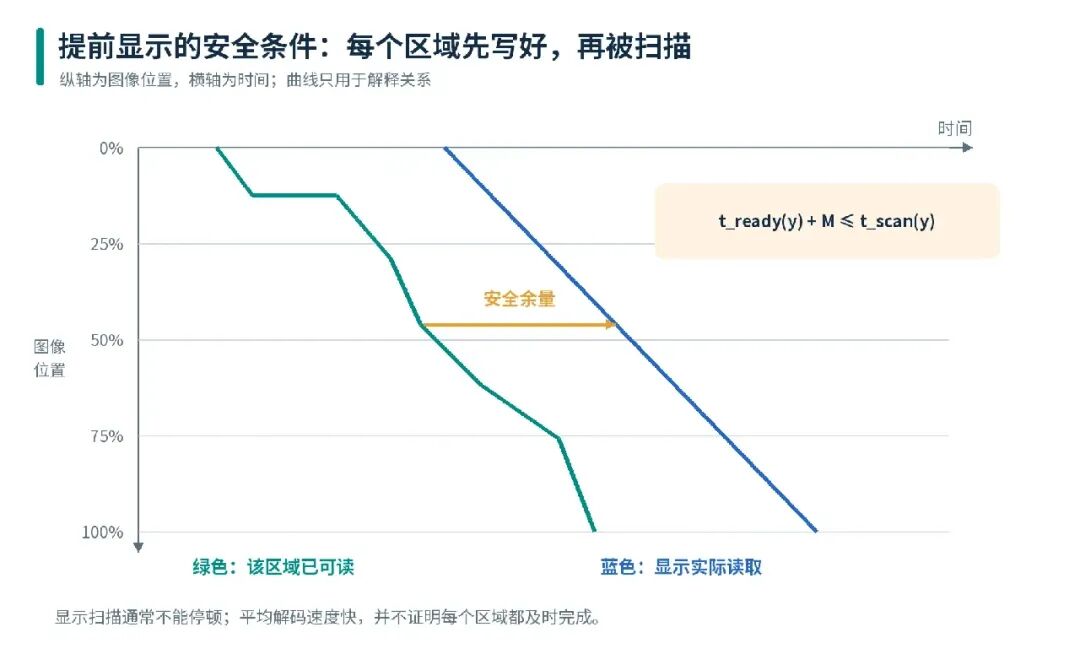
图10 示意曲线表示每个区域完成写入与被显示读取的时间。扫描线不能越过可读边界;安全余量需要覆盖网络、解码和内存服务变化。
10.3 正确性条件比平均速度更重要
对图像区域 y,应满足 t_ready(y) + M(y) ≤ t_scan(y)。t_ready 是包括重建及必要滤波依赖后的可读时刻,M 是安全余量,t_scan 是显示实际读到该区域的时刻。
编码器被阻塞后可以等待,显示控制器通常要按固定像素时钟连续输出。它不能在画面中间随意停下来等解码。因而最坏情况余量、欠载检测和失败策略是提前显示方案的一部分。
网络严重抖动、复杂画面或者 DDR 争用打破领先量时,应采取可验证策略,例如不提交该帧、保留上一完整画面、等待恢复点或切换到更保守的帧级显示。具体策略取决于显示硬件对正在扫描 buffer 的行为,不能在扫描过程中随意替换引用。
10.4 Vblank、扫描和面板处理还会增加时间
显示提交、Vblank 到达、DMA 扫描、面板发光是不同事件。普通双缓冲 page flip 通常在适合的刷新边界切换,并不保证逐 slice 呈现。桌面合成器、电视画质处理、插帧和面板响应也会增加延迟。
关闭 sync 只是改变软件播放调度,不能消除刷新周期,还可能破坏音画关系。最低延迟路径通常需要直接显示 plane、受控刷新时序及低处理延迟的显示设备。
11 音频链路:小块处理与稳定播放水位
11.1 先统一各层的块长
音频块时长 T_block = N / Fs。48 kHz 下,120、240、480、960 个每声道采样点分别对应 2.5、5、10、20 ms。采集每 5 ms 唤醒一次,并不意味着 3A 或编码器每 5 ms 就会输出;如果后级需要 20 ms,就仍会发生拼块等待。
| 层级 |
需要检查的时间参数 |
典型问题 |
| ADC / DAC |
数字滤波与转换群延迟 |
软件测量遗漏模拟端 |
| ALSA DMA |
period、buffer、启播阈值 |
播放水位过高或频繁 XRUN |
| AEC / NS / AGC |
处理块、分析窗、前瞻 |
各算法重复缓冲 |
| 编码与打包 |
编码帧长、每包帧数 |
小帧又被合成长包 |
| 接收与播放 |
jitter、解码、硬件待播采样 |
为稳音频而无限增加队列 |
ALSA 的 period 与整个环形 buffer 是不同概念,启播阈值和读写行为也会影响实际水位。分配了 20 ms 容量,不意味着每个采样必然等待 20 ms;需要看当时实际排队了多少采样。
音频 API 中的一个 frame 通常表示同一采样时刻所有声道的一组采样。48 kHz 双声道的 240 个 frame 仍然对应 5 ms,而不是 10 ms;每个 frame 的字节数才会随声道数和位宽增加。
例如 5 ms 采集 period 对接 10 ms 算法块,需要合并两次采集。第一块中的较早采样会等待下一块到齐,然后才能参加整块处理。如果编码器再按 20 ms 聚合,等待会继续增加。应让各层块长尽量兼容,并明确哪个层真正要求更长的分析窗。
中断更频繁并不总是更好:period 过小会增加调度开销,系统稍有抖动就可能 XRUN。合理目标是在最坏负载下维持小而稳定的水位,而不是追求最低配置数值。
11.2 PCM 适合建立基础延迟基线
48 kHz、16 bit、双声道 PCM 的裸码率为 1.536 Mbit/s。按 5 ms 打包,每包有效数据为 960 字节,再加传输头部。它避免压缩编码的帧积累与算法前瞻,适合在容量充足的受控网络中测量基础路径。
需要压缩时可评估 Opus 等实时音频编码。Opus 的帧长包含 2.5、5、10、20 ms 等选择,其中很短帧使用 CELT 模式;总算法延迟还取决于模式及前瞻,不能用帧长直接代替。
11.3 AEC 的参考信号必须与真实播放对齐
回声消除需要知道扬声器实际播放了什么,以及它经过声学路径到达麦克风的时间。若只记录向声卡提交的时刻,而播放队列还在变化,参考对齐就会偏移。
应跟踪硬件播放位置、待播放采样和时间戳,并为重采样建立连续的时间映射。一次突发造成播放水位增长,不仅增加音频延迟,也可能让 AEC 短时失配。
12 音画同步:在共同时间轴上确定播放期限
12.1 两路独立“到达即播放”会产生偏差
假设视频路径为 42 ms、音频路径为 16 ms。直接分别输出会使音频早约 26 ms。音画同步需要把内容的采集时间映射到同一接收时间域,并使用共同的目标播放规则。
可表示为 t_play = Map(t_capture) + L_target。其中 Map 描述时钟偏移和频率差,L_target 是能覆盖两条路径预算的目标延迟。较快的音频可以保留必要等待,但不能用无限增加音频等待去掩盖视频持续积压。
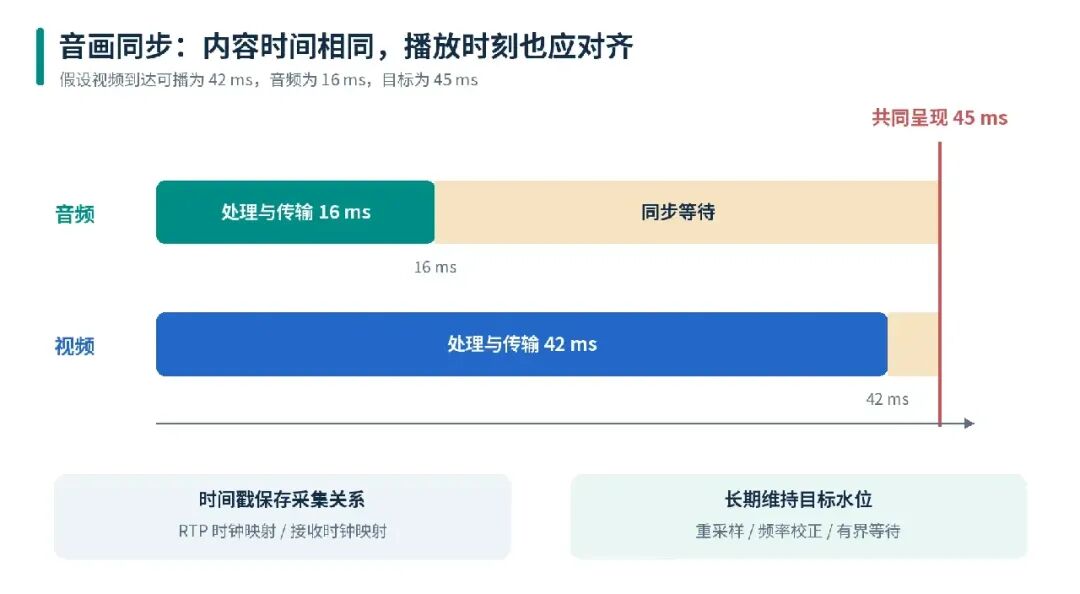
图11 图中 16、42、45 ms 为解释同步的假设值,不是 VCU 测量结果。等待应有明确上限。
12.2 RTP 时间戳与时钟同步的边界
音视频 RTP 时间戳使用不同频率和起点,不能直接比较整数。RTCP Sender Report 关联 RTP 时间戳与参考时间,可结合流归属信息建立音画关系。
这并不自动等价于两台机器的单调时钟已经精确同步。测量跨设备单向延迟时,还需要校准偏移或使用适合网络的时间同步方案。受控网络可评估硬件时间戳及 PTP;跨普通网络需要考虑偏移估计误差与路径不对称。
12.3 长时间运行必须补偿漂移
若两端采样频率相差 50 ppm,一分钟可累计约 3 ms 时间差。没有频率校正,播放缓冲会逐渐变空或变满。
音频常用缓慢调整重采样比率来维持目标水位;视频可结合显示时钟进行有控制的重复、丢帧或频率适配。应避免频繁大幅修正导致音调变化、卡顿或时间戳不连续。修正时也要保持 AEC 参考路径的一致时间关系。
13 软件细节:不能让队列吃掉硬件收益
13.1 分配数量与排队数量不同
Buffer pool 是可供在途任务使用的资源,queue 是已进入某阶段但尚未被处理的数据。足够的池可以避免硬件等待空 buffer,而队列中的陈旧内容会增加延迟。
多路 HEVC 场景中,适度增加输出 buffer 有时反而可以缓解硬件等待空 buffer 的问题。因此“所有 buffer 都越少越好”并不成立。需要记录已分配、被硬件持有、待处理和可回收的数量。
13.2 GStreamer queue 的 0 不是零延迟
queue 提供线程解耦,并按 buffer 数、字节数或时间设上限。某个 max-size-* 设为 0 表示取消该维度限制,不是取消队列。默认上限只表示容量,不代表必然等满后才输出;实际积压应读取 current-level-*。
例如以下配置仅展示原始完整帧队列的容量限制:
queue max-size-buffers=2 max-size-bytes=0 max-size-time=0
达到上限时如何处理,需要按路径决定。对可安全丢弃的旧原始帧,可评估丢旧帧策略;对部分填充的共享 buffer、仍被硬件持有的 buffer 或压缩参考链,不能简单套用任意丢弃。
13.3 丢弃压缩码流需要理解参考依赖
随意丢掉一个 P 帧可能使后续图像缺少参考。随意丢掉一个 NAL 或 slice 可能造成当前图像不完整,并把误差传播到后面。要结合帧边界、可丢层、参考标记和恢复点处理。
系统过载时,编码前选择性丢弃陈旧原始帧通常更容易维持码流完整性,但要确保编码器允许相应时序变化并保持时间戳正确。发生解码错误时,需结合错误隐藏和 IDR/GDR 恢复策略。
13.4 调度与资源竞争影响的是尾部
线程唤醒、中断合并、网卡批处理、CPU 频率变化、热降频、DDR 争用和多路创建销毁都可能造成尖峰。VCU 共享调度器在处理多路命令和通道创建、销毁时,也可能让已运行的流等待更久。
优化应先定位:是 CPU 没及时唤醒,还是硬件在等待内存,还是网络队列未排空。实时优先级、绑核或中断亲和性需要针对实际竞争设计,避免把网络接收和音频处理挤到同一个繁忙核上。
14 参数如何组成可验证的方案
14.1 Xilinx 子帧路径的关键契约
下面是用于阅读架构的配置骨架,不是经过特定板卡验证的可执行脚本。省略了设备节点、完整 caps、显示 plane、网络与音频分支。各属性是否存在以及单位,应以配套版本 gst-inspect-1.0 和实际控制接口为准。
capture:
  DMA-BUF import/export
  video/x-raw(memory:XLNXLL)
  Sync IP + early dequeue

encoder:
  gop-mode=low-delay-p
  b-frames=0
  num-slices=8
  control-rate=low-latency
  filler-data=0
  prefetch-buffer=true
  gdr-mode=horizontal    # verify recovery requirements

bitstream boundary:
  video/x-h265, alignment=nal
  RTP packetization without whole-frame accumulation

decoder:
  low-latency=1
  video/x-raw(memory:XLNXLL)

display:
  early output + validated Vblank scheduling
  bounded lateness + safe buffer lifetime
memory:XLNXLL 是这一软件栈的定制协商特征,不是给任意 DMA-BUF 改个名称就能获得的硬件能力。传输为 H.264 时也应使用对应的码流类型和 RTP 格式。
14.2 一组参数背后的实际作用
| 参数或机制 |
作用 |
常见误区 |
| low-delay-p、无 B 帧 |
避免未来参考相关等待 |
认为无需 DPB |
| num-slices |
改变片级输出粒度 |
越大越好 |
| alignment=nal |
保持 NAL 交接边界 |
认为所有组件自动提前解码 |
| low-latency 解码模式 |
使用相应低延迟处理路径 |
单独打开就实现整机子帧流水 |
| cpb-size、initial-delay |
编码缓冲模型约束 |
当作网络抖动等待 |
| rtpjitterbuffer latency |
控制网络重排等待窗口 |
设 0 就稳定且最低延迟 |
| max-lateness |
决定迟到后的处理边界 |
直接等于目标端到端延迟 |
| processing-deadline |
给调度保留处理预算 |
是硬件运算耗时开关 |
| target-bitrate |
目标编码速率 |
限定每一帧都一样大 |
GStreamer 需要基于组件上报延迟和播放时钟进行调度;上报延迟与实际瞬时处理耗时是不同概念。修改延迟相关属性后,应重新验证实际呈现时间及丢帧情况。
配置后可先检查实际插件能力和协商结果,而不是仅看命令是否启动成功:
gst-inspect-1.0 omxh265enc
gst-inspect-1.0 omxh265dec
gst-inspect-1.0 rtpjitterbuffer
gst-inspect-1.0 kmssink
编码插件能够接受属性,并不证明整个硬件工程已接入同步 IP。还要确认采集输出使用了预期共享内存路径,没有插入隐式复制或格式转换;确认码流边界为期望的 NAL 粒度,显示组件确实支持该定制提前交付协议。
14.3 分三个阶段推进集成
第一阶段建立完整帧、无 B 帧、低队列、零拷贝基线,确认画面正确且不持续积压。第二阶段开启 slice 输出和片级传输,分别测首片和末片时间。第三阶段再启用采集提前交付与显示提前扫描,验证硬件同步、余量和异常恢复。
音频先使用 PCM 和固定小块建立延迟基线,再按需求加入 3A、压缩和漂移补偿。每次只改变可解释的一组机制,保留性能与画质对比。
15 延迟预算:模块上报与整机目标分开表达
15.1 模块上报数值说明了什么
下表是一组针对 VCU 4K60 路径的模块估计与上报数值,用于比较帧级与子帧模式的等待差异。它不包含某个完整摄像头、网络和面板组合的实测结果。
| 模式 |
采集 |
HEVC / AVC 编码 |
解码 |
显示 |
| Normal |
16.6 ms |
18 / 35 ms |
200 ms |
16.6 ms |
| Reduced |
16.6 ms |
18 / 35 ms |
50 ms |
16.6 ms |
| Low Latency |
16.6 ms |
4 / 10 ms |
17 ms |
16.6 ms |
| Xilinx Low Latency |
1 ms |
4 / 10 ms |
9 ms |
16.6 ms |
这些数值用于理解模式差异。它们不是任意 Sensor、网络和面板组合的光学测量结果,也不是 H.264/HEVC 算法普遍下限。更不能将不同分辨率、多路数量的独立编码与解码统计拼成同一次整机测试。
15.2 一份示例预算怎样写
下表是用于讨论的工程目标,假设 1080p60、受控有线网络和可用的子帧路径。每行表示沿同一可追踪内容路径分配的增量,不重复计入已与前级重叠的整帧处理时间。它没有经过板级测量。
| 预算项 |
示例额度 |
验证方法 |
| 光学采集至所需数据可用 |
10 ms |
Sensor 时序与光学实验 |
| 编码增量 |
4 ms |
对应区域到片输出 |
| 打包与发送 |
2 ms |
应用记录与硬件发送时间 |
| 网络路径 |
2 ms |
校准后的单向测量 |
| 接收重排与恢复窗口 |
4 ms |
包到达分布及截止统计 |
| 解码增量 |
5 ms |
相关输入到区域可读 |
| 呈现与面板增量 |
12 ms |
Vblank、扫描与光电测量 |
| 未建模变化余量 |
6 ms |
最坏负载实验 |
| 合计目标 |
45 ms |
同一事件的完整测量 |
预算不满足时,需要说明缺口在哪里。例如屏幕内部额外缓存两帧,就不能靠减少编码器几百微秒补偿。多级流水的 P99 也不能简单由每个环节 P99 相加得出,应直接测量端到端分布和相关尖峰。
15.3 如何给子帧路径建立可追踪的预算
假设目标是屏幕中部对应区域的变化,而不是首个像素。首先确定该区域在 Sensor 的曝光与读出时刻,再追踪覆盖此区域的编码片,记录它何时完整输出、何时到达、何时重建以及何时被扫描。这样同一个区域才贯穿整条路径。
如果采集、编码和传输已经重叠,不能再次把“采集完整帧时间”与“全部编码耗时”完整叠加。反过来,如果只测第一片,却给出完整画面端到端结论,又会低估延迟。各阶段定义一致比公式外观更重要。
音画同步预算取决于两条路径及其变化。较快音频等待较慢视频是有意同步;解码线程因为资源不足而堆积,则是非预期等待。两者应分别记录,否则优化时可能误删必要同步,却保留真正积压。
16 测量、定位与异常恢复
16.1 把内容身份贯穿整条路径
记录 frame_id、slice_id、buffer_id、媒体时间戳和事件时间。帧身份不能只依赖循环使用的 buffer 索引,必要时增加 generation 或连续帧号。日志开销应可控,避免密集打印本身改变实时行为。
关键时间点包括:采集基准事件、区域可用、编码提交、首片输出、末片输出、网络发送、网络接收、解码开始、区域可读、整帧完成、显示提交、Vblank、对应像素发光。音频则增加 ADC 采样位置、算法块边界和实际 DAC 播放位置。
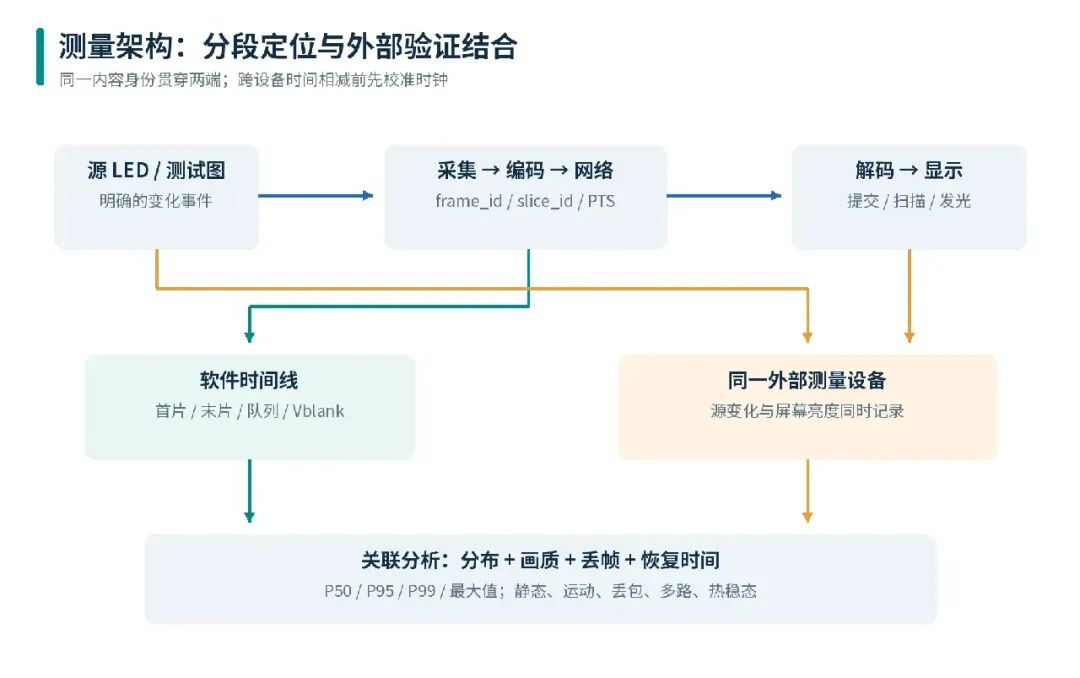
图12 软件事件用于定位等待,外部测量验证最终输出。两种测量相互校验,不能互相替代。
16.2 分层定位方法
| 现象 |
优先检查 |
验证动作 |
| 延迟不断增长 |
吞吐不足、网络积压、时钟漂移 |
同时记录队列水位和输入输出速率 |
| 固定多出一帧 |
帧级交接、parser 聚合、Vblank |
比较首片、帧尾及显示提交 |
| 复杂画面时突然变慢 |
帧大小突发、编码或解码峰值 |
对齐帧大小与延迟时间线 |
| 多路启停时尖峰 |
共享调度、内存争用 |
单路与多路受控对比 |
| 上半部正常、下半部花屏 |
扫描追上解码、同步范围错误 |
检查区域可读时间与 DMA 读地址 |
| 运行越久音画越偏 |
时钟频率差、时间戳跳变 |
长期记录偏差与重采样比率 |
| 丢包后持续花屏 |
参考链损坏、恢复点缺失 |
验证 IDR/GDR 与参数集恢复 |
16.3 外部测量验证的是实际体验边界
视频可让摄像头拍摄受控 LED 变化,并用同一采集设备记录源 LED 与屏幕对应区域亮度。分别测试顶部、中部、底部,并说明曝光设置和检测阈值。高速摄影也可作为辅助,但相机自身快门与帧率会影响测量分辨率。
音频可使用脉冲、扫频或已知序列,通过相关性估计输入到输出延迟。若走声学路径,应扣除或报告声传播距离;若走电气回环,应说明没有包含扬声器、麦克风和空气传播。
16.4 压力测试不能只看静态画面
覆盖运动、细纹理、噪声、场景切换、网络突发丢包、乱序、带宽下降、后台 DDR 流量、热稳定状态、多路启停和长时间运行。记录最大值,以及丢帧、错误恢复时间、音频 XRUN 和音画偏差。
特别要测试恢复路径:参数集丢失、编码器重启、分辨率变化、时间戳跳变、网络断开重连和 buffer 回收。正常路径正确,并不证明异常情况下提前共享内存仍安全。
17 从单板验证到双端联调
17.1 第一步:建立可解释的帧级基线
固定输入分辨率、帧率、格式和显示模式,先在完整帧路径验证采集、编码、解码和显示。关闭未来帧依赖,限制非必要排队,记录输入输出帧号和时间戳。基线必须无持续积压,并能稳定回收缓冲区。
此时即使延迟尚未达到目标,也应能解释每个帧周期花在哪里。若基本链路已有偶发花屏、时间戳倒退或 buffer 生命周期错误,提前交付只会让问题更难定位。
17.2 第二步:证明片级输出真实存在
先用本地接收端消费编码码流,检查同一 frame_id 是否产生多个独立片级事件。分别记录第一片和最后一片:第一片提前,但最后一片仍在合理时间内完成,才说明交接粒度发生了变化。
接入网络后,逐段观察编码器输出、RTP 打包、网卡发送、接收重组、parser 和解码提交。任何组件重新等齐整帧,都会在时间线上出现明显的“前面已产生数据,后面却迟迟没有动作”。
17.3 第三步:启用并发读写与提前显示
采集侧先验证地址范围、亮度色度进度、同步异常和停止路径,再开启 early dequeue。显示侧先验证区域可读进度和刷新时间关系,再减少解码与扫描之间的余量。两个方向分别测试,避免同时改变后难以定位。
在最坏画面、带宽压力和多路负载下重复测量。若安全余量只在静态图像下成立,就不应将其作为稳定配置。时序验证通过后,再把音频采集、算法、播放和时钟校正接入共同时间轴。
17.4 迁移到其他 SoC 先检查能力矩阵
| 能力 |
需要确认的问题 |
缺失时保留的代价 |
| 输入子帧支持 |
编码器能否安全读取部分已完成区域 |
等完整输入帧 |
| 编码片级输出 |
硬件与驱动是否暴露片完成回调 |
等完整编码图像 |
| 片级码流传输 |
打包与接收组件能否立即交付完整 NAL |
软件重新聚合整帧 |
| 解码增量消费 |
解码器能否在整帧码流到齐前运行 |
等完整 AU |
| 输出提前可用 |
能否表达区域可读与真实完成 |
等完整重建帧 |
| 显示安全扫描 |
扫描与重建是否有可靠进度关系 |
采用完整帧显示 |
不同平台即使都有“低延迟”参数,含义也可能不同。选型应以能力矩阵和测量证据为依据。缺少某一项时,应保留对应的帧级边界,并在预算中如实计入,而不是用不安全的提前完成通知绕过约束。
18 实施检查表
| 层级 |
必须得到的证据 |
| 采集 |
明确的时间戳语义、曝光/读出时序、ISP 依赖 |
| 内存 |
正确的格式布局、DMA 映射、同步及回收记录 |
| 编码 |
无未来帧等待、首末片时间、帧大小与画质分布 |
| 传输 |
MTU 验证、发送积压、乱序窗口、截止恢复策略 |
| 解码 |
实际片级消费、参考管理、错误恢复和输出水位 |
| 显示 |
区域可读领先扫描、Vblank 事件及面板外测 |
| 音频 |
块长衔接、前瞻、播放水位和 AEC 对齐 |
| 同步 |
音画共同时间轴、偏移误差和长期漂移控制 |
| 验收 |
明确场景下的端到端分布、画质、丢帧和恢复时间 |
每一项优化都应回答两个问题:它消除了哪一段等待,以及新的提前处理依靠什么保证正确。只有这两个答案都能被测量验证,局部低延迟能力才能组成稳定的端到端方案。
 发表于 4 天前
|
查看: 0|
回复: 0


