上下文学习到底解决了什么
你有一个机器人,会抓杯子、开门、叠衣服。可今天你想让它做一件没教过的事:把桌面上的红色积木放到蓝色盒子左边,再把绿色积木叠到红色积木上面。它需要什么?
传统做法很直接:采集几百次演示数据,训练一个新任务模型。每换一个任务,就再来一遍。现实世界的数据采集,费时又费力。
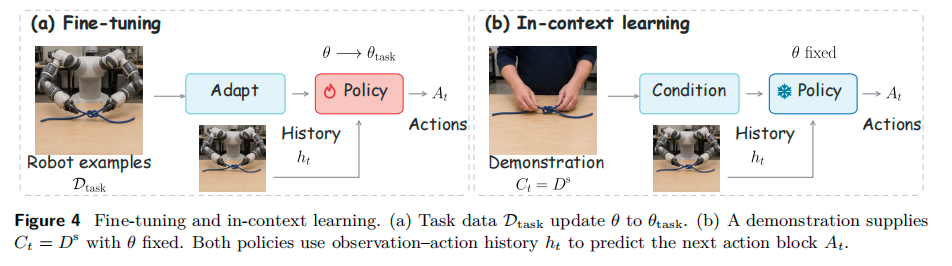
上下文学习(ICL)给出的是另一条路:不更新任何模型权重,直接把演示视频或者文字指令塞进模型的“上下文”,让它在推理时实时理解你要什么。
这个概念在语言模型里已经被验证过了。GPT-3 之后,不用微调就能让模型做新任务,只需要在提示词里给几个例子。但在机器人领域,这件事一直很难。语言模型的上下文是文本,机器人的上下文是视频、动作序列、力反馈、关节状态,维度高得多,物理约束也硬得多。
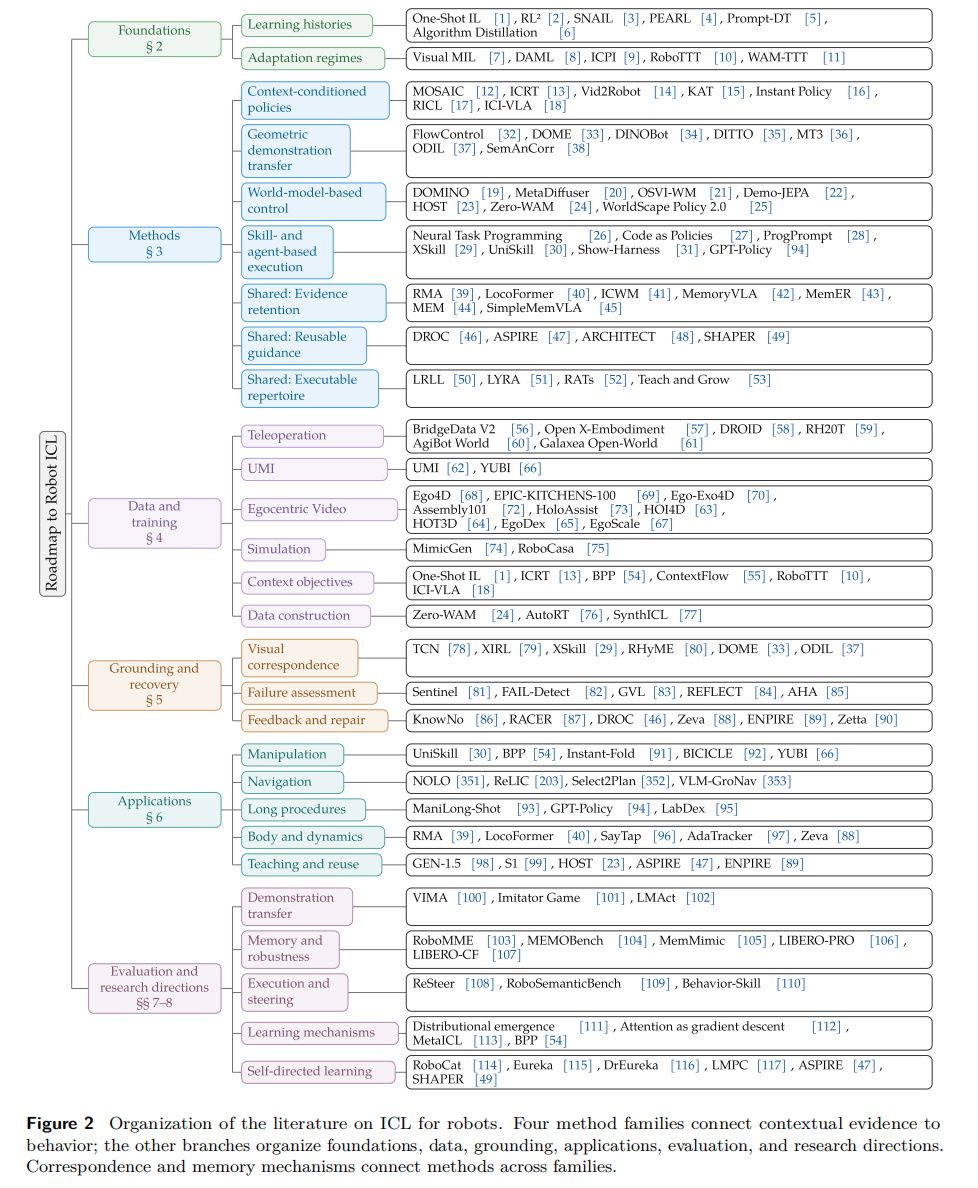
这篇综述的核心贡献,就是把机器人上下文学习的全部文献,按照“上下文怎么变成动作”这条线,整理成了四个接口。每个接口代表一种不同的计算路径,各自有各自的假设、优势和局限。
关键概念:四个接口,四种让上下文变成动作的方式
综述把机器人 ICL 分成了四类,分类依据是执行层消耗的中间表示是什么。
第一类:上下文条件策略(Context-conditioned Policies)。 策略直接吃上下文,吐动作。中间表示是“动作分布”或者“检索到的动作块”。比如 ICRT(In-Context Robot Transformer),把多条演示轨迹拼成上下文,用 next-token prediction 直接生成动作。关键实验发现:训练数据中“同一初始观测下可以有多种不同任务”的场景,对上下文学习能力的养成特别关键。因为如果每个场景只有一个合理动作,模型学会的是“看到场景就做固定动作”,而不是“看到演示就调整动作”。
第二类:几何演示转移(Geometric Demonstration Transfer)。 上下文被转换成运动参考或接触参考,对齐后由追踪器执行。中间表示是“几何关系”。典型代表是 R-NDF(Relational Neural Descriptor Fields),把“把碗放在杯子上”这个关系,迁移到全新的物体对上。
第三类:基于世界模型的控制(World-model-based Control)。 上下文用来预测未来,动作由预测结果解码。中间表示是“预测的未来”。
第四类:技能与智能体执行(Skill- and Agent-based Execution)。 上下文被解析成技能选择、程序或工具调用。中间表示是“执行规范”。
三个关键实验:数据不会说谎
综述引用了大量实验数据。挑三个最有代表性的讲。
S1:一段视频,66% 对 9%
Skild AI 的 S1 是 2026 年最受关注的机器人基础模型之一。它在 10 万小时预训练数据下,面对完全未见过的多步任务,用一段演示视频做上下文,单步成功率做到了 66%。对照组是基于语言提示的 VLA 模型,同样数据、同样算力、同样架构,只换了提示嵌入方式,成功率只有 9%。
7 倍以上的差距。
更关键的是,这 66% 不需要任何后训练微调。把视频塞进去,机器人就执行。Skild AI 自己的评论是:“如果机器人基础模型学一个新任务仍然需要几十小时真机数据,那这个‘基础模型’,基础在哪儿?”
BPP:任务多样性比演示数量更重要
Behavior Prompting Policy(BPP)研究了一个更精细的问题:在固定演示数量下,任务多样性如何影响上下文学习的泛化能力。
在 10,000 条绘图演示的固定预算下,三种数据分配方式的 Chamfer 误差(越低越好):
- 500 个任务 × 20 次演示:9.5 像素
- 1,000 个任务 × 10 次演示:5.1 像素
- 2,000 个任务 × 5 次演示:3.4 像素
任务数量翻 4 倍,每个任务的演示次数降到四分之一,误差反而降低了三分之二。结论很明确:上下文学习的泛化能力,更多取决于训练数据里有多少“需要模型根据演示来区分的决策场景”,而不是每个任务给了多少条演示。
但 BPP 也暴露了局限。在低任务多样性场景(比如只有三种叠衣服任务)下,语言条件比演示条件更可靠。有些演示条件下的失败案例,模型执行了错误的折叠方式。
RAPID:验证环节让成功率从 53% 跳到 76%
RAPID 用人类演示构建可执行程序,然后在一个模拟环境中验证程序是否能在场景变化下依然有效。消融实验对比了“关闭验证”和“开启验证”:
- 关闭场景变体验证:53.2% 成功率
- 开启场景变体验证:75.98% 成功率
22 个百分点的差距。验证机制会生成模拟场景变体,在部署前测试程序是否在物体位置偏移、视角变化等条件下仍然可行。这条数据说明:在机器人上下文学习里,“检查一下”这件事本身就是能力的一部分。
评估困境:这个领域的基准正在失效
综述用专门一章讨论了评估问题,指出了一堆让人头疼的现状。
问题一:LIBERO 基准可以被“作弊”。 LIBERO 是机器人操作领域最常用的基准之一。但研究者发现,仅靠任务索引嵌入(task index embedding),就能在 LIBERO 上拿到高分。原因是每个任务的初始场景足够独特,模型只需要识别“这是哪个任务”就能做对,根本不需要理解指令。
后续的 LIBERO-CF 专门设计了“同一场景下多种可行指令”的测试,结果发现多数 VLA 模型在指令和场景关联被打破后,仍然执行场景默认的任务,而不是指令要求的任务。
问题二:成功率掩盖了太多信息。 一个任务“把红色积木放到蓝色盒子左边”,最终积木放对了位置,但过程中的抓取方式、路径选择、接触力是否合理?如果只看最终成功率,这些差异全部被隐藏了。
综述建议评估需要区分三个层次:对教学的响应(改变演示,行为是否相应改变)、物理转移(教的要求是否在物理执行中存活)、经验保留的收益(保留的修正是否帮助了后续尝试)。这三个层次需要不同的实验设计,不能用一个成功率数字概括。
六个学习层级:一张图看清机器人的进化路线
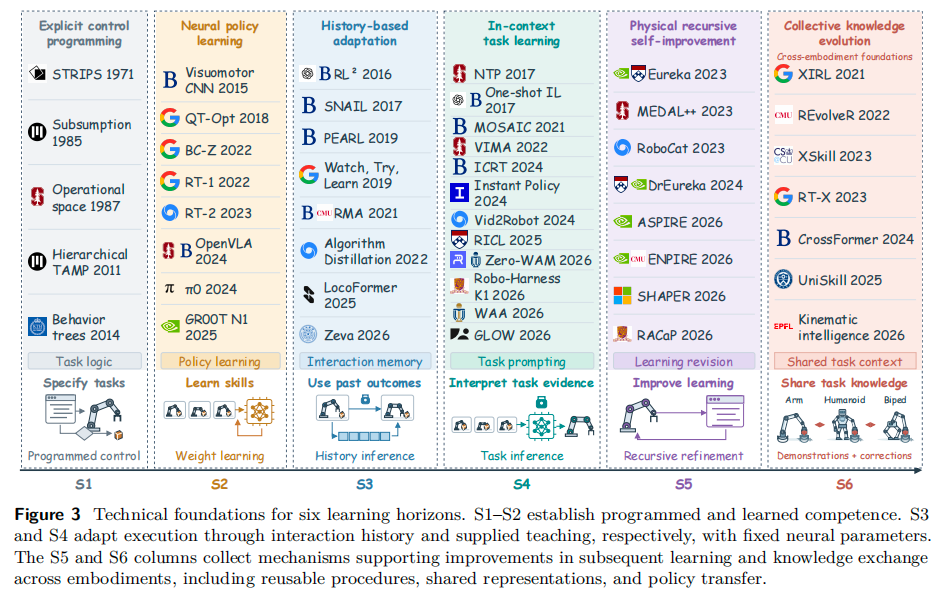
综述用六个层级来组织机器人的能力发展。
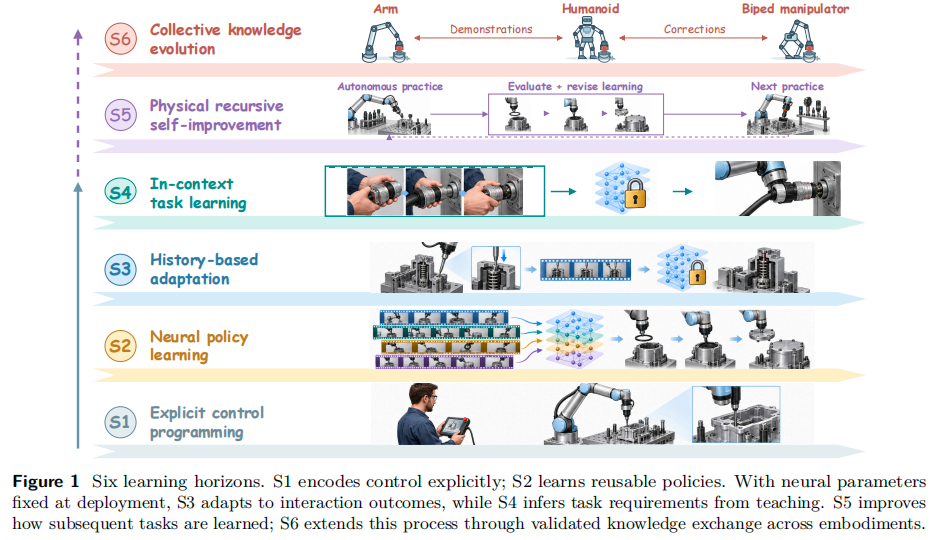
S1 是显式控制编程,STRIPS 规划器、行为树。S2 是神经策略学习,从演示和强化学习中获得可复用行为。S3 是基于历史的适应,用交互记忆推断任务或动力学信息。S4 是上下文任务学习,从提供的教学中推断新任务要求。S3 和 S4 的共同点是:部署时神经参数固定不变,靠上下文或记忆来改变行为。
S5 和 S6 是更远的目标。S5 是物理递归自我改进,经验改善后续任务的学习效率。S6 是集体知识进化,一个机器人的执行经验能被另一个身体使用,即使原始动作无法直接复制。
这篇综述的真正价值
2026 年机器人上下文学习领域的论文数量爆发式增长。综述统计了 412 篇参考文献,其中 297 篇是 2024 年之后首次发布的,197 篇集中在 2026 年。方法子集 260 篇中,上下文条件策略占了 123 篇,技能与智能体执行 91 篇,几何转移 24 篇,世界模型控制 22 篇。
论文多到一定程度,就需要有人把地图画出来。这篇综述做的事情是:不再按“技术路线”分类(VLA、扩散策略、世界模型),而是按“上下文到达动作的物理路径”分类。这个视角更接近工程实践,你不需要纠结用 Transformer 还是扩散模型,你需要想清楚的是:你的上下文最终要变成什么中间表示,才能被你的执行器消费?
动作分布、几何参考、预测未来、执行规范,四条路,四种假设,四种失败模式。综述不告诉你哪条路最好,它告诉你每条路的假设是什么,什么时候会断。
下一步
综述在最后给出了一个研究议程,核心问题只有一个:能不能让一个系统从上下文里学到的经验,不仅改善当前任务,还让它下一次学新任务时学得更快?
这就是物理递归自我改进(S5)和集体知识进化(S6)要回答的问题。前者问的是个体层面,干过一次之后,学第二次是不是更快?后者问的是群体层面,一个机器人学会的东西,能不能让另一个形态不同的机器人也受益?
综述没有给答案,但给出了测试框架。评估的核心指标不是单次成功率,而是教学成本、响应延迟和重复使用的收益。这类跨本体知识进化的问题,在 云栈社区 也常被讨论。
 发表于 1 小时前
|
查看: 2|
回复: 0


