BICDB 的进展完全出乎我的所料。原本我准备在国庆假期几天完成设计工作,不过因为国庆前三天一直忙于 BIC-QA 的一个产品升级,直到 3 号晚上才开始需求输入。4 号完成了存储引擎的总体设计,SQL 引擎我偷了个懒,直接裁剪 PostgreSQL 的 SQL 语法子集,省掉了设计工作,只设计了几个管理数据库、工作区、模板的 DCL 命令。
前几天也有朋友建议我用 SDD 来开发,实际上这个工作完全是 DeepSeek 自己干的,我只是负责做一些关键决策。分析需求、查找知识库、完成设计、完成代码,这些工作我只是简单参与。对于 BICDB 这样一个单人小项目,SDD 这类偏流程化的 AI 工作方式是否合适,我心里也没底。最后干脆抛弃流程,完全采用启发式引导,让 DeepSeek 自主完成整个项目。
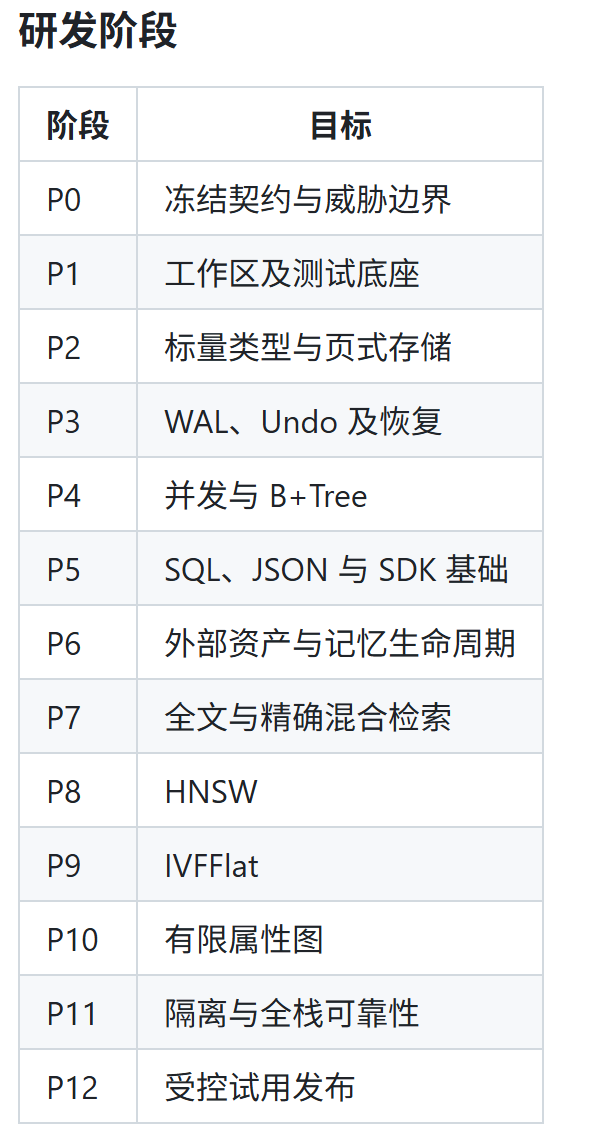
最新的项目进展可以参考 BICDB 项目 Wiki,目前我已经在 GitHub 上发布了 0.1.0 版本的设计文档和相关源代码,代码现在就可以下载、编译、执行。
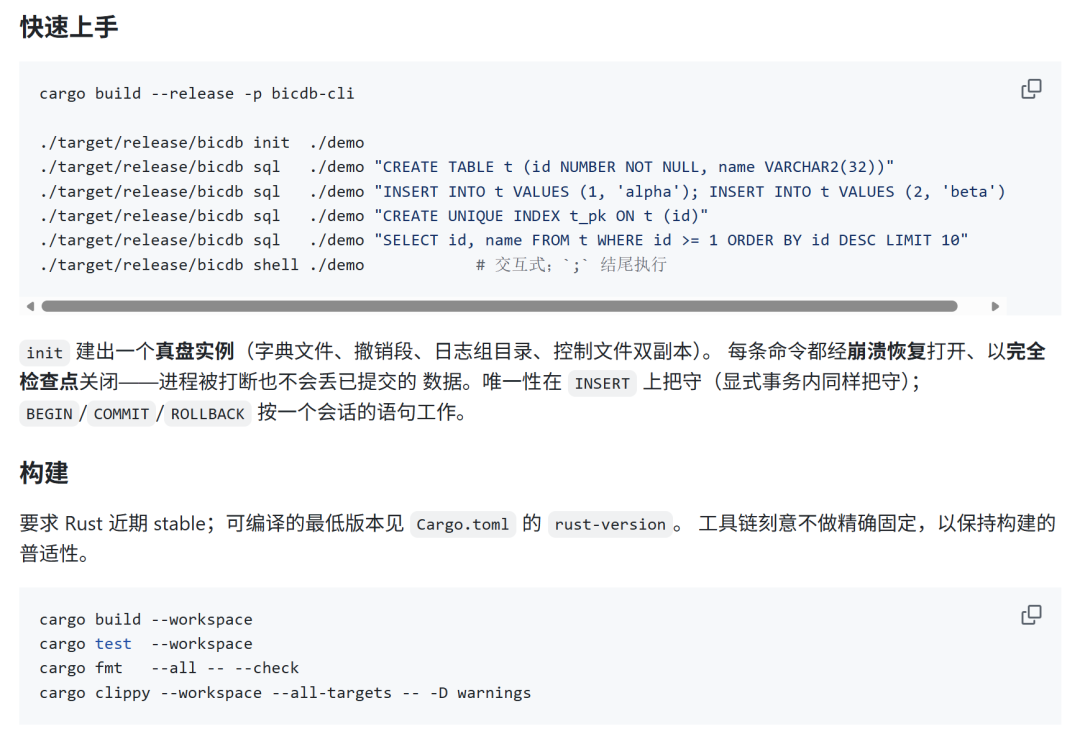
说实在的,能够在长假期间就拿出一个可测试的版本,我也是有些意外的。
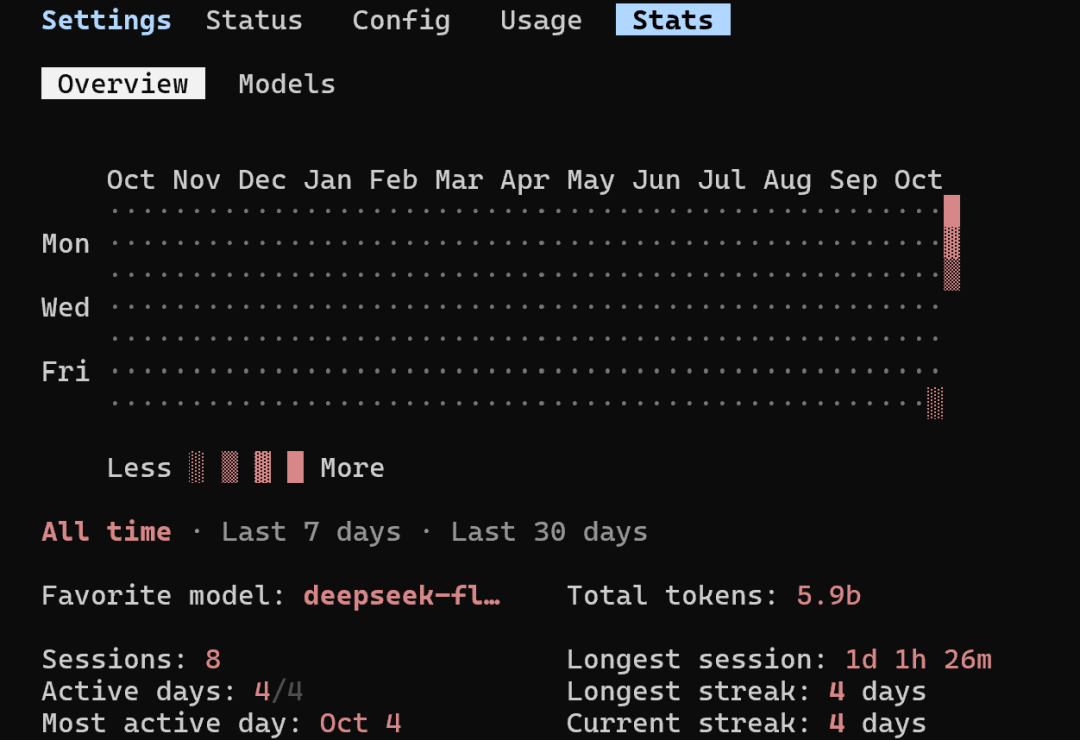
连今天在内,3 号一个多小时的需求导入,4 号完整的一天,5 号实际上只有小半天,再加上今天半天,这么快就完成了一个小 数据库内核 的框架设计与开发,AI Coding 的效率确实可见一斑。这几天我只用 Claude Code + DeepSeek-V4-Flash 进行开发,没有借助任何其他模型。总共消耗了 5.9B token,成本我还没细算,估计缓存命中应该超过 92%。
整个进度比我预期快了半个月,主要是我采用了一个取巧的方法:知识库里已有的东西优先参考 Oracle 的设计思想,Oracle 算法不太好找的,直接参考 PostgreSQL,甚至 SQL 语法也是从 PostgreSQL 语法里裁剪出来的。我并没有让我这个对数据库内核一知半解的人来主导研发,而是让 AI 自己去学习、总结,这一点让整个进度快了很多。那几天我说得最多的话是:“不错,继续”,“挺好,再仔细思考一下,然后推进”。
国庆的实验今天告一段落,后续我会继续完善整个数据库,并持续开源后续成果。未来我们的 BIC-Mate(必伴)也将使用这个数据库。 |  发表于 昨天 23:47
|
查看: 3|
回复: 0


