说明:本文数据均来自作者对 2026 年 9 月公开信息的持续监测(企业官网与新闻稿、FierceBiotech / FiercePharma / 动脉网 / Reuters 等权威医药媒体、Nature Medicine / Nature Biotechnology 等同行评议期刊、arXiv 预印本、企业半年报与 SEC 文件),关键结论均标注可核查来源。ROI 部分只给逻辑思路,不做精确财务测算。
摘要:9 月,礼来、阿斯利康、诺和诺德、罗氏、赛诺菲、勃林格殷格翰同时在"把 AI 接进工作流"这件事上落了子。与此同时,Pathos AI 借别人的分子承诺 22 亿美元、诺和诺德的 CRO 板块单日暴涨 15%。本文拆解 9 月海外药企 AI 的四个落地战场、三类踩坑,以及一切绕不开的那一层知识底座。
一、钩子:9 月的药企 AI,开始在"工作流"里交作业
9 月 16 日,诺和诺德在丹麦 Bagsværd 宣布与 Anthropic 合作。
这条新闻标题看着平淡——"又一家药企用了大模型"。但如果你读它的合作边界,会发现写得异常克制:不是全员开放一个 ChatGPT 式助手,而是由诺和诺德自己的科学家和计算团队提出具体难题,双方共建专用工作流,并且明确写入数据治理与人工监督条款。
诺和诺德 CTO 此前已经用 Claude 做过一件事:把临床试验报告的患者文档撰写,从"数月"压到"分钟"。
同一天,礼来在做另一件事:把 GenScript、Twist Bioscience、Ginkgo Bioworks 三家湿实验服务商拉进 TuneLab 生态。
把这两件事放在一起看,9 月药企 AI 的真实形态就出来了:模型是租来的,工作流和知识底座是自己的。
这句话不是修辞。它是 9 月一整个月里,11 家跨国药企用真金白银投票投出来的结论。下面我把这个月的监测数据重新组织了一遍——先看海外(跨国药企、biotech、CRO、创新药企),再看国内对照,最后落回那件所有事都绕不开的事:本体、图谱与知识底座。
二、9 月海外药企 AI 的四个落地战场
不按技术分类,按钱和人在哪个环节动来分类。这才是数字化负责人真正需要对标的东西。
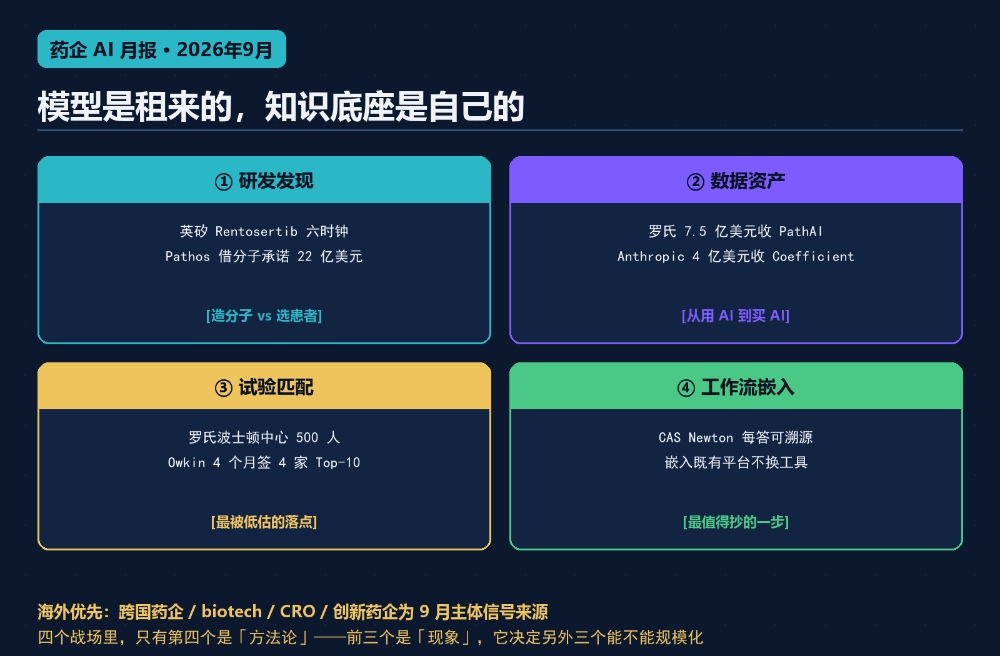
图 · 图1:9 月海外药企 AI 的四个落地战场
2.1 战场一:研发发现环节——从"造分子"到"选患者"
9 月这个战场发生了一次叙事分化。
一条线还是造分子。英矽智能的 Rentosertib 在 9 月 7 日登上《自然·生物技术》:42 名 IPF 患者的纵向蛋白组数据,用 6 个独立开发的蛋白组衰老时钟(ProtAge、OrganAge、PAC 等,分别由哈佛、牛津、北大、英矽等团队训练)评估,6 个时钟一致显示治疗组预测生物学年龄下降,30mg bid 组第 4 周平均逆转 3–4 年,部分时钟峰值接近 6 年。9 月 10 日,这款药在北京协和、上海肺科启动 III 期。
注意这个细节:6 个时钟是独立开发的,不是一家造的。这才是这条新闻真正的可信度来源。
另一条线是"买分子 + 用数据去风险"。9 月 8 日,纽约的 Pathos AI 一周内宣布两笔合作:以 1.25 亿美元首付、最高 20.9 亿美元里程碑从 Alphamab(康宁杰瑞)授权 TROP2/HER3 双抗 ADC;同时与阿斯利康推进一个临床前 PROTAC。这两笔资产都不是 Pathos 自己发现的分子,是它用平台排序选出来的。
Pathos 的 Foundry 部署"数千个 AI agent 并行",由与阿斯利康、Tempus 三方共建的肿瘤学基础模型驱动,整合 730 万去标识患者记录(含 140 万影像、130 万基因组、26 万转录组)。Agent 回答四个问题:哪类分子级患者亚群最可能响应?最优剂量?哪个终点最能捕捉机制?全程成功概率?
一句话概括 Pathos 的赌注:肿瘤学里最贵的不是造分子,是在正确的患者身上证明它有效。
这条线我认为更值得数字化负责人关注,因为它把 AI 的落点从"研发前端的假设生产"移到了"研发中段的决策排序"——而后者才是药企真正烧钱的地方。
2.2 战场二:数据与知识资产——从"用 AI"到"买 AI 的能力"
9 月海外最密集的动作,是并购。
| 时间 |
动作 |
金额 |
战略意图 |
| 9 月 |
罗氏收购 PathAI |
7.5 亿美元 |
数字病理 + 伴随诊断的数据与算法资产 |
| 9 月 |
阿斯利康收购 Modella AI |
未披露 |
定量病理 / 生物标志物 |
| 9 月 |
Anthropic 收购 Coefficient Bio |
4 亿美元 |
自主新药研发能力 |
| 9 月 24 日 |
字节 Anew Labs 首轮融资 |
2.9 亿美元 |
独立 AI 制药实体 |
这里有一个主角是 Anthropic。它 4 月花 4 亿美元收购 Coefficient Bio,6 月发布 Claude Science(部分实验由 Claude 指挥机器人单元),8 月底发布硬件标准 MHS(为显微镜、移液工作站、机械臂提供统一接口),9 月联合湿实验验证服务商 Adaptyv Bio 发起全球最大蛋白质设计大赛(对 5000+ 个 AI 设计做湿实验验证)——并且被 Reuters 披露已在旧金山湾区自建湿实验室。
一家模型公司开始建实验室,这件事的含义很清楚:光有模型不够,必须有能走完整个链条的物理层。 这反过来印证了药企侧的逻辑——光买模型也不够。
2.3 战场三:临床试验与患者匹配——AI 最被低估的落点
Pathos AI 之外,9 月还有一组信号被市场明显忽略了。
罗氏 Genentech 在波士顿启用 AI/心肾代谢 R&D 中心(9 月 24 日):9.5 万平方英尺、10 年租约、可容纳 500 人,AI/ML/数据科学贯穿从早期研究到临床,叠加其已有的 3500+ Blackwell GPU AI 工厂。
这不是"设一个 AI 部门"。这是把一个治疗领域的整条价值链重建成 AI 原生——从靶点、到生物标志物、到临床设计、到数据分析,全部在同一套数据与模型基础设施上跑。
同期 Owkin 的 K Pro 在两个月内连签四家 Top-10 药企:阿斯利康(5 月,3 年授权,AI agent 接入其 IT 与决策流)、赛诺菲(6 月,5 年,为其发现工作流定制端到端 agent)、勃林格殷格翰(9 月 2 日)、施维雅(9 月 11 日)。
K Pro 的底层是 MOSAIC——一个多模态患者数据网络:2725 名患者、2361 份空间组学、2168 份单细胞、6 种模态(空间转录组/单细胞 RNA/批量 RNA/全外显子/数字 H&E/临床),目标规模 7000 名患者、7 个癌种。
MOSAIC 本质上就是一张生物医学知识图谱。这一点很关键,第六节会展开。
2.4 战场四:工作流嵌入——9 月最有借鉴价值的一步
如果只让我从 9 月挑一个最值得抄的案例,我会挑 CAS(美国化学会)9 月 11 日发布的 CAS Newton。
CAS 是一家自 1907 年起持续人工策展全球科学文献的机构,有 150 年的 CAS Content Collection。它做的智能体有三条硬规则:
- 每个回答都能溯源到具体来源——不是"引用文献",是能点开看原文;
- 不要求企业换工具——CAS Connections 框架把可信科学数据直接嵌进 Albert Invent、Sapio、Scilligence、Wolfram 这些科学家本来就在用的平台;
- 支持 MCP / API / Copilot——不做封闭系统。
CAS 传递的判断非常清晰:不是让大模型更会聊天,而是把它关进"权威证据笼子"里,然后嵌进科学家每天用的工具。
这就是"工作流嵌入"的标准做法。对照看看多少药企的 AI 项目死于"做了一个很好的独立平台,但没人用"。
三、ROI 只要逻辑清楚,不用算得太细
我在 9 月的监测里看到太多 ROI 测算把自己绕进去了。这里只给逻辑骨架,不给精确数字——因为精确数字在别人公司内部永远是错的,逻辑才可复制。
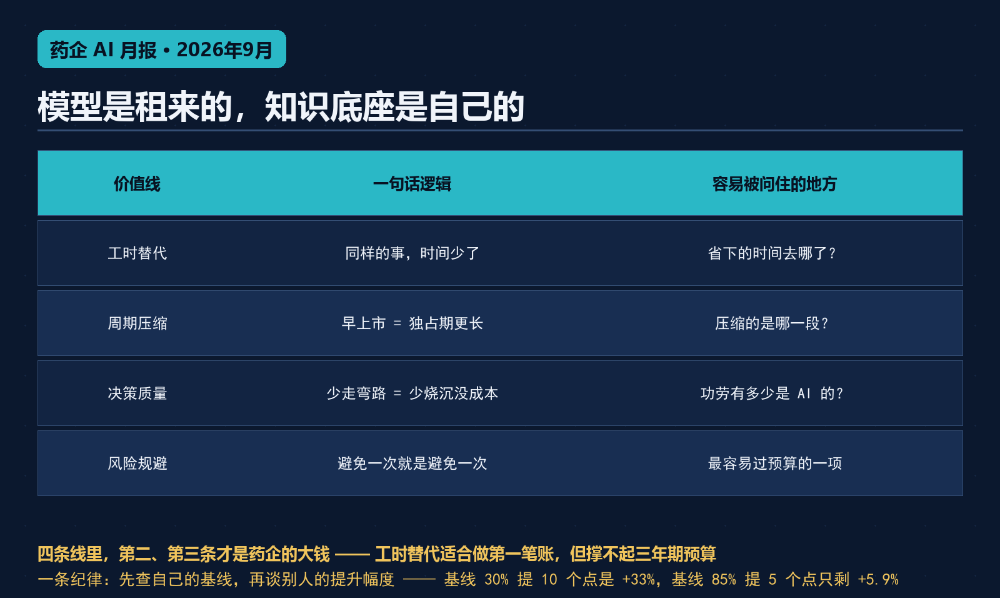
图 · 图2:四条价值线的逻辑骨架
3.1 四条价值线(按"能不能被财务问住"排序)
| 价值线 |
一句话逻辑 |
容易被问住的地方 |
| 工时替代 |
同样的人做同样的事,时间少了 |
"省下的时间去哪了?"——没进损益表就不算数 |
| 周期压缩 |
早上市 = 独占期更长 + 早入账 |
"压缩的是哪一段?"——审批排队 AI 管不了 |
| 决策质量 |
少走弯路 = 少烧沉没成本 |
"这个功劳有多少是 AI 的?"——最难归因但金额最大 |
| 风险规避 |
避免一次就是避免一次 |
这条最容易过预算,因为"不做会亏" |
四条线里,第二和第三条才是药企的大钱。工时替代适合做第一笔账(见效快、好证明),但撑不起三年期预算。
3.2 一条必须记住的纪律:先查基线
9 月我见过的最典型错误,是拿厂商公布的"提升幅度"直接套到自己身上。
厂商说命中率从 70% 提到 90%,那是相对提升 28.6%。但如果你自己的基线本来就只有 30%,提到 40% 是相对提升 33%——比厂商还高;如果你的基线已经有 85%,提到 90% 只剩 5.9%。
所以 ROI 测算的第一步永远不是抄别人的数字,是先查自己的基线。这一句话,能省掉好几次预算会上的尴尬。
3.3 一个真实可对标的锚点
9 月有一条国内公开数据可作参照:以岭药业披露其 33 个智能体 + 40 余个 AI/RPA 数字员工,年节省 2,000 人天(工信部案例,9 月 15 日)。
2,000 人天 ÷ 250 工作日 = 8 个全职人力当量。这个换算让整件事变得可讨论:这 8 个人的成本,和这套系统首年投入,哪个高?
这就是我建议的 ROI 表达方式——不追求精确到小数点,只追求"能不能被一句话讲清"。
四、9 月踩过的三类坑(比成功案例更值钱)
我不想把 9 月写成一份全是好消息的月报。以下是这个月监测到的、我认为最值得警惕的三类失败与争议。
坑一:多模态增益在外部验证里会掉
《自然·医学》9 月 13 日刊出 I3LUNG:6 个国家 2396 名晚期 NSCLC 患者,融合临床/血液 + CT + 数字病理 + 基因组四模态。
结果很诚实——内部测试漂亮,外部验证掉档:仅用临床血液特征时 AUC 0.77,加入影像与病理的深度学习中间融合达 0.88,但外部验证跌到 0.55–0.72。
但这项研究还有一个更有价值的发现:加入 SHAP 可解释层之后,医生阅读研究的 DCR 灵敏度从 0.72 提到 0.87,医生之间的一致性(κ)从 0.11 提到 0.48。
结论是反直觉的:多模态模型的预测增益不一定稳,但可解释层对医生判断的改善是稳的。
这条对药企的含义:AI 的价值可能不在替你做决定,而在让你把决定做得更一致。
坑二:知识图谱接上了,不等于答案对了
9 月 5 日 arXiv 上有一篇我认为被严重低估的论文(2609.01653):做 KG + ODE + RAG 的临床决策支持流水线,103 类疾病生成 3090 条轨迹,CNN 准确率 0.940±0.006,RAG 复合得分 3.82/5。
但它最关键的发现是一句"负面结果":分类正确与分类错误在"证据接地"上的差异仅 −0.02(p=0.839),统计上不显著。
翻译成业务语言:你给模型接上了知识图谱,不代表它的答案就更有据可依。 KG grounding 是必要条件,不是充分条件。
这直接推翻了"接个知识库就能治幻觉"的普遍认知。真正的差别在于本体有没有把约束写进去——第七节展开。
坑三:板块暴涨 ≠ 价值兑现
9 月 16 日诺和诺德宣布与 Anthropic 合作当天,全球 CRO/CXO 板块集体大涨:港股金斯瑞 +13%~15%、凯莱英 +7%,A 股 CRO 板块主力净流入 12.76 亿元。9 月 23 日,上游继续重估——近岸蛋白 +55%、百普赛斯 +39%、华大智造 +32%。
市场逻辑是"AI 缩短研发周期 → 干湿验证提速 → 上游订单上修"。这个逻辑方向是对的,但要注意:研发周期缩短 ≠ 审批周期缩短 ≠ 上市场时间提前。 真正的瓶颈可能在临床入组、可能在审评排队,而这两块 AI 目前能贡献的比重,远低于市场给出的涨幅。
板块的涨幅里,有很大一部分是"未来能省多少钱"的预期折现,不是已经兑现的现金。做内部汇报时,这两者要分清。
五、一个反常识案例:AI 不造药的时候更赚钱
最后讲一个 9 月我最喜欢的案例,它不在任何"AI 制药"榜单上。
雀巢的 Food Genie。
雀巢建了一个约 12 万份配方的数据库,用 AI 在里面预测配方表现、识别改良方向。更关键的是它做了什么产品:把 GLP-1 减重药(Ozempic / Wegovy / Mounjaro / Zepbound)使用者的副作用——肌肉流失、脱水、营养缺口、"Ozempic face"——转化成了一个全新的营养品品类。已经工业化了一组"刺激肌肉组织生长"的两种微量营养素组合,并申请了降低停药后食欲回升的专有成分专利。
雀巢 CTO 说了一句话,我认为是 9 月最值得抄的一句:"AI needs data."
这句话的潜台词是:AI 本身不产生价值,AI 遇到私有数据才产生价值。 12 万份配方库就是雀巢的私有知识资产——它不公开、买不到、也抄不走。
这就是"什么才是药企真护城河"这个问题最直白的答案。
六、专章:本体、图谱增强大模型的企业级落地实践
现在进入本文的正题。
前面五个部分都在讲现象,这一节讲方法论——具体到一家药企该怎么建这套东西,以及 9 月全球范围内已有的落地实践长什么样。
6.1 先看一件事:9 月所有头部动作都在往同一层走
把 9 月这四件事摆在一起:
| 时间 |
主体 |
动作 |
本质是哪一层 |
| 9 月 2 日 |
Owkin × 勃林格殷格翰 |
MOSAIC 多模态患者数据 + K Pro agent |
知识图谱层 |
| 9 月 11 日 |
CAS |
CAS Newton 可溯源智能体 + Connections 嵌入框架 |
本体 + 溯源层 |
| 9 月 16 日 |
英矽智能 |
MCP 蛋白质设计工作坊(AlphaFold/RDKit/OpenMM 串联) |
编排层 |
| 9 月 16 日 |
诺和诺德 × Anthropic |
Claude Science 共建专用工作流 |
工作流嵌入层 |
四个主体、四种身份(biotech / 学术机构 / AI 药企 / MNC),指向的是同一层:把散落在不同系统、不同格式、不同口径里的知识,统一到一套可推理、可溯源的语义层上。
而英矽的 MCP 工作坊尤其值得单说——它公开教人用 MCP 协议把 AlphaFold、RDKit、OpenMM 和自有化合物库串成一个蛋白质设计智能体。这是"知识底座 + 开放协议"路线的公开示范。
6.2 企业级落地的四层架构
我在 9 月的监测里反复看到同一个结构。把它抽象出来是这样四层:
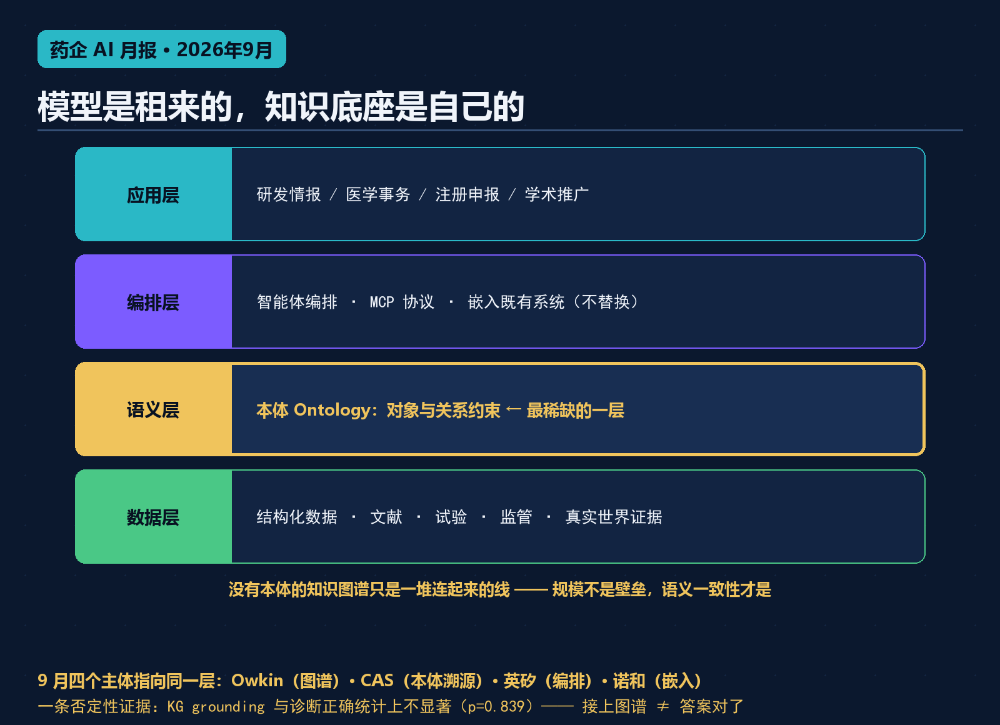
图 · 图3:企业级知识基座的四层架构 —— 语义层最稀缺
逐层说明。
数据层——大多数药企不缺这一层。EDC、LIMS、SOP 系统、注册申报系统、医学图书馆,数据都在。
语义层(本体)——这是绝大多数药企缺的那一层。
什么是本体?用最朴素的话说:把你要管的东西列成对象,把它们之间允许的关系和约束写下来。
比如"药物""靶点""通路""适应症""患者分型""试验""监管要求"分别是对象;"这个靶点在那个通路上"、"这个适应症由那个标志物定义"是关系;"一个试验必须关联至少一个适应症和一种监管口径"是约束。
没有本体的知识图谱,只是一堆连起来的线——查询的时候无法保证语义正确。GSK 有 110 亿条关系的知识图谱,天士力"数智本草"有 133 万实体、300 万关系。但规模不是壁垒,语义一致性才是。
编排层——用 MCP 这类开放协议把工具边界标准化。这一层是 2026 年才真正成熟的,也是英矽 9 月公开演示的那一层。核心价值是:模型会换、工具会换,但编排协议是相对稳定的。
应用层——最容易被看见,但最不值钱。因为换一个应用,如果语义层建好了,边际成本会骤降。
6.3 三个已经跑通的落地场景
场景一:注册申报与文档自动化
诺和诺德用 Claude 把临床试验报告的患者文档撰写从"数月"压到"分钟",是这条线最直接的证据。国内的对标是万邦医药披露的 AI 工作流:医学写作提速 3.8 倍、SOP 文档差错率 −92%、临床数据交叉核对耗时压到 1/7(投资者关系,9 月 17 日)。
这条线能跑通的原因:注册申报是高度规则化、有确定答案、且必须可溯源的场景。它天然适合"本体约束 + 大模型生成 + 人工复核"。
场景二:CMC 工艺知识管理
9 月 14 日 arXiv 上有一篇非常务实的论文(2609.11493):赛诺菲的小分子项目,做多层知识图谱 + agentic RAG 的 CMC 工艺开发平台,在 505 道题上 Tier-1 准确率 95%、Tier-2 LLM 评判通过率 85%。
这个案例的价值在于它直面了一个真实痛点:"文档孤岛 → 工艺智能"。 工艺开发知识散落在实验记录、SOP、报告、邮件里,传统搜索找不到,大模型又不敢信。知识图谱是把这些文档变成可查询对象的那一层。
场景三:研发情报与管线决策
Owkin 的 K Pro 是这条线的标杆:统一环境做可复现分析、用自然语言提问、运行自主 campaign,同时支持"科学家在回路"和"自主假设生成-测试-排序"两种模式。
它值得抄的地方不是技术,是产品形态:它被 MNC 当成 ERP/数据中台级别的基础设施来采购,而不是一个"AI 工具"。四个月内签下四家 Top-10——这个采购节奏说明 MNC 已经把这类平台归入必须采购的品类。
6.4 一条否定性证据,和一个正面解法
9 月还有一篇值得单说的论文:BioGlyph(arXiv 2609.03229,9 月 3 日)。
它做了一件很有意思的事:把网络拓扑编译成可解释的"结构角色语言"——hub(枢纽)、community core(社区核心)、cross-community connector(跨社区连接者)。这样,开源 LLM 在 20 个跨域网络上的结构推理准确率,比直接喂边表/数值表示最高提升 26 个百分点,在酵母互作网络上达到 75.6%。
这篇论文回答的正是前面第四节第二个坑:为什么接上知识图谱不代表答案对了?
答案就在这里:直接把图结构丢给大模型是没用的,必须把图结构"翻译"成大模型能读的语言。
这就是本体工程师的价值所在——不是把数据连起来,而是把关系翻译成模型能用的形式。
6.5 一张选型决策表
如果你正在评估这条路,我用三个问题帮你收敛:
| 你的情况 |
建议路线 |
为什么 |
| 只做一个场景,要快速见效 |
先接通用大模型 + RAG,语义层后补 |
快,但要接受口径不稳 |
| 打算做三个以上场景 |
先建语义层(本体 + 图谱) |
第二个场景的边际成本会骤降 |
| 场景涉及跨部门数据对齐(医学/市场/准入共用口径) |
必须做本体 + 图谱 + 大模型融合 |
这是唯一可行解 |
选错路线的代价不在第一年,在第 12–18 个月。那时候你会发现手上有一堆口径不一致的 AI 应用,而重构比新建贵得多。
七、专章:Palantir 类企业 × 全球药企的合作案例
上一节讲的是"方法论从哪来"。这一节讲这套方法论的产业原型是什么样,以及它已经在哪些地方落地了。
7.1 Palantir 的护城河从来不是模型,是 Ontology
Palantir 是一家成立二十年的公司,它的核心产品叫 Foundry,但真正让它难以替代的,是一个叫 Ontology(本体) 的东西。
它的逻辑可以用一句话说清:把散落在不同系统、不同格式、不同口径里的数据,统一到一套可推理的对象模型上,让上层应用能在同一个语义层上跑。
这句话听起来抽象,但对比一下就清楚了:
| 场景 |
直接接大模型 |
有本体/图谱基座 |
| "我们的二线品种在哪些科室被提到最多?" |
模型不知道"二线品种"指什么,每次口径不一致 |
品种是对象、科室是对象、关系已定义,结果可复现 |
| 换一个问题问 |
重新组织 prompt,答案粒度和风格都变 |
同一套底层对象,换的是查询方式 |
| 结论要能追责 |
无法回答"这个数从哪来" |
每个数字可回溯到源对象和源关系 |
| 规模化 |
每加一个应用重做一遍数据对接 |
新应用复用语义层,只写查询 |
一句话:大模型解决"能不能读懂",本体解决"读懂之后说的是不是同一件事"。
7.2 9 月的最新证据:Palantir 把 Ontology 推到了物理层
2026 年 10 月 1 日,Palantir 宣布与 Armada 合作推进"主权 AI 基础设施"。Armada 成为 Palantir 首个"认证模块化数据中心伙伴"。
Palantir CEO Alex Karp 的表述值得完整引用一次:本体(ontology)让机构掌控自己的数据、模型与微调输入。
这句话的野心在于:Palantir 正在把 Ontology 从"软件语义层"延伸到"硬件在哪国制造"的地缘层级。
技术细节也很有意思:Sovereign AI OS(AIP + Ontology + Foundry + Apollo)× Armada 的 Galleon 模块化数据中心,搭载 NVIDIA B300 GPU,每单元 32 颗,支持离网/气隙部署,官方说法是"数月而非数年"交付。Armada 在 2026 年 5 月完成 2.3 亿美元 B 轮,估值 20 亿美元(Overmatch、BlackRock、8090 联合领投)。
另一条更早但方法论更关键的线索:Palantir 在 7 月 27 日发过一篇博客《AI Sovereignty is Your Alpha》,核心论点是不要把企业的"alpha"(独特优势)转移给托管模型提供商。
把这两件事连起来看,Palantir 的产业判断是:数据主权和语义主权是一件事的两个面。
7.3 Palantir 类企业 × 全球药企:三类合作形态
医药行业没有出现"某药企全面部署 Palantir"这种大新闻,但同构的合作已经成规模地发生了。我把它们归成三类。
第一类:数据资产 + AI Scientist 双授权(最成熟)
代表是 Owkin。它 4 个月内签下阿斯利康、赛诺菲、勃林格殷格翰、施维雅四家 Top-10,商业模式不是"卖软件 license",而是"数据生成 + 平台"双授权——MNC 获得多模态患者数据授权,同时用 K Pro 平台做可复现分析。
这就是 Palantir 模式的医药版:数据不出域、平台嵌入决策流、按数据资产收费。
第二类:权威知识底座 + 嵌入式智能体(最可复制)
代表是 CAS Newton。它的三层设计——可溯源(每个答案能点开看原文)、不换工具(嵌入既有平台)、开放协议(MCP/API/Copilot)——几乎是 Palantir Ontology 思路在科学知识领域的复刻。
这家机构值得国内药企认真研究,因为它的规模和投入是大多数企业能对标的,不像 Palantir 那样遥不可及。
第三类:联邦学习生态(最适合数据主权敏感场景)
代表是 礼来 TuneLab。它的模式是"模型走出去、数据不出域":用 NVIDIA FLARE 做隐私保护联邦学习,礼来开放自己的 AI 模型给外部伙伴,伙伴在本地跑、只回传模型更新。
9 月 8 日,TuneLab 迎来首家韩国 AI 药研伙伴 Pharos iBio。伙伴数已超 70 家,年内目标 150 家。9 月 24 日,GenScript、Twist Bioscience、Ginkgo Bioworks 三家湿实验服务商加入。
礼来在这件事上的角色,本质上是"用平台把外部创新组织起来"——这也是一种知识基础设施。
7.4 这对药企意味着什么:三个可操作的动作
动作一:把"可溯源"列为一票否决项。 评估任何 AI 供应商时,只问一句:这个答案能不能点开看到原始出处?做不到的,在监管语境下就是一个随时会被叫停的东西。9 月 FDA 的 GenAI 讨论文件(docket FDA-2026-N-7874,10 月 19 日截止)已经明确提出双轴风险框架和基于胜任力的生命周期评估——"说清证据从哪来"正在从技术优点变成监管要求。
动作二:先做本体盘点,不要先买平台。 这一步不需要建系统,只需要一份清单:列出你要管的核心对象、它们之间的关系、哪些关系是决策规则。这份清单是后面所有工作的地基。没有它,你买的每一个平台都会变成新的孤岛。
动作三:把知识层当成资产来管,而不是当成 IT 项目来管。 9 月最清楚的一个对比:GSK 的 110 亿条关系知识图谱、天士力的 133 万实体/300 万关系、药图智能的 3000 万实体/4000 万关系、京东健康的 17 万医药知识图谱——规模差异巨大,但都在做对同一件事:让答案能回溯到源头。规模不重要,语义一致性和可回溯性才重要。
八、国内对照:三条可参考的本土路径
前面全部是海外。国内的情况单独说,因为它们走的路不太一样。
路径一:AI 原生药企上市与出海的节奏在加速。 英矽智能 H1 营收 1.06 亿美元、同比 +287%,首次半年度盈利,累计合作总价值约 110 亿美元(2026 年至今约 73 亿)。晶泰科技 AI4S 智慧解决方案收入 1.94 亿元、同比 +136.4%,收入占比从去年同期的 16% 跳到 49%,最大客户占比从 70.6% 降到 32.9%。
晶泰那组数字最关键:AI 业务从"研发费用"变成了"能独立撑起报表的主营业务"。一旦 AI 业务开始独立对营收负责,它就从技术话题变成了董事会话题。
路径二:国内首款"AI 辅助研发"创新药获批。 9 月 6 日,西湖大学/西湖实验室/西湖制药的"艾普司韦"获 NMPA 附条件批准,从源头发现到完成临床仅 3.5 年。路径是:490 亿化合物 DEL 库初筛 100+ 潜力股 → 建 3CLpro 靶点 AI 模型 → 选 9 个分子合成测试、6 个强抑制活性 → 锁定候选 WLU6937 → 两年优化中持续用湿实验数据反哺迭代。
注意这里的关键词是"完整链条":计算预测 → 实验验证 → 数据反馈 → 模型再优化。AI 的价值不在预测本身,在链条转起来的速度。
路径三:中药与知识图谱的结合是中国的独特机会。 天士力"数智本草":训练语料包括 8000+ 部古籍、1.2 亿篇期刊文献、30 万份医案、350 万+ 天然产物、20 万+ 组学样本;自研 NLP 治理古籍、医案、处方,构建 133 万+ 实体、300 万+ 关系的知识图谱。
9 月 4 日数博会,国家中医药管理局监测统计中心联合天士力等 12 家机构发布中医药新药研发高质量数据集,打通"采集—标准化治理—跨尺度关联—知识图谱化应用"全流程。
这条路的国际对照物其实是 CAS——都是"把人工策展的权威知识做成 AI 的可信底座"。中国在这件事上有独特的素材优势(古籍、医案、经方),这是海外做不了的。
九、30 天行动清单
如果看完只做五件事,我建议这个顺序。
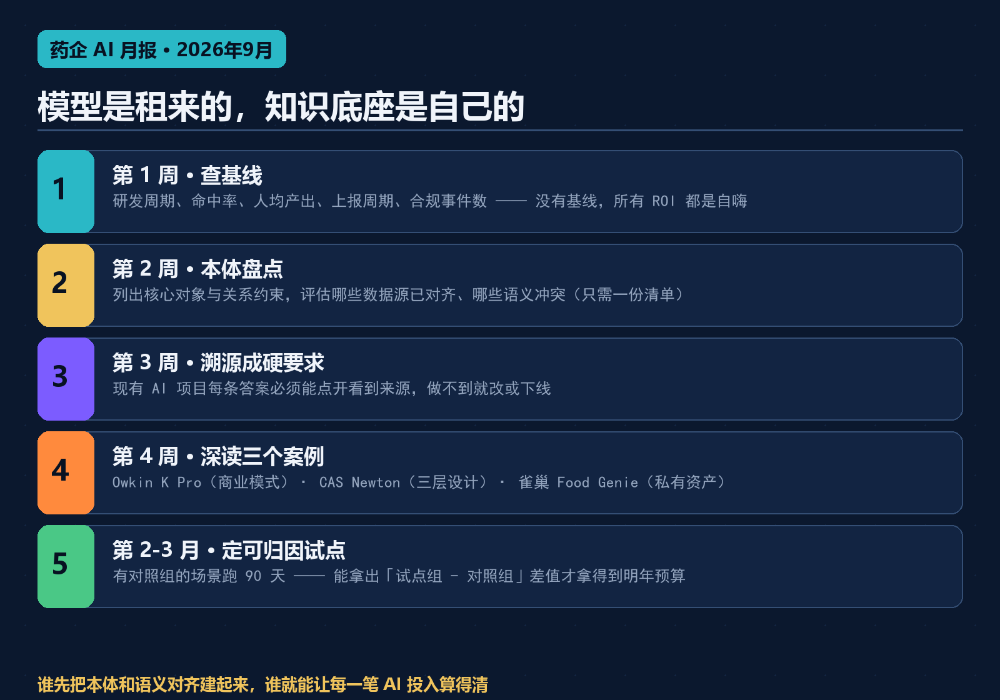
图 · 图4:30 天行动清单
第 1 周:查基线。 不要问"AI 能做什么",先把五个关键指标的历史值拉出来——研发周期、命中率、人均产出、上报周期、合规事件数。没有基线,后面所有 ROI 都是自嗨。
第 2 周:做一次本体盘点。 列出你要管理的核心对象和它们之间的关系约束,评估现有数据源里哪些已经对齐、哪些是语义冲突。这一步不需要建平台,只需要一份清单。
第 3 周:把"可溯源"变成硬要求。 在你现有的 AI 项目里加一条:每个答案必须能点开看到来源。做不到的项目,要么改,要么下线。这是应对 FDA 10 月 19 日窗口最低成本的准备动作。
第 4 周:找一个可对标的案例深读。 我建议读三个:Owkin 的 K Pro 商业模式、CAS Newton 的三层设计、雀巢 Food Genie 的"私有知识资产"逻辑。三个案例分别对应知识图谱、本体溯源、私有数据资产三条线。
第 2–3 个月:定一个能拿出差值的试点。 选一个有对照组可能的场景(渗透率、采纳率、响应时长这类可观测指标),跑 90 天对照实验。能拿出"试点组 − 对照组"差值的项目,才是你明年能拿到预算的项目。
最后回到开头那句话。
9 月的全球药企 AI,已经把话说得很清楚了:模型是租来的,工作流和知识底座是自己的。
租来的东西会降价、会换代、会停服。自己的东西会复利。
谁先把本体和语义对齐建起来,谁就能让每一笔 AI 投入算得清;谁算不清楚,就只能在每次预算会上,重新讲一遍那个关于未来的故事。
本文基于作者对 2026 年 9 月公开信息的持续监测整理,涉及的所有数字均标注来源;ROI 部分只给可复用的逻辑框架,不构成投资建议,也不代表任何具体企业的财务口径。更多技术讨论可访问云栈社区。
 发表于 3 小时前
|
查看: 4|
回复: 0


