2020 年 4 月 20 日,原油期货结算价为负。Jane Street 的系统里写死了一条假设:价格永远为正。那天,这条假设击穿了订单入口。
讲另类数据之前,先讲这件事,因为它定义了这篇文章的全部主题。
Eric Mannes 在 Jane Street 做了十多年大宗商品交易员,如今协助领导公司的另类数据团队。2026 年 9 月 2 日,他坐上公司官方播客《Signals & Threads》第 29 期,节目名字叫得很直白:Wrestling the World into Rows,把世界拧进行里。
七十多分钟,从负油价讲到一个跑在 Excel 里的风控系统,讲到「公司到底是什么」,讲到厂商半夜改标签,讲到 LLM 为什么不能碰旧数据。
听完你会发现一句话反复出现,它也是全文的题眼:
「用厂商修正后的历史回测,你研究的不是当时能做什么交易——你在模拟一台时间机器。」
三秒版:
一,另类数据不是数据种类,是位置。离你的交易系统越远、越需要「拧」,就越另类。
二,真实数据里的时间机器不藏在数字里。它藏在日历、披露滞后、重叠期间和厂商改标签里。我们抓了真数据验证。
三,大模型爆发让能加工的模态暴增。但加工的核心不是模型,是 schema、vintage 和评估。我们在真实 8-K 上亲眼看到:LLM 抽对了数,错的是我们自己的标签。
四,2026 年的前沿不是更大的模型,是密封的评估器。LLM 读过未来,它不配当裁判。
一句话总结:这篇讲的,就是时间机器怎么被装进你的另类数据管线——以及拒绝它的人靠什么防守。
01|另类数据到底是什么?
先给一个几乎循环论证的定义,再看它为什么好用。
Mannes 的说法是:另类数据,就是投资流程里本来不用的数据。
主持人立刻戳中要害——用的人足够多之后,它还算「另类」吗?
他承认,然后补了一句让 vendor 不舒服的话:在 Jane Street 的内部口径里,卫星数据是另类数据,SEC 财报也是另类数据。真正「传统」的只有两样:交易所实时行情,和跑交易、风控必需的合约元数据。
这个边界有组织架构背书。市场数据团队、元数据团队,以及收编「其余一切信息」的另类数据团队。
所以判断一份数据另类不另类,别问它新不新,问两个问题:
它在你的组织里离交易有多远?
它在时间上是否「当时可知」?
下面是这期节目的地图。注意它从哪里开始——不是数据,是负油价那天崩掉的系统假设。
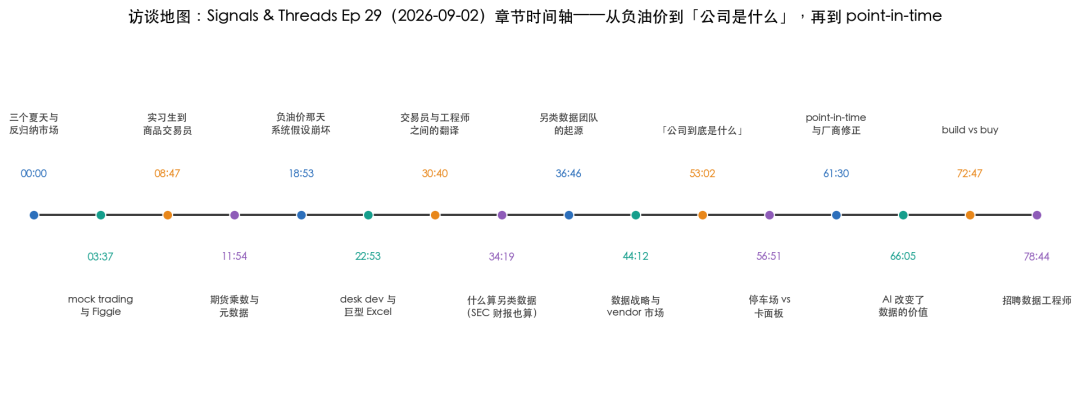
▲ 十六个章节,直接谈另类数据的只有后半段。前半段是期货乘数、元数据、和一个跑在 Excel 里的风控系统。
把视野拉开,业界通常把另类数据分成八个家族。
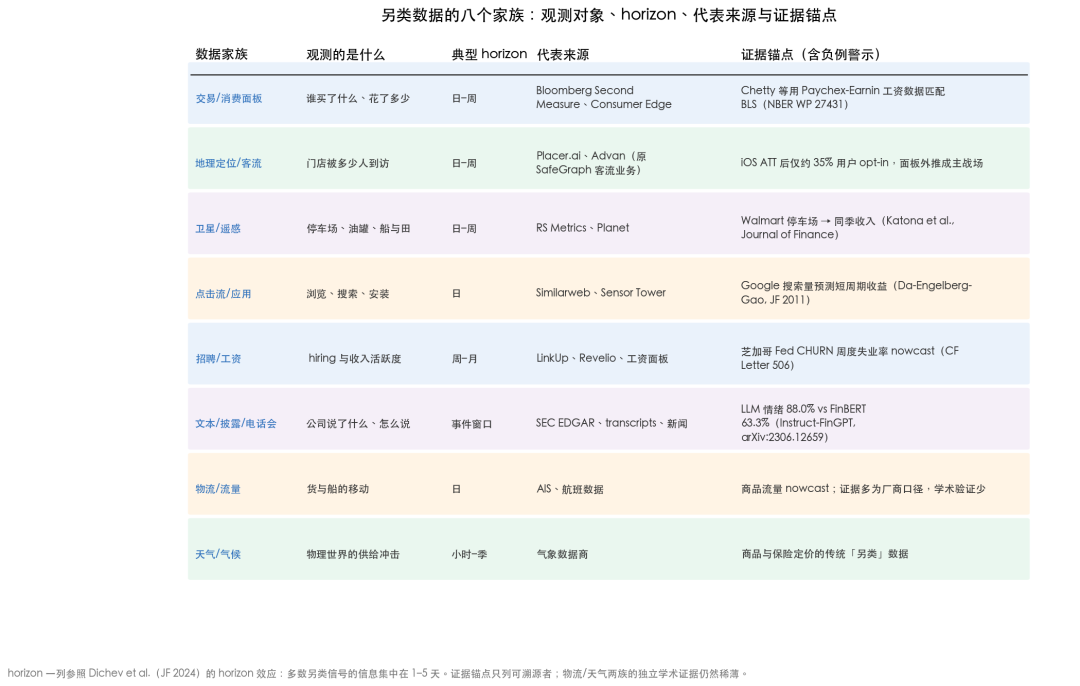
▲ 按「观测的是什么」排开。注意 horizon 一列:有研究说多数另类信号的信息集中在未来 1–5 天。这一条,决定了后文所有建模讨论的形状。
02|案例画廊:谁有硬证据,谁只有故事
按证据强度排,不按热度排。
卫星和遥感,有一个顶刊级的锚。 Katona 与 Painter 发现,卫星停车场数据加快了盈利信息进入股价的速度——首先是价格效率的证据,其次才是 alpha 的证据。Mannes 对「数 Walmart 停车场的车」这个经典案例的评价很冷静:照片噪、拍得稀、Walmart 两成销售在线上、纽约购物者不开车。而且它测的是「来了多少人」,不是「花了多少钱」。
消费面板,最硬的验证在宏观,不在交易。 Chetty 等用 Paychex-Earnin 的工资数据追踪疫情冲击,与官方统计高度吻合。但那是总量冲击,不是截面 alpha。商业侧的结局是:Second Measure 被 Bloomberg 以逾 1 亿美元收购。
地理定位,一场隐私清算改变了供给。 FTC 诉 Kochava,2026 年 5 月和解,首例敏感位置数据禁售令。苹果 ATT 之后只有约 35% 的用户 opt-in——位置面板从全量观测退化为小样本外推,外推模型本身成了新的偏差来源。
点击流,是被监管直接抹掉供给的家族。 Jumpshot 2020 年 1 月 30 日关停,Hitwise 不到一个月跟进,Avast 2024 年被罚 1650 万美元并禁售浏览数据。学术锚点反而更老:谷歌搜索量能预测短周期收益、约一个月内衰减。
社会情绪,一个著名正结果,和一堆没能复现的追随者。 2011 年那个「推特情绪预测道指 86.7% 方向准确率」此后复现普遍失败。要引用,引 Seeking Alpha 情绪那篇,别引它。
物流与天气,独立学术证据稀薄。 多数「案例」停留在厂商口径。本文不把它们当证据使用。
每个家族的加工管线、失败模式与评估方式,在第 05 部分按模态逐一拆开。
03|清洗:三个坑,和一门科学
Mannes 用三个具体的坑,讲清了这门科学。
坑一,公司到底是什么。 双重上市公司算一个实体还是两个?数据对应公司、share class、ISIN 还是某个 listing?公司会改财政日历、会重述报表。他的原话是:你必须时刻想清楚,什么数据在什么时间点可知。
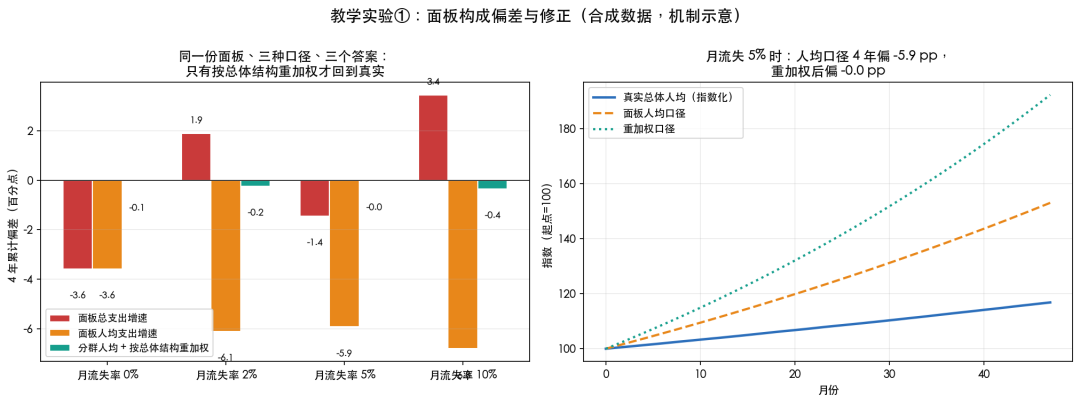
坑二,样本里人变多了,不等于人们花得多了。 面板不是随机样本。信用 unions 持卡人和 Chase Sapphire Reserve 持卡人消费行为不同;有人进出面板。不回答构成问题,面板总支出增速就不是任何经济学量。
坑三,厂商修正,就是时间机器。 厂商会改历史:列口径变更、商户标签事后修正。「原先归到 A 品牌的交易,其实属于 B。」
Jane Street 的做法朴素而强硬:
保存每份数据,连同我方收到它的时间戳。无论厂商怎么改自己的时间戳,「我们何时收到」永远可重建当时可知的数据面。
这和他们对交易所行情的态度同源:更信自己网卡落包的纳秒,而不是交易所时间戳。
整条流水线长这样。关键不在方框,在两条回边。
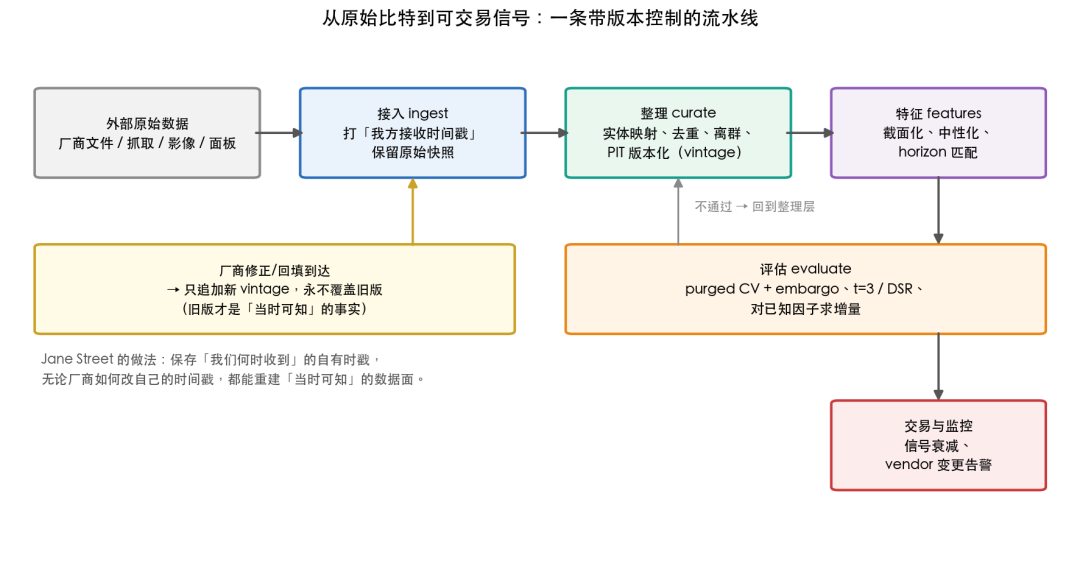
▲ 厂商修正只追加新 vintage、永不覆盖旧版;评估不通过回整理层,而不是硬上模型。
这个机制的合成版本长这样(实验 2,合成数据):厂商实时交付 s+噪声,90 天后交付「修正版」s+0.25×噪声。同一条策略、两份历史,回测 IC 0.022 对 0.049——放大 2.3 倍。
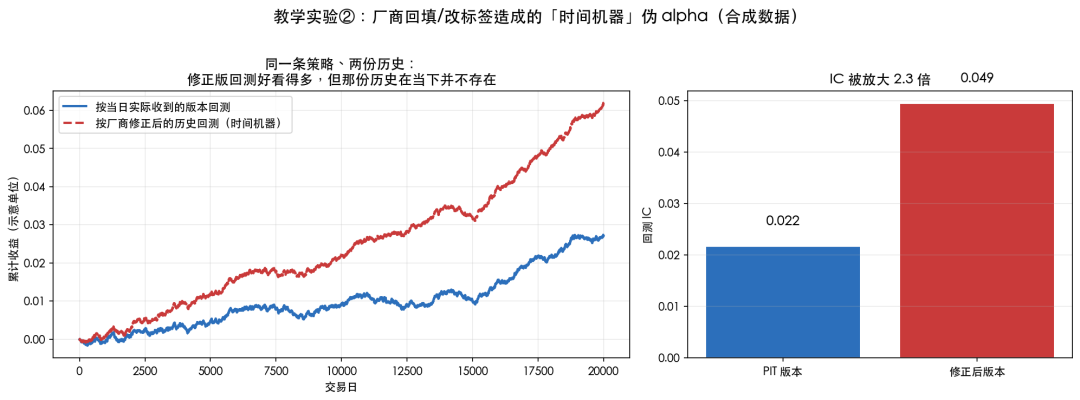
▲ 红色那条净值曲线,在任何一个「当下」都不存在。
但合成演示不够说服力。我们去抓了真数据。
04|真数据实验:EDGAR 是一块时间机器化石层
我们从 data.sec.gov 抓了四家公司的原始记录:AAPL、COST、TGT、WMT。每条记录自带「哪份表格、何时提交」的时间戳。
先说一个诚实的负结果:约四十个公司-年度里,年度收入的重述次数为 0。 蓝筹的数字本身极稳。
那么时间机器在哪?在三处更隐蔽的地方。
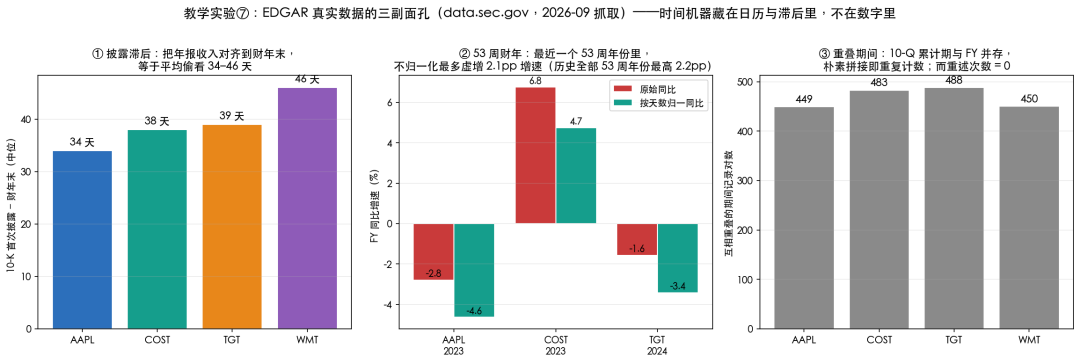
第一副面孔,披露滞后:34 到 46 天。 10-K 首次提交减去财年末的中位数:AAPL 34 天、COST 38 天、TGT 39 天、WMT 46 天。把年报收入对齐到财年末做回测,等于平均偷看一个多月未来。这是初学者最常犯、也最沉默的前视偏差。
第二副面孔,53 周财年:不归一化,最多扭曲 2.1 个百分点。 Costco FY2023 是 53 周年:原始同比 6.8%,按天数归一后 4.7%。AAPL FY2023、TGT FY2024 同病,各扭曲 1.8pp。Costco 的 53 周年是业界著名陷阱——真实数字就在这里。WMT 没有 53 周年,对照组同样重要。
第三副面孔,重叠期间:每家约 450 到 490 对。 10-Q 的累计期和 FY 并存。朴素拼接,就是重复计数。
还有一份活化石,藏在文档内部。
同一份沃尔玛 FY27-Q2 新闻稿里,自带一张带 as-of 日期的指引修订表:
2026-02-19,净销售(恒定汇率)+3.5% 到 4.5%。
2026-05-21,不变。
2026-08-20,上调至 +4.0% 到 5.0%。
一份文档里躺着三个 vintage。用 8 月的表回测 2 月的决策,就是时间机器。
下面这个动图把它演出来。
▲ as-of 日期推进时,增速信号只在披露日跳变,从不在财年末跳变。任何在财年末「看见」当年增速的回测,都在用一份不存在的文件。
05|怎么加工:六种模态的完整解剖
这是大模型爆发真正改变的地方。
以前处理不了的模态——电话会音频、卫星影像、非结构化披露——现在都能进管线了。Mannes 的描述很克制:
「一部分是机械的,但我们造工具把机械部分尽量自动化。剩下的部分,是思考这个字段到底是什么意思。」
把六种模态摊开,每张管线的形状都一样:输入、转换、行 schema、失败模式、评估。LLM 只出现在「转换」那一列;纪律在 schema、vintage 和评估列。
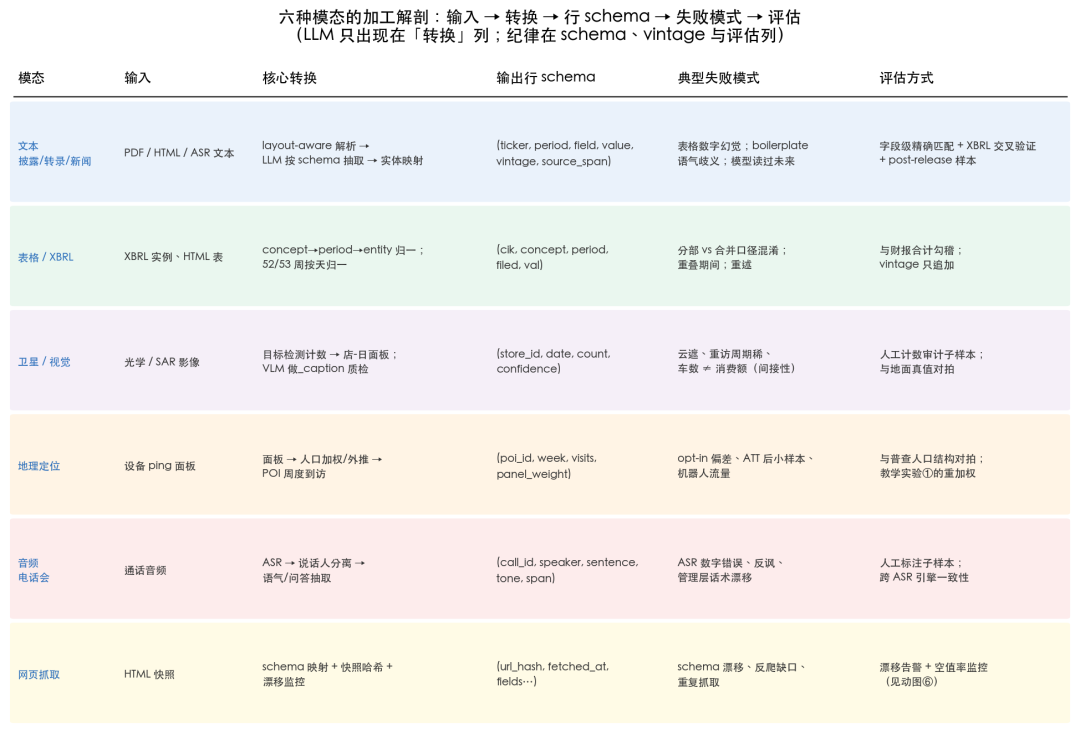
▲ LLM 是提取器,不是纪律。纪律是:每行都带 vintage 和 source_span;每个失败模式都有对应的监控或审计。
文本与披露:我们在真实 8-K 上踩到的坑
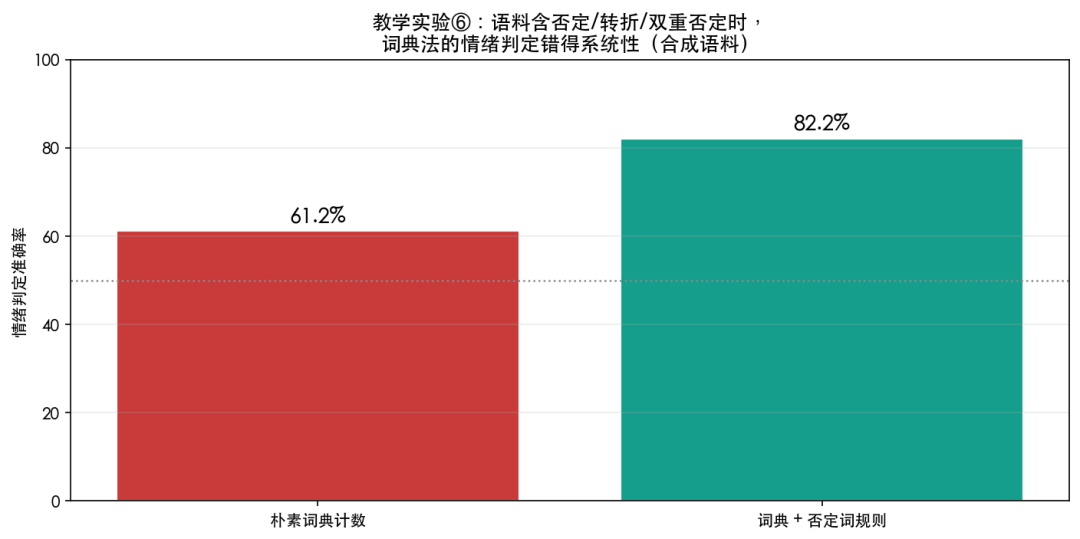
先看难度从哪来(实验 6,合成语料)。当四分之一的句子含否定、一部分含「although」式转折、双重否定、否定作用域陷阱(「did not show growth」)时,朴素词典计数的情绪准确率只有 61.2%,加否定词规则升到 82.2%。剩下的缺口,才是 LLM 声称要填的部分。
文本族的难度是结构性的,不是词表问题。
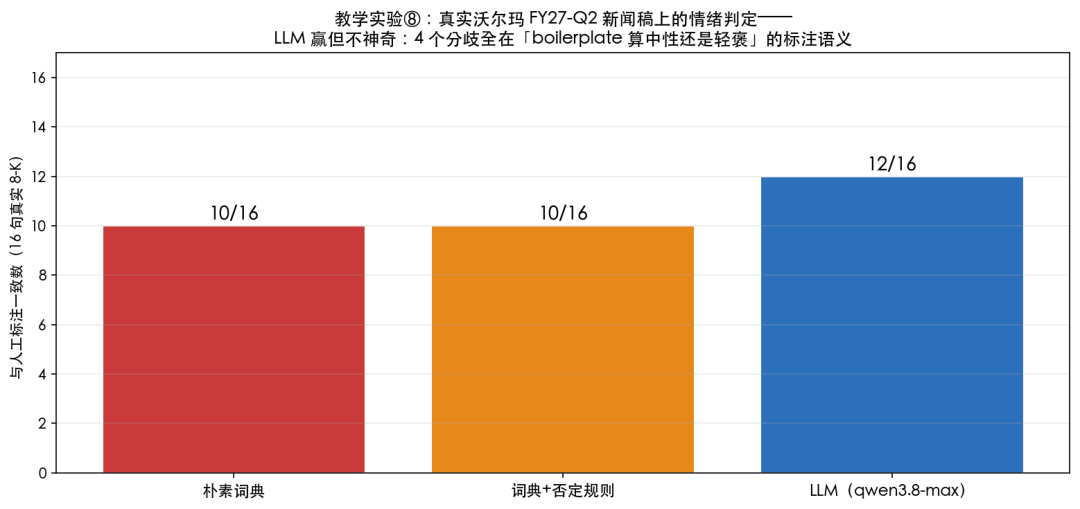
再上真实句子(实验 8,16 句真实沃尔玛 8-K)。朴素词典 10/16,加否定规则 10/16,LLM 12/16。
LLM 赢,但不神奇。它的 4 个错判全落在同一类分歧上:非 GAAP 的 boilerplate 句子,算中性还是轻褒?
在 boilerplate 上,连 ground truth 都不唯一。
然后做字段抽取(实验 9)。这里发生了全文最重要的一次翻车——翻的是我们自己的车。
我们让 regex 和 LLM 从同一份新闻稿里抽 8 个字段。人工标注的「真相」里写着:Q2 净销售 125.2、经营利润 8.1。
LLM 交回来:186.1 和 9.383。
第一反应是模型幻觉。然后我们去查 XBRL——机器可读层里,2026-05-01 到 07-31 的三个月记录明明白白:合并净销售 186.1、合并经营利润 9.383,10-Q,2026-08-28 提交。
而 125.2 和 8.1,是新闻稿里 Walmart U.S. 分部那张表。
LLM 抽对了。错的是我们的标签:字段没有做实体限定。
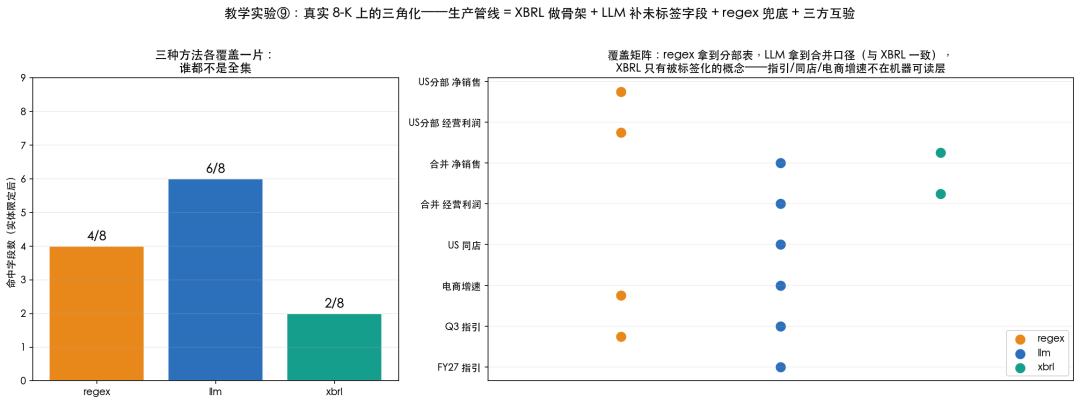
▲ regex 拿到分部表,LLM 拿到合并口径(与 XBRL 一致),XBRL 只有被标签化的概念——指引、同店、电商增速不在机器可读层。三种方法各覆盖一片,谁都不是全集。
这就是 Mannes 那句「公司到底是什么」的现场版:不写清 entity 的字段,连 ground truth 都是歧义的。
生产管线的正确形态由此浮现:XBRL 做骨架,LLM 补未标签字段,regex 兜底,三方互验。 不一致即告警。
抽取流的完整形态,包括那道必须有的漏门:
▲ schema 受限、每行 stamped vintage、带 source_span;混入「未来知识」的行被泄漏门拒绝入库。
泄漏不是比喻。用任何一个训练截止晚于任务文档的模型处理旧数据,语气和字段都会被未来污染。
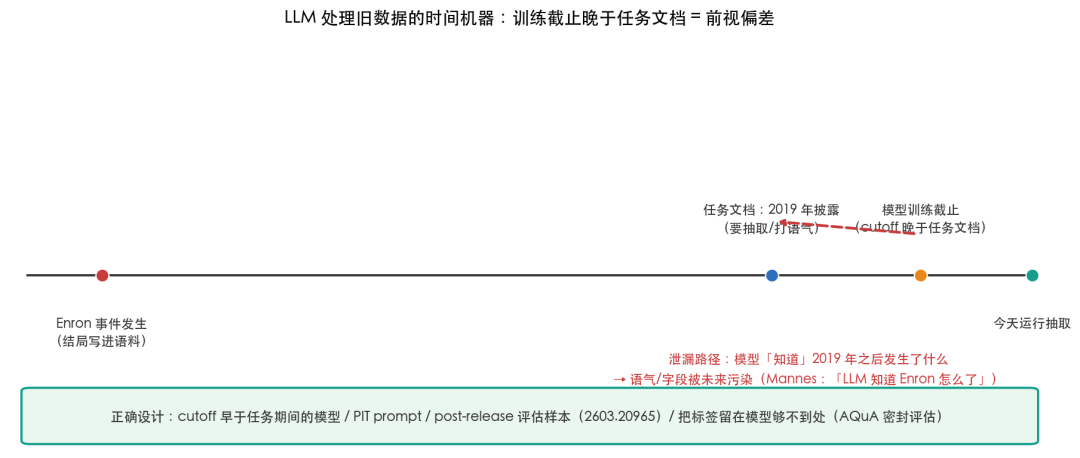
▲ Mannes 的原话版本:「LLM 知道 Enron 怎么了。」正确设计有四条:cutoff 早于任务期间的模型、point-in-time prompt、post-release 评估样本、把标签留在模型够不到处。
表格与 XBRL:权威,但窄
机器可读层的三件事在第 04 部分已经验过:52/53 周按天归一、重叠期间去重、重述只追加。
这里补一条加工纪律:XBRL 的 concept 也有口径。 同一个收入 concept,三个月记录和六个月记录并存(361.8 对 186.1)。period 的 start 和 end 必须一起进 schema,只存 end 就是埋雷。
卫星与视觉:从像素到面板要过四道关
目标检测出计数,拼成店-日面板,校准到地面真值,才轮到建模。
四道关各自会死。云遮:计数缺失不是零。重访周期稀:周频影像做日频信号是自欺。间接性:车数不等于消费额,这是 Mannes 的批评。检测置信度漂移:模型升级后历史计数不可比——又一类 vintage 问题。
评估只做一件事:抽子样本人工数一遍,与检测值对拍。没有这一步,后面全是信仰。
地理定位:重加权不是可选项
面板、人口加权外推、POI 周度到访。ATT 之后面板更小,外推模型更深,偏差更隐蔽。
下面这个动图是实验 1 的动态版:面板每个月在换人,朴素口径的偏差在复利。
▲ 蓝线是真实总体人均,红线是面板人均(朴素),青线是分群重加权。红线偏离蓝线的速度,就是构成偏差的复利速度。
静态版本把三种口径并排:面板人均 4 年累计偏 -6.1pp;分群人均加按总体结构重加权后偏 -0.2pp。人均化不够,重加权才够。
音频:电话会是最被低估的模态
ASR、说话人分离、语气与问答抽取。失败模式很具体:ASR 把「basis points」听成别的、把数字听错一位;管理层话术逐年漂移;反讽与回避——「we're pleased」后面跟一个下调的指引。
评估靠跨 ASR 引擎一致性加人工标注子样本。单引擎的输出不是数据,是假设。
网页抓取:漂移监控比解析器重要
快照哈希、schema 映射、漂移监控。解析器写得再好,页面一改版就是垃圾进垃圾出——而且垃圾会安静地流进你的面板。
▲ 批次 32 页面改版,空值率从 2% 跳到 60%,监控击穿阈值、管线 halted。没有这条监控线,改版日的垃圾会以「真实数据」的身份活在你的回测里。
而厂商送来的文件,本身就是需要解剖的对象。
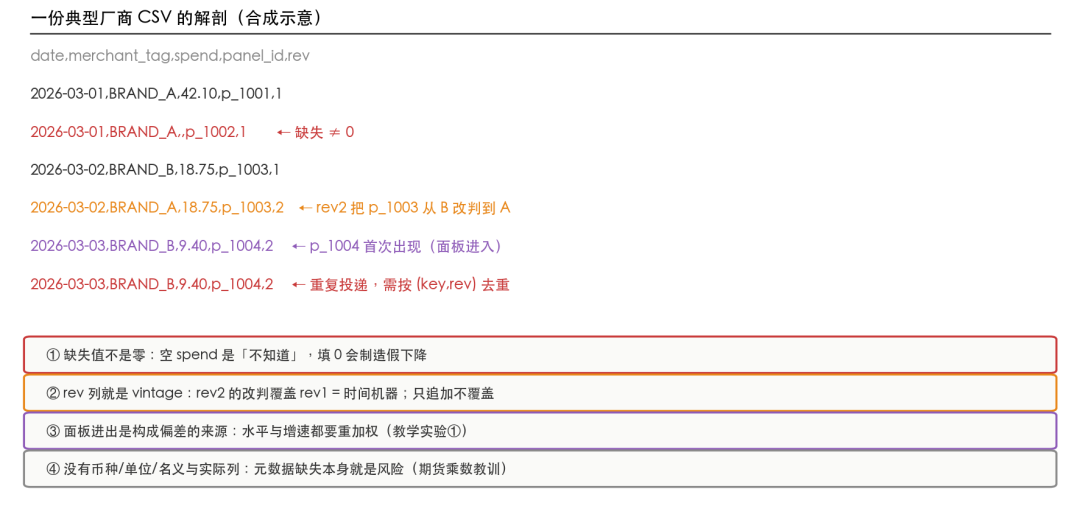
▲ 缺失不等于 0;rev 列就是 vintage;面板进出是构成偏差;没有币种单位列就是元数据风险——期货乘数的教训。
加工的公共骨架
六种模态摊开之后,公共骨架只有四条。
每行带 vintage 与 source_span。 没有出处的行不是数据。
数据管道是代码。 Mannes 的原话:data pipelines are code。要 code review、要测试、要版本控制。Jane Street 用 dbt 的原因很具体:在每一阶段测试数据的性质,这样你才敢依赖它——而不是 300 行的 Postgres view。
监控先于模型。 空值率、漂移告警、面板构成仪表盘、vendor 变更通知。模型发现问题太晚,监控发现问题在当天。
评估留在确定性层。 字段级精确匹配、与 XBRL 勾稽、与普查对拍、人工审计子样本。LLM 可以生产行,但不能验收行。
06|稀缺:一门会折旧的生意
先看价格。行业报道给出的年费区间,从窄数据集的 0.5–2.5 万美元,到中位的 5–10 万,到 premium 的 10–50 万,再到机构级安排的 50–250 万。
Neudata 2026 年报告估计:平均买方年支出约 160 万美元、覆盖约 20 家 vendor;2025 年买方总支出 28 亿美元,同比加 17%;2026 年调查里 94% 的买方声称在用。
独家授权的溢价倍数传闻是 3 到 10 倍。没有核实来源,本文只作传闻引用。
再看折旧。独家的意义,在于折旧速度。三块学术拼图:
Katona 与 Painter 说,另类数据加快信息入价——它的使用本身在消灭它。
INSEAD 的工作论文说,价值随信息吸收衰减,且主要作用于短期。
Lee 给出双曲线衰减的形式,并发现「机械型」因子拥挤快、「判断型」因子慢。
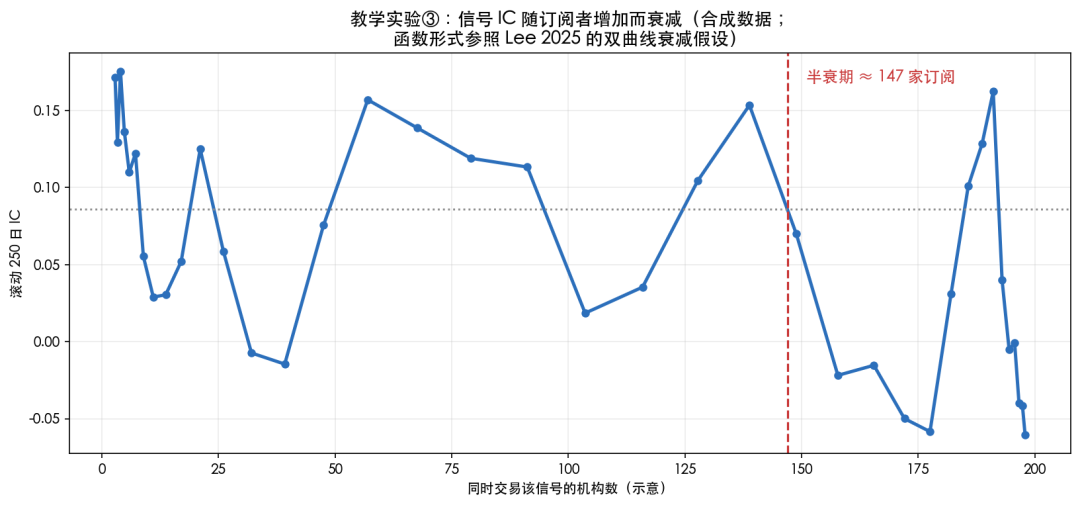
▲ 合成演示,函数形式参照 Lee 2025:滚动 IC 从 0.17 衰减,半衰期约在 147 家机构同时交易处。动图把订阅者计数变成时间轴——IC 的下滑,就是这门生意的折旧表。
反证据也存在:Acadian 的拥挤度重估认为,多数系统化策略的拥挤担忧被夸大。
最后是监管。监管即稀缺性。
ATT 的 35% opt-in、Kochava 禁售令、Avast 罚单、GDPR——每一刀砍掉一类可买的数据,同时抬高合规存续数据的价格。
而 vendor 的死亡率本身就是风险:Second Measure 被收购、SafeGraph 拆分客流业务、1010data 并入 SymphonyAI、Unacast 与 Gravy 合并。
把 alpha 押在一家 vendor 的存续上,是一种未定价的风险。
07|前沿:机构怎么组织,多 agent 怎么跑,评估怎么崩
Jane Street 的两层回答
第一层:模型变强,好数据更值钱。
更强的模型消耗数据的能力更强,「所有高质量数据集的价值都上升了」。LLM 让文本提取从「手动、烦人、不现实、一堆正则的嵌套」变成可行。
但他立刻给出因果警告:
「LLM 知道 Enron 怎么了。」
用一个读过未来的模型处理旧数据,会得到非常混乱的结果——训练语料里可能就有那份财报的结局。这是时间机器的 AI 版本。 第 05 部分的泄漏门,就是这句话的工程化。
第二层:验证瓶颈更值钱了。
「很容易做一件事并且以为自己解决了问题,而实际上你根本没理解问题。」
还有一个反直觉的观察:模型越强,清洗的价值越大。非 point-in-time 数据里偷渡的未来信息,弱模型学不会,强模型一学一个准。
顶级机构怎么组织加工
Jane Street。 团队三分:数据战略(sourcing,社交型——订阅目录、vendor 大会、10 到 15 分钟一场的高速约会式面谈)、数据基础设施(工具)、数据工程(产品是「好数据集」,必须懂域)。起源很朴素:组建团队前各桌自己接数据,「结果大概只有它能达到的水平的 60%」;先做一个小而难的数据集做到好用,诱导需求——2023 年第一位数据工程师,如今二十多位。
Citadel。 设有专职另类数据团队,Ken Griffin 的公开表述是「有效利用大数据的能力对我们的成功至关重要」。具体预算不披露。
Point72。 2016 年起由 Matthew Granade 执掌大数据部门,内设 Market Intelligence 专职 sourcing;2025 年 3 月,前 Point72 高管 Kirk McKeown 创办 Carbon Arc,宣称要重做另类数据供应链——连退出者都认为这条链值得重做一遍。
Two Sigma 与 D.E. Shaw。 自建抓取与文档处理基础设施的报道广泛存在但多为间接证据;D.E. Shaw 的文档处理研究组有公开技术 talk。本文标注为部分核实。
共同点只有一条:sourcing 是社交工作,加工是工程工作,验收是纪律工作。三件事分开做。
2026 年的系统图谱
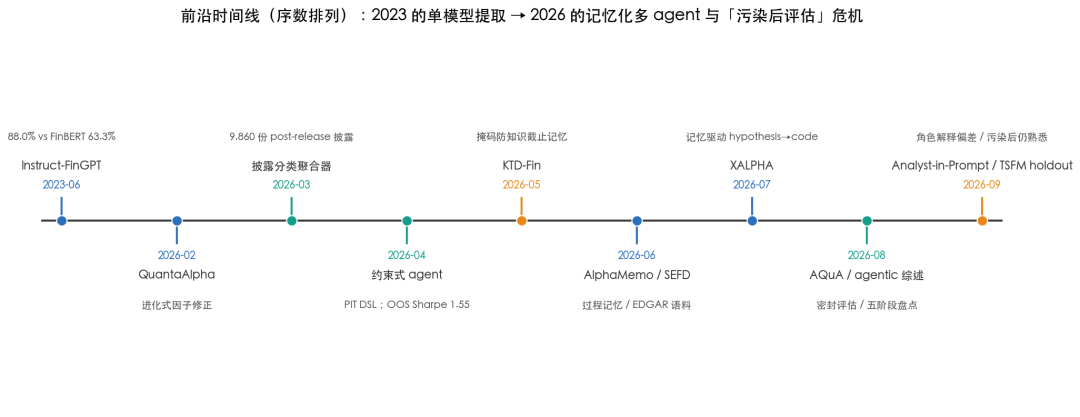
三年间的主线:从「单模型提取」,走到「记忆化多 agent 加污染后评估危机」。逐条给证据。
披露分类聚合器。 3 个零样本 LLM 视角加 logistic 元分类器,预测次日收益方向;9,860 份 post-release 披露,刻意规避预训练污染。
约束式 agent。 append-only 实验轨迹、point-in-time 因子 DSL、确定性引擎;仅训 2020–22,2024–26 纯样本外年化 44.55%、Sharpe 1.55(加密市场,5bps 成本后)。
KTD-Fin。 数据侧掩码,匿名化 ticker 与日历,防知识截止记忆顶替推理;并指出原始收益不等于选股能力。
AlphaMemo 与 SEFD。 结构化搜索过程记忆;斯坦福把 EDGAR 重建为 layout-faithful 语料,与 Common Crawl 系重叠小于 0.1%——清洗后的披露本身就是稀缺训练资产。
XALPHA。 记忆驱动的 hypothesis-to-code 闭环研究员。
AQuA。 评估器密封:生成泄漏靠「写不出来」堵,选择泄漏靠「优化指标不等于上报指标」堵;因子组合 IC 0.190 对单因子 0.026–0.037。本系列前作拆过它。
Agentic 综述。 系统集中于信号发现;多 agent 仍重度依赖聚合;强预测能力不自动变成交易表现。
多 agent 的正确形态
把上述系统的共性抽出来,命题只有一句:
让 LLM 待在它擅长的层——提取、假设、草稿。把纪律留在确定性层。
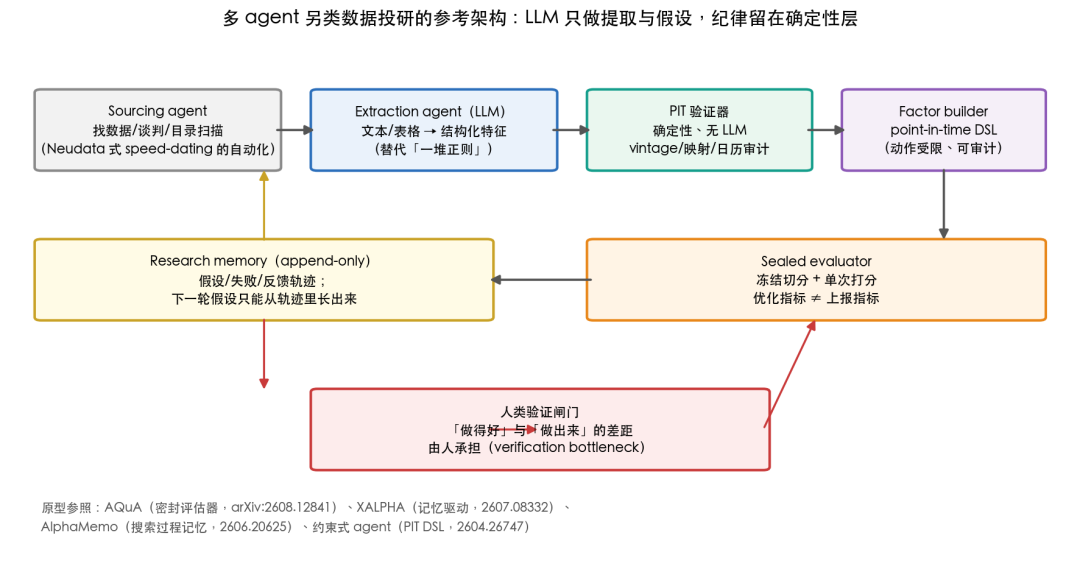
▲ PIT 验证器里没有任何 LLM;factor builder 的动作被限制在 point-in-time DSL 内;评估器冻结切分、单次打分、优化指标与上报指标分离;记忆只追加不修改;人类闸门承担「做得好」与「做出来」的差距。
反面教材很清楚:奖励黑客研究显示,agent 会在可见测试集上刷满分、在 holdout 上作弊。
密封评估不是可选项。
2026 年 9 月:评估危机
两篇最新预印本,把「LLM 金融评测」的地基掀了开来。
其一,构造了全部观测晚于所有模型发布日的 holdout:预训练时序基础模型赢下 7 组中的 5 组、输 1 组给 Theta 基线;而在日频汇率上,与季节朴素预测无任何方法可区分。此前文献的强分数,无法与「预训练见过测试集」分离。
其二,在 3,575 份 SEC 文件、12 个 LLM 上发现:角色提示、记忆、画像造成的判断偏移,主要来自模型对同一证据的解释方式,而非检索到不同证据。给「agent 一个买方角色」这类设计,这是直接警告。
叠加已知负结果——表格数字幻觉、前瞻偏差(它否掉了一批已发表的「LLM 炒股」论文)、对抗扰动下 97.2% 到 71.0% 的崩塌、过半 NLP 基准被污染——2026 年的结论是:
「干净分数」本身,成了需要被审计的对象。
顺带一句:我们在实验 9 里亲眼见到幻觉研究的一面——LLM 的表格数字这次是对的,错的是人。
08|建模:三条定律,和一条元定律
第一定律,horizon 决定持仓。 有研究发现另类数据主要对未来短期结果有信息,IC 在 5 到 10 天外急剧下降;加入长窗口预测,甚至可能降低信息量。
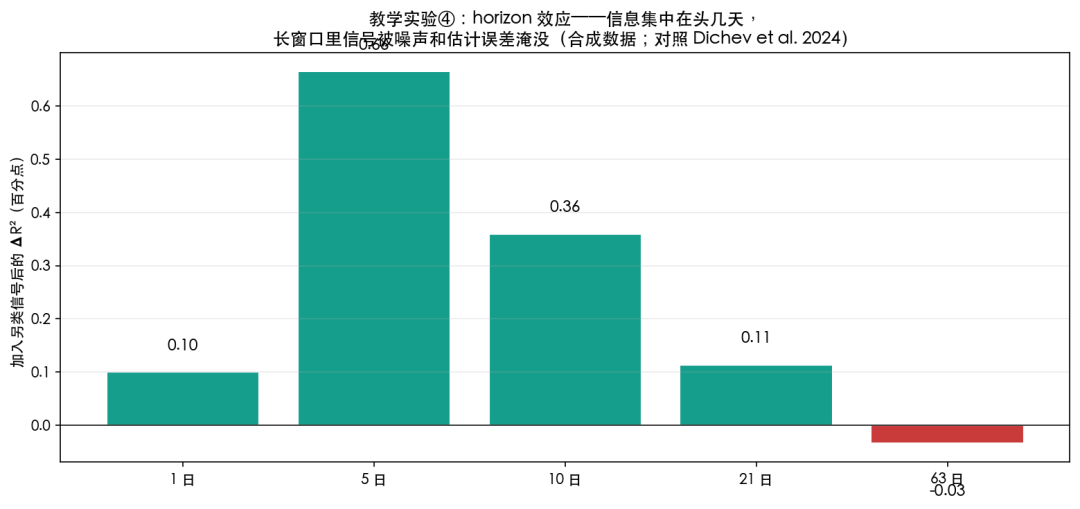
▲ 合成演示,40 种子平均:ΔR² 在 5 日见顶(加 0.67pp),21 日只剩加 0.11pp,63 日转负。另类信号的持仓周期由数据性质决定,不由偏好决定。
第二定律,增量必须正交。 加值的地方:低分析师覆盖、高信息不对称的标的;事件前 1 到 5 天。不加值的地方:大市值高覆盖;以及——控制已知因子之后。
447 个异象的复现、和金融学复现危机的那篇,给出背景噪声水平:多数「新因子」在正确断点与因子控制下消失。批评者的版本更刺耳:卡面板收入约等于盈利动量,客流约等于规模加动量。
不正交化就报增量 IC,等于没报。
第三定律,显著性必须折试验次数。
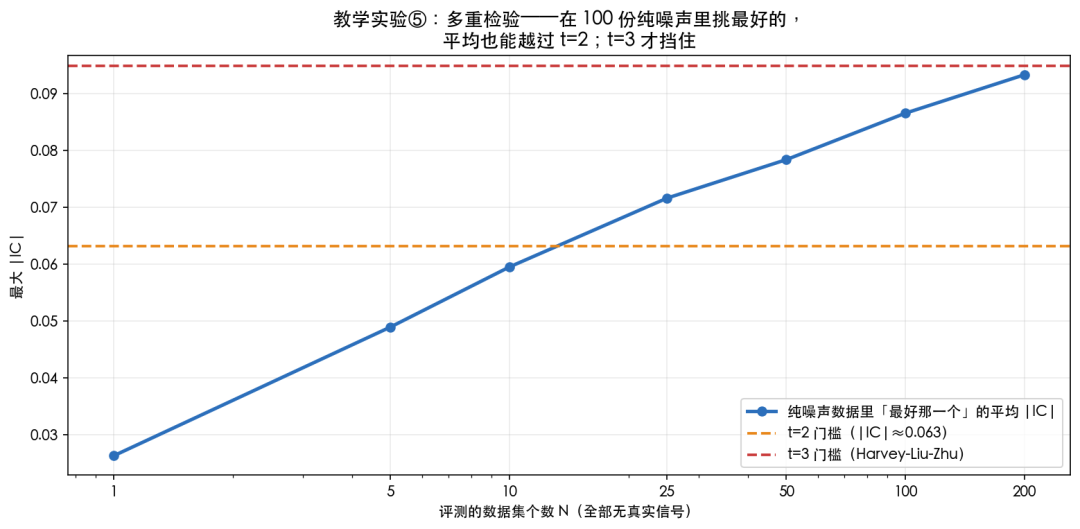
▲ 合成演示:1000 天纯噪声里测 100 份数据集、挑最好那份,平均 abs(IC) 0.087——越过 t=2 门槛(0.063),过不了 t=3 门槛(0.095)。Deflated Sharpe Ratio 是同一件事的组合版本:报告 Sharpe 2.5,计入试验次数后可能折成 0.3。
元定律,归因不存在。 没有任何公开的信、访谈或论文,给出经审计的「另类数据贡献了 X% 收益」。Two Sigma、Point72、Citadel、Renaissance 的另类数据使用,都是推断与招聘信号。任何 fund-level 归因数字,都应视为营销。
09|手册:七道 Gate
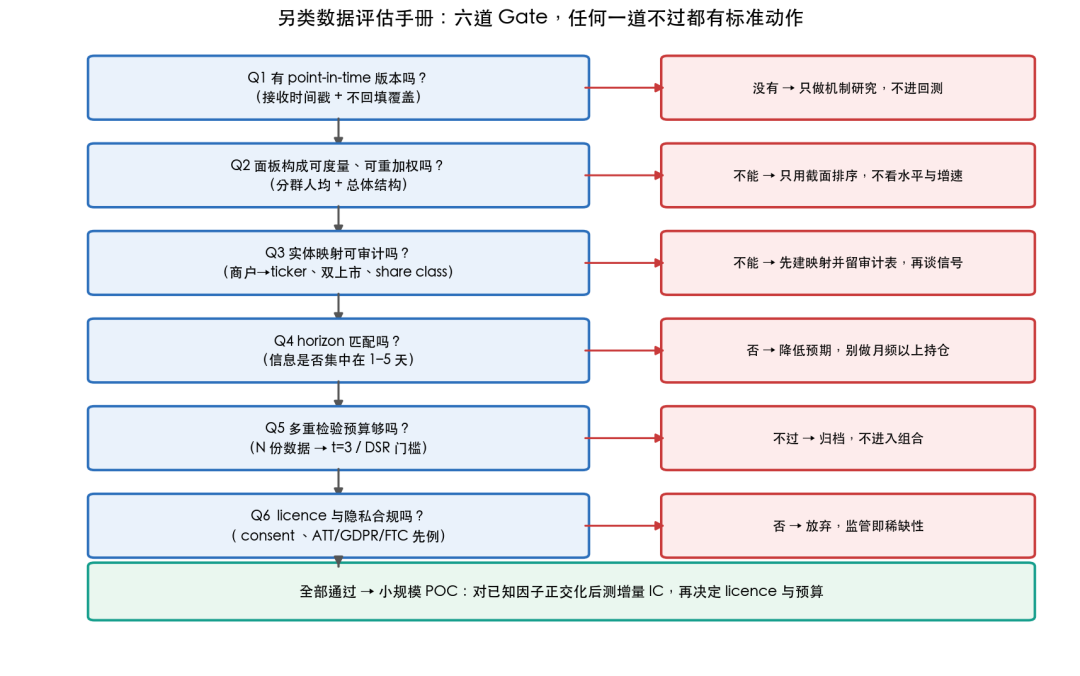
▲ 六道 Gate,每道不过都有标准动作:不进回测、只用截面、先建映射留审计表、降预期、归档、放弃。第七道是 2026 年新增的:LLM 与 agent 环节是否有密封评估与 append-only 轨迹?没有,其产出只配当草稿。
组织侧,三条 Jane Street 经验。
先做小而难的一份数据。 把一个基础但难用的数据集做到好用,需求自己会长出来。2023 年第一位数据工程师,如今二十多位。
团队三分。 数据战略、数据基础设施、数据工程。后者的产品是「好数据集」,且必须懂域。
招聘看好奇心与调查过程。 面试给一份陌生数据集,看候选人是小心建模「我知道什么、不知道什么、怎么验证」——还是写一堆代码然后「希望它能跑」。
结尾:拒绝权
回到标题。
把世界拧进行里,拧的不是世界,是「当时可知」四个字。
卫星照片、卡面板、停车场、电话会文本、LLM 提取的结构化字段——它们共同的敌人不是噪声,是时间:
面板在时间上换人。厂商在时间上改标签。53 周在时间上偷天数。披露在时间上迟到。页面在时间上改版。LLM 在时间上读过未来。订阅者在时间上套利掉信号。预训练在时间上见过你的 holdout。
所以顶级机构真正买到的不是数据。
是对时间机器的拒绝权。
自有时戳、vintage 只追加、purged 验证、t=3 门槛、PIT DSL、密封评估、post-release 样本、实体限定的 schema。
付得起这套纪律,另类数据是 alpha 的原料。付不起,它只是噪声的另一种包装——外加一张六位数的发票。
最后留一个问题:
它在它所声称的每一个历史时点上,真的存在过吗?
泼自己九盆冷水
一,实验 1 到 6 为合成数据,只演示机制;实验 7、8、9 为真实数据,但 8 和 9 的 LLM 是本文环境所接模型(qwen3.8-max),非 frontier 模型,结论只读方向。
二,实验 9 是单文档基准:8 个字段、三种方法,证明的是实体限定的必要性,不是任何方法的总体准确率。
三,fund-level 归因不存在公开证据;独家溢价倍数为业界传闻;市场规模远期预测差两个数量级,本文只采用 2025 年实际支出(28 亿美元)。
四,EDGAR 实验里最老期间的「首次出现」是后续 10-K 的比较期——数据库保留窗口本身会伪造 vintage,这也是一条教训。
五,实验 8 的 4 个 LLM 分歧是标注语义分歧,不应读作模型能力上限;16 句样本太小,不估总体准确率。
六,Two Sigma 与 D.E. Shaw 的自建基础设施为部分核实(间接报道与技术 talk),未获一手确认。
七,卫星族除顶刊锚点外,「R² 0.3 到 0.5」式数字多为 vendor 口径。
八,2023 到 2024 年「LLM 炒股」论文先查时间戳处理;2026 年之前的时序基础模型分数先查 holdout 是否在模型发布之后。
九,回测非实盘;合成实验非回测;真实数据实验非收益证据。三层不互相替代。
动手区:三段可跑代码
import json, urllib.request, datetime as dt, collections

class VintageStore:                      # 只追加、不覆盖
    def __init__(self): self.v = []
    def deliver(self, recv_ts, df): self.v.append((recv_ts, df))
    def as_of(self, ts):
        vis = [d for r, d in self.v if r <= ts]
        return vis[-1] if vis else None # 当时可知版本,永不来自未来

def edgar_vintages(cik, tag="RevenueFromContractWithCustomerExcludingAssessedTax"):
    """从 data.sec.gov 构建真实 PIT 面板:每条事实带 (filed, form, period)。"""
    ua = {"User-Agent": "research demo contact@example.com"}
    u = f"https://data.sec.gov/api/xbrl/companyconcept/CIK{cik:010d}/us-gaap/{tag}.json"
    recs = json.loads(urllib.request.urlopen(
        urllib.request.Request(u, headers=ua), timeout=60).read())["units"]["USD"]
    panel = collections.defaultdict(dict)          # period -> {filed: (val, days, fp)}
    for r in recs:
        if r.get("form") in ("10-K", "10-K/A", "10-Q"):
            L = (dt.date.fromisoformat(r["end"]) - dt.date.fromisoformat(r["start"])).days
            # 注意:period 的 start 与 end 必须一起进 schema(3 个月 vs 6 个月并存)
            panel[(r["start"], r["end"])][r["filed"]] = (r["val"], L, r.get("fp"))
    return panel

def growth_as_of(panel, as_of):                    # as-of 增速:只用已披露年份
    kn = sorted(e for e in panel if min(panel[e]) <= as_of)
    get = lambda e: panel[e][max(f for f in panel[e] if f <= as_of)]
    vals = [get(e)[0] for e in kn]; lens = [get(e)[1] for e in kn]
    return [(vals[i]/lens[i])/(vals[i-1]/lens[i-1])-1 for i in range(1, len(vals))]

def panel_reweight(panel, seg_col, val_col, pop_share):
    """实验 1 的可跑版:分群人均 + 按总体结构重加权,回到总体水平。"""
    levels = panel.groupby(seg_col)[val_col].mean()
    return float(sum(levels[g] * w for g, w in pop_share.items()))

def drift_monitor(null_rates, threshold=0.2, window=5):
    """动图 6 的可跑版:空值率滑动窗口击穿阈值即 halted。"""
    for i in range(window, len(null_rates)):
        if sum(null_rates[i-window:i]) / window > threshold:
            return i
    return None
# 回测一律 growth_as_of(panel, 决策日);对齐财年末 = 偷看未来。
# 抽取时:schema 必须实体限定;每行带 vintage 与 source_span;
# 模型 cutoff 晚于文档期间 → 拒绝入库(泄漏门)。
 发表于 前天 00:21
|
查看: 0|
回复: 0


