高效的 GPU 张量程序实现往往需要高层代数表达与底层执行策略的联合优化。这是论文作者点明的核心判断,也戳中了当前张量编译领域的核心痛点。随着算子间变换组合不断叠加,优化搜索空间呈爆炸式增长,代数重写与执行优化分层处理的模式,很难支撑跨层级的联合优化规模化落地。
关键词:相等饱和、张量程序编译、EqiForge、算子融合、GPU 内核优化
本研究提出的 EqiForge,是一款基于相等饱和技术的张量程序超优化器。它通过统一的中间表示,将高层张量表达式与分块计算纳入同一套表达体系,依靠可组合的相等规则,直接从张量表达式推导出 FlashAttention 风格的融合内核实现。同时通过早期压缩技术在候选程序构建完成前剪枝冗余分支,结合子图组合策略将搜索能力扩展到更大规模的计算图。
实验结果显示,在各类张量程序基准测试中,EqiForge 相对于各配置下的最快基线,取得了 1.32 倍的几何平均加速比,最高加速可达 2.74 倍。
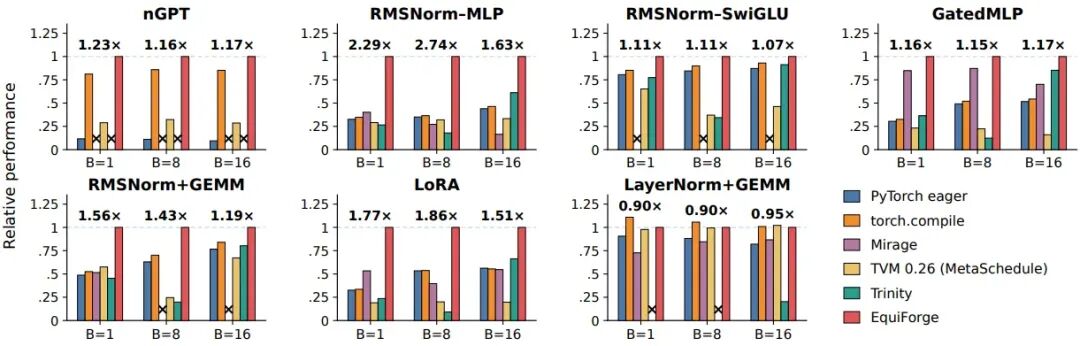
图 7:多样张量程序的性能(以 EquiForge 为基准归一化)。数值越高性能越好,标签显示相对于最快有效基线的几何平均加速比。× 表示搜索超时或数值无效结果。该图对比了 EquiForge 与 PyTorch、TVM、Mirage、Trinity 等基线在归一化、MLP、LoRA、注意力等多种张量程序上的性能。结果显示 EquiForge 在 21 种配置中的 18 种上超越了最快基线,几何平均加速比达 1.32 倍,最高在 RMSNorm-MLP 场景下达到 2.74 倍。
其生成的注意力内核,在解码阶段最高比 FlashAttention 快 1.87 倍,预填充阶段性能接近 FlashAttention 水平。
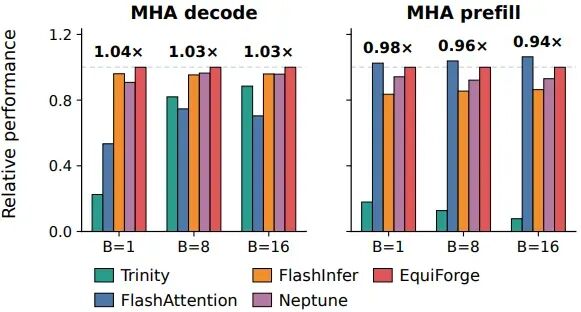
图 8:多头注意力在解码与预填充阶段的性能(以 EquiForge 为基准归一化)。解码阶段 EquiForge 全面超越所有基线,最高加速比达 1.87 倍;预填充阶段与 FlashAttention 性能接近,仅有 3%-6% 的差距。
在多种 Transformer 层的优化中,EqiForge 发现的新实现大幅超越 torch.compile,其中 QK 归一化 MLA 加速 3.16 倍,mHC 加速更是达到 5.84 倍。
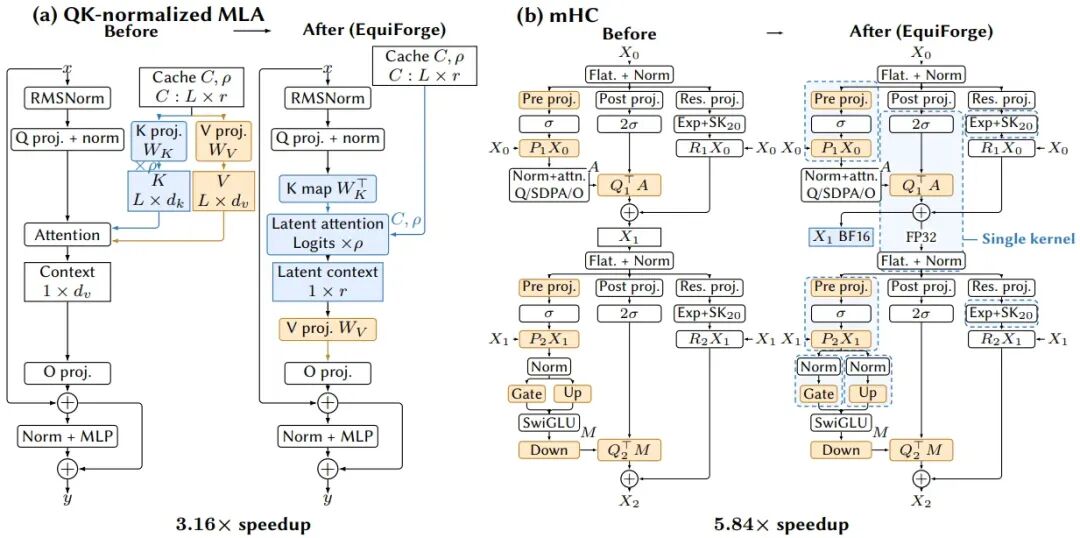
图 9:EquiForge 发现的层结构:(a) QK 归一化多头潜注意力,(b) 流形约束超连接层。每个蓝色虚线框包围一个内核。SK₂₀ 表示 20 次 Sinkhorn 迭代。两个案例分别实现了 3.16 倍与 5.84 倍的加速。
这项工作的核心洞察在于,将代数重构与执行优化放到同一个相等饱和搜索空间中,通过类型化统一 IR、可组合规则体系、早期压缩三大设计,既保留了联合优化的完整机会,又有效控制了搜索复杂度,为张量编译的超优化落地提供了完整可行的技术路径。
本文目录
- 一、张量编译的核心困境:代数与执行的断层
- 二、EqiForge 整体架构:相等饱和的全流程设计
- 三、统一 IR:打通代数与执行的表达基础
- 3.1 核心语法设计
- 3.2 并行状态的类型化表达
- 3.3 中间存储的灵活表达
- 四、相等规则体系:构建可组合的优化空间
- 4.1 并行细化规则:从算子到分块
- 4.2 归约融合规则:独立与依赖的统一处理
- 4.3 并行传播规则:自动打通算子边界
- 4.4 规则的组合能力:自动生成 FlashAttention
- 五、可扩展的程序提取:从搜索空间到最优实现
- 5.1 早期压缩:提前剪枝冗余候选
- 5.2 子图组合:面向大图的分治搜索
- 5.3 代码生成与渐进调优
- 六、实验评估:全场景性能验证与案例分析
- 6.1 基准测试整体表现
- 6.2 Attention 算子专项对比
- 6.3 Transformer 层深度优化案例
- 6.4 搜索开销分析
- 七、总结与行业启示
一、张量编译的核心困境:代数与执行的断层
1.1 联合优化的必要性
大语言模型的训练与推理高度依赖 GPU 的高效执行,张量编译器是连接高层计算描述与底层硬件执行的核心桥梁。
传统张量编译的优化通常分为上下两层:上层负责代数重写、算子融合等图级优化,下层负责分块、调度、并行化等执行级优化。两层之间大多是串行割裂的关系——先固定代数形式,再做执行优化,执行层面的约束很难反向反馈到上层的代数选择。
FlashAttention 的出现就很能说明问题。它的核心性能来源,是把 softmax 的在线代数重写,与注意力两个矩阵乘法的分块执行结合起来,在一个融合内核内完成增量计算,全程不需要把完整的分数矩阵和概率矩阵写入全局显存。这种跨代数与执行两层的深度优化,靠传统分层编译很难自动发现,它需要同时改变数学公式的表达形式和底层的执行策略,而两层优化之间的断层,会直接错过这类最优解。
同等数值结果的张量计算,可以对应无数种等价的实现形式,不同实现的性能差距可能达到数倍。想要找到最优实现,就必须把代数形式和执行策略放在同一个空间里联合搜索,而不是分层串行处理。
1.2 现有方案的局限
过去的研究分别在代数重写和执行优化两个方向都有大量积累,但两者的深度结合始终存在障碍。
- 一部分工作聚焦代数层面,比如 TASO 用自动生成的等价替换优化张量图,TENSAT 和 SPORES 用相等饱和做张量表达式优化,但它们都不深入单个算子的底层 GPU 实现细节。
- 另一部分工作聚焦执行层面,比如 TVM、TensorIR 做调度优化,Mirage、Prism 做枚举式超优化,但代数变换的空间相对有限。
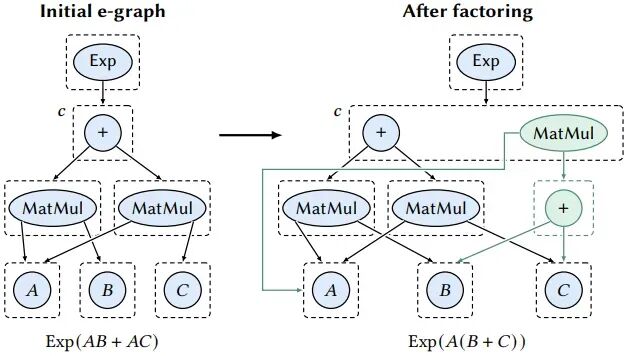
图 2:e-graph 中 AB + AC 的因式分解示例。虚线框表示等价类(e-class),实心节点表示等价节点(e-node)。初始 e-graph 中加法等价类包含两个矩阵乘法节点,应用提取公因子规则后,新增 A(B+C) 的矩阵乘法节点,而外层 Exp 节点始终指向同一个等价类,无需重复构建。
相等饱和技术本身很适合做联合搜索,它用 e-graph 紧凑存储所有等价表达式,重写规则可以自由组合,不断暴露出新的优化机会。但当搜索空间从纯代数扩展到执行层面,候选程序的数量会指数级增长,构建和评估所有完整候选的成本会高到不可接受。如果为了降本而限制每次搜索的范围,又会把本来可以联合优化的操作拆开,反而损失优化机会。
Trinity 是和本工作最接近的方案,它在分块级 IR 上用相等饱和探索循环和内存变换,但它按内核数量选择循环结构,很容易错过更优的组合。
归根结底,现有方案都没有很好解决"如何让相等饱和同时覆盖代数与执行优化,同时控制搜索成本、支持大规模程序"这个核心问题,这也是 EqiForge 要解决的核心目标。
二、EqiForge 整体架构:相等饱和的全流程设计
2.1 端到端工作流
EqiForge 是一个完整的端到端张量程序超优化器,输入是 PyTorch 程序,输出是优化后的 Triton 内核,全程围绕相等饱和技术构建搜索与提取流程。
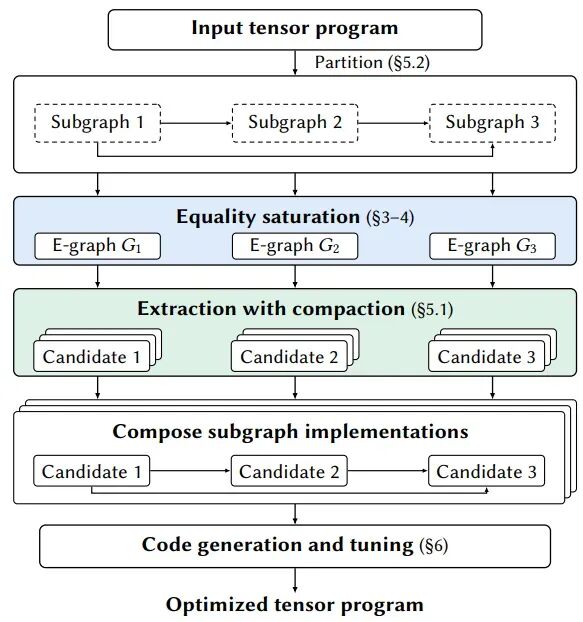
图 1:EquiForge 整体架构概述。输入张量程序先经图分区拆分为多个子图,每个子图通过等式饱和与带压缩的提取生成候选实现,再通过子图实现组合拼接为完整程序,最终经代码生成与调优输出优化后的张量程序。
整个工作流分为四个核心阶段:输入图划分、子图相等饱和与压缩提取、子图实现组合、代码生成与调度调优,整体采用分治加组合的思路平衡优化深度与搜索成本。
- 首先将输入的张量程序划分为多个子图,每个子图独立进行相等饱和搜索,生成对应的 e-graph;
- 然后对每个 e-graph 做带早期压缩的提取,得到若干代表性的候选实现;
- 接着将不同子图的候选实现组合成完整的程序;
- 最后对完整程序做代码生成和渐进式调度调优,输出最终的优化内核。
这种分治思路的好处是,每个子图内部可以做充分的联合优化,不会因为图太大而直接爆炸;同时子图之间通过接口组合,又能保留跨子图的优化可能性,在成本和收益之间取得平衡。
2.2 三大核心设计支柱
EqiForge 的设计围绕三个核心支柱展开,分别对应搜索空间定义、搜索过程执行、搜索空间压缩三个核心环节。这三个设计环环相扣,共同解决了相等饱和在张量编译中落地的核心痛点。
| 核心设计 |
描述 |
特点 |
| 定义空间 |
纯表达式语言的统一 IR,可以同时表达高层张量表达式和底层分块计算。两种形式共存于同一个 e-graph 中,子表达式可以执行层面细化,其余部分依然做代数重写。IR 的类型系统追踪逻辑张量形状和并行状态,从语法层面约束分块计算的构建与组合方式。 |
统一 IR、e-graph 共存、类型系统约束形状与并行状态 |
| 搜索空间 |
可组合的相等规则体系,覆盖张量表达式变换和执行实现变换。并行细化规则在单个算子上引入分块,融合规则合并共享域上的归约操作,传播规则把分块结构扩展到相连的操作。规则可自由组合,最终生成复杂的融合实现。 |
可组合规则、覆盖表达式与实现、支持 FlashAttention 风格推导 |
| 压缩空间 |
早期压缩技术,在候选程序构建完整之前就识别并剪掉等价分支,只保留一个代表继续展开,避免冗余的完整候选构建,大幅降低提取成本。 |
早期识别等价分支、剪枝保留代表、降低提取成本 |
EqiForge 的本质是用相等饱和统一代数与执行优化的搜索空间,用统一 IR 保证规则可组合性,用早期压缩控制搜索复杂度,最终实现自动化、规模化的张量程序超优化。
三、统一 IR:打通代数与执行的表达基础
3.1 核心语法设计
EqiForge 选择了纯表达式语言,同时描述张量计算本身和它们的并行实现。纯表达式的设计天然适配相等饱和的重写模式,所有变换都可以通过等式替换完成,不需要处理副作用和控制流的复杂情况,规则的定义和组合都更简洁。
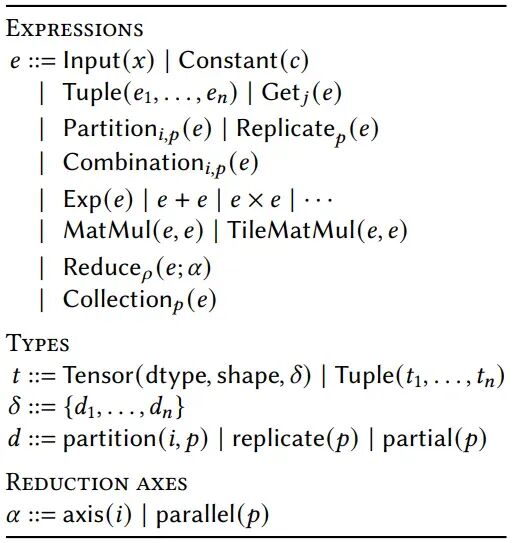
图 3:核心表达式与并行状态类型。表达式层同时包含高层张量算子(MatMul、逐点运算)与分块并行原语(Partition、Replicate、Reduce 等),支持两种抽象层级的表达式在同一 e-graph 中共存;类型系统通过并行状态 δ 区分分区、复制、部分结果三种分块状态。
这套 IR 的核心特点是同构设计:高层张量运算和底层分块运算共用同一套语法框架,只是算子不同。比如 MatMul 代表高层的矩阵乘法运算,支持结合律等代数重写;TileMatMul 代表分块层面的局部矩阵乘法,对应实际的硬件计算。两者都可以和 Exp、加减乘除等逐点算子自由组合,不需要切换表达体系。
除了常规的张量算子,IR 还包含了定义并行操作数视图、表达归约、存储中间结果的原语,完整覆盖并行计算的各种模式。
3.2 并行状态的类型化表达
并行状态是这套 IR 最关键的设计之一,它描述了张量表达式如何被逻辑并行轴上的各个计算单元拆分、复制或归约。
类型系统把并行状态直接编码进张量类型里,这样即使两个张量的逻辑形状和数据类型完全一致,只要并行状态不同,就属于不同的类型,不能随意混用,从语法层面就避免了非法的分块组合。
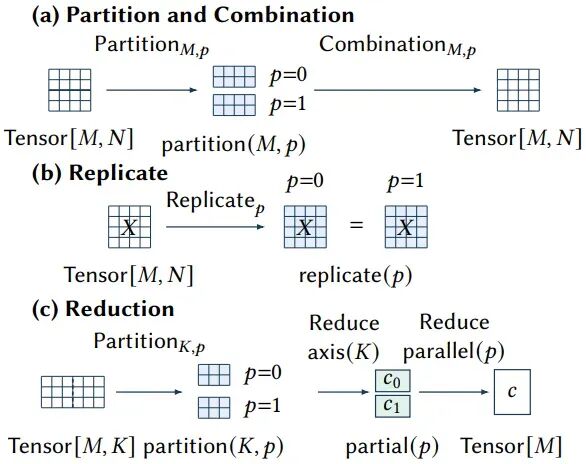
图 4:并行转换:(a) 分区与组合,(b) 复制,(c) 归约。三类原语通过类型系统中的并行状态统一管理,所有转换都保持计算等价性,使得等式饱和可以在分块与非分块形式之间自由切换。
就好比一个 M 行 K 列的张量,沿 K 维度切成多块,每个块里单独做行求和,得到的就是部分行和;再把所有块的部分行和加起来,就是完整的行和。这个过程在 IR 里可以精确表达,类型系统会保证每一步的并行状态都是合法的。
3.3 中间存储的灵活表达
融合内核可以避免中间结果写回全局显存,减少访存开销,但有时候把中间结果存下来反而能获得更高的并行度,典型场景就是小批量解码。EqiForge 引入了 Collection 原语来表达这个选择,把并行轴转换成一个张量维度,每个并行坐标的结果变成张量的一行,中间结果就可以存到全局显存,后面再用另一个内核做最终归约。
这个设计的核心价值在于,把"是否做内核融合"变成了相等搜索空间里的一个普通可选选项,编译器可以自动比较融合和非融合两种方案的实际性能,选择更优的那个,不需要人工预设必须融合或者必须拆分。
- 对于融合内核输出块很少、并行度不足的场景,自动拆分可以换取更高的并行度;
- 对于访存敏感的场景,自动选择融合减少显存访问。
上述两种方案都在同一个搜索空间里,由相等规则自然生成。
四、相等规则体系:构建可组合的优化空间
有了统一 IR 作为表达基础,下一步就是定义相等规则,让不同的等价形式可以在 e-graph 里自由生成、互相组合。
EqiForge 一共实现了 120 条重写规则,分为六大类:21 条代数规则、10 条并行细化规则、73 条传播规则、9 条归约融合规则、6 条结构规则和 1 条中间存储规则。
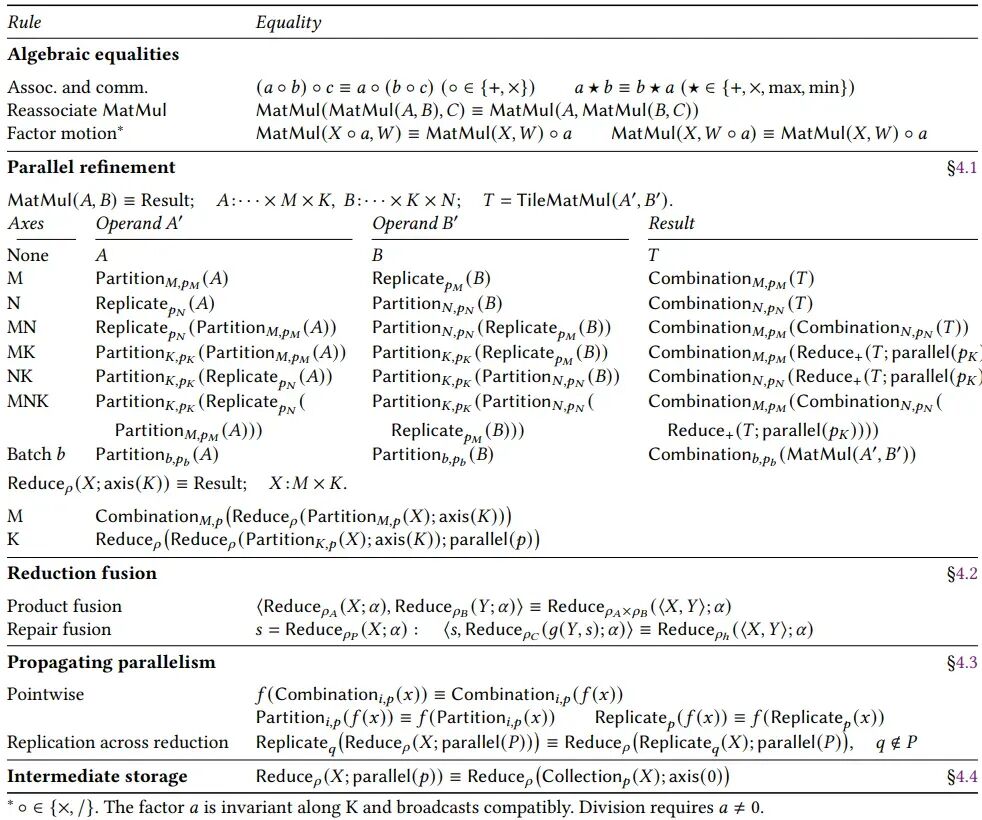
表 1:张量程序的核心等式规则。代数规则包含结合律、交换律、矩阵乘法重结合与因子移动;并行细化规则定义了矩阵乘法与归约在不同维度分块下的等价形式;归约融合区分独立归约的乘积融合与依赖归约的修复融合;传播规则实现分块状态在逐点、归约操作中的传递。
这张表是整个 EqiForge 的规则骨架,每一条规则都是一个基础的等价变换,它们可以任意组合、叠加应用,最终生成海量的等价实现。下面拆解最核心的几类规则。
4.1 并行细化规则:从算子到分块
并行细化规则的作用,是把高层的张量算子,转换成等价的分块计算形式,加上对应的分块、复制、组合操作。
以矩阵乘法 MatMul 为例,根据切分维度的不同,对应不同的细化形式,包括切分 M、切分 N、切分 K、多维度组合切分、Batch 维度切分等。
比如切分 M 维度:左矩阵 A 按 M 维度分块,右矩阵 B 复制到所有并行坐标,每个块内做 TileMatMul,最后把结果沿 M 维度组合起来。切分 K 维度的话,每个块计算部分积,最后用加法归约合并所有块的结果。
这些规则可以多层组合复用。比如同时切分 M 和 K,就会得到二维分块的矩阵乘法实现。Batch 维度的细化还可以和 M/N/K 的细化叠加,支持更复杂的多级并行策略。
归约操作也有对应的细化规则:可以沿输出维度分块,每个块得到完整的归约结果,最后组合;也可以沿归约维度分块,每个块得到部分结果,最后并行归约合并。后者要求归约函数满足结合律,初始值为单位元(比如求和的单位元是 0,求最大值的单位元是负无穷)。
4.2 归约融合规则:独立与依赖的统一处理
多个归约如果在同一个维度上执行,能不能合并成一个归约?这是算子融合里的核心问题,具体分为独立归约和依赖归约两种情况。
- 独立归约就是两个归约互相不依赖,各自计算各自的结果,这种可以直接合并成一个元组状态的归约,一次遍历输入就把两个结果都算出来。
- 更复杂的是依赖归约:一个归约的结果,是另一个归约的输入。 比如 softmax 计算中,先求最大值,再用最大值去算指数和,第二个归约的计算依赖第一个归约的结果。这种情况不能直接合并,需要引入修复函数。
EqiForge 把 Neptune 提出的修复方法表达成了一条通用的相等规则:当生产者归约的状态变化时,用修复函数调整消费者已经累积的状态,让它匹配新的生产者状态。这样即使是有依赖的多个归约,也可以合并成一个,一次遍历完成所有计算。
我们熟知的在线 softmax 实现,本质上就是靠这个修复融合规则,把最大值、指数和、加权和三个有依赖的归约合并成一个滚动归约,这也是 FlashAttention 的核心逻辑。
4.3 并行传播规则:自动打通算子边界
只在单个算子上做分块还不够,要形成完整的分块计算流,分块的结构必须能顺着数据流传到前后的所有算子。传播规则就是用来完成这件事的:对于逐点算子,分块、复制、组合可以直接移到算子的输入端,或者反过来移到输出端,等式依然成立。
举个简单的例子:先对一个张量做分块,再做指数运算,等于先做指数运算,再对结果做分块。因为逐点算子是元素独立的,分块不会影响计算结果。
对于多输入的逐点算子,两个输入要在同一个并行坐标上配对,广播的输入用复制来对齐。复制操作还可以跨过归约操作,只要复制的轴不是被归约的轴就可以。
这些传播规则看起来很基础,但作用非常关键。有了它们,不需要为每一种算子序列都写专门的分块重写,分块结构可以自动沿着计算图传播,和细化规则、融合规则组合起来,就能生成非常复杂的分块融合程序。
4.4 规则的组合能力:自动生成 FlashAttention
单条规则的能力有限,但当它们组合起来的时候,就能爆发出强大的优化能力,甚至复现人类专家精心设计的内核结构。论文中用从原生 Attention 到分块滚动 Attention 的推导过程,完美展示了规则的组合威力。
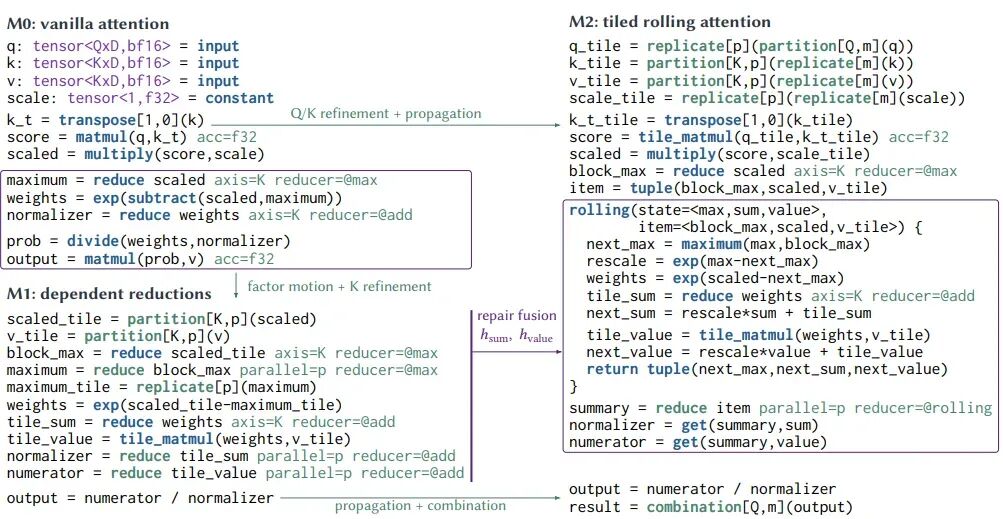
图 5:从基础注意力(M0)到分块滚动注意力(M2)的修复、细化与传播规则组合。M0 是原生注意力实现;M1 引入 K 维分块与因子移动;M2 通过修复融合规则将三个依赖归约合并为一个滚动归约,实现了分块内的在线 softmax 计算。
上图从最朴素的 Attention 张量表达式出发,先做 Q 和 K 维度的并行细化,再通过传播规则把分块结构扩散到缩放、指数、转置等操作;接着用因子移动代数重写,把归一化的除法移到值矩阵乘法之后;然后用修复融合规则,把三个有依赖的归约合并成一个滚动归约;最后加上组合操作,就得到了完整的分块滚动注意力实现,和 FlashAttention 的结构本质上是一致的。
整个过程不需要人工设计内核结构,完全由相等规则自动组合生成。这也是这套方法最核心的价值:只要定义好基础规则,复杂的最优结构可以自动涌现。
整体看下来,这套规则体系的核心价值是可组合性。每条规则都很简单,但叠加起来就能生成极其丰富的实现空间,甚至能复现人类专家精心设计的 FlashAttention 级别的优化。
五、可扩展的程序提取:从搜索空间到最优实现
5.1 早期压缩:提前剪枝冗余候选
e-graph 里存储了所有等价的表达式,但最终我们需要从中选出一个具体的、可执行的程序,这个过程叫做提取。 传统提取方法要么按 AST 大小选择,要么解整数线性规划,但 EqiForge 面对的是带执行细节的完整程序,候选数量极多,直接枚举所有完整候选的成本太高。
很多候选程序虽然写法不同,但实际性能其实差不多,把它们都完整构建出来、都去测试性能,完全是冗余开销。EqiForge 的做法是定义一个等价关系,把等价的候选归成一类,只评估每个类的一个代表。
但如果等所有候选都构建完再去重,还是要先把指数级的候选都生成一遍,成本依然很高。所以 EqiForge 提出了早期压缩:在候选程序还没构建完整的时候,就比较部分程序的等价性,如果两个部分程序等价,直接剪掉其中一个,不用继续展开了。
部分程序指的是已经选了一些算子,还有一些 e-class 没确定,用洞来表示的程序。如果两个部分程序,不管洞里填什么内容,最终得到的完整程序都是等价的,那这两个部分程序就是等价的,可以只保留一个。比如 a+b 和 b+a,不管 a 和 b 具体是什么,结果都一样,展开的时候遇到第二个就可以直接剪掉。
下面这段文字描述的正是在 e-graph 提取中应用早期压缩的直观案例:输出等价类下有三个候选分支,其中两个候选仅在逐点加法的操作数顺序上不同,它们属于等价的部分程序,只需保留一个代表;而通过因子分解减少了一次矩阵乘法的候选则属于不同结构,必须保留。这清楚说明了"什么分支能剪、什么分支不能剪"的判断依据。
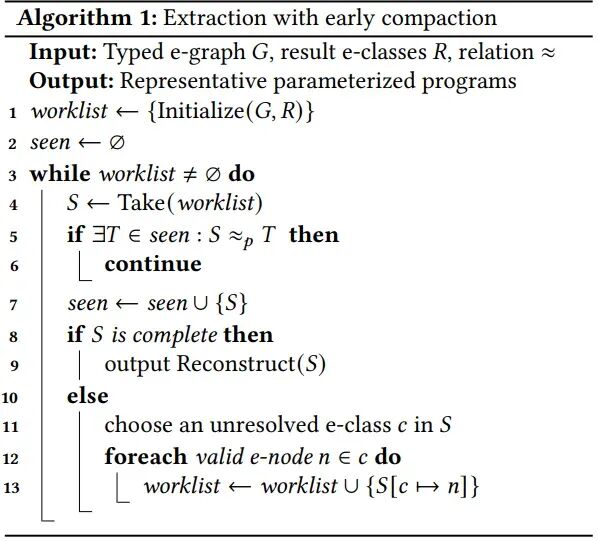
算法 1:带早期压缩的提取算法。输入:带类型的 e-graph G、结果等价类集合 R、等价关系≈,输出:代表性参数化程序。该算法采用宽度优先的方式从结果等价类出发逐步扩展部分程序,核心创新是在扩展前就进行等价性检查,若当前部分程序与已见过的部分程序等价,则直接跳过扩展。算法的早期剪枝策略从根源上避免了冗余分支的扩展,保证输出候选与全量枚举具有相同的等价类覆盖度。
上面这个算法的核心是第 5 步的提前判断:在展开一个部分程序之前,先检查有没有已经见过的等价部分程序,如果有就直接跳过。这样可以在搜索树的很上层就剪掉大量冗余分支,不用等到叶子节点再处理。
5.2 子图组合:面向大图的分治搜索
对于更大规模的计算图,全图做相等饱和的成本太高,EqiForge 采用分治策略:把大图划分成多个子图,每个子图单独做相等饱和和提取,再把子图的实现组合起来。划分的时候需要权衡:子图越大,能联合优化的操作越多,但搜索成本也越高;子图越小,搜索越快,但跨子图的优化就做不了。
EqiForge 会按估计的子图工作量和边界数据传输量来排序划分方案,选择合适的子图大小。每个子图的候选实现可以复用,只要同一个子图在别的地方出现,就不用重新搜索。
组合的时候通过类型接口做懒组合,不用枚举所有子图候选的笛卡尔积,大大降低了组合爆炸的风险,同时保留了跨子图的优化可能性。
5.3 代码生成与渐进调优
提取出来的程序还是符号化的,调度参数比如分块大小、warp 数、流水线级数等还没确定,这些参数对最终性能影响很大。EqiForge 不会穷举所有调度组合,而是先做静态排序,用乐观的延迟估计给候选排名,优先测试估计更快的候选,再逐步精细调优。
静态排序用线性规划松弛来估算每个候选的最优可能延迟,考虑计算量和全局内存访问量,除以硬件的吞吐和带宽,取瓶颈资源的时间作为估计值。这个方法不需要枚举所有调度,就能快速给出相对靠谱的排名。
然后用逐次减半的策略渐进调优:表现好的候选给更多的测量预算,表现差的少给。对于多内核程序,先固定中间缓冲区的形状,逐个内核调优,每一步都验证完整程序的正确性和时延。
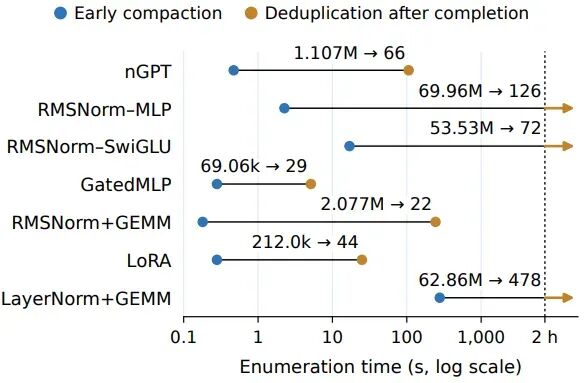
图 10:批量大小为 16 时的枚举时间与候选数量。标签显示构建的完整候选数 → 去重后的不同候选数。该图对比了无压缩、完成后压缩、早期压缩三种策略的枚举时间与候选数量。早期压缩策略将扩展状态数降低了 128 到 2465 倍,在 nGPT 场景下将枚举时间从 106 秒压缩到 0.47 秒。
从图中可以直观看到早期压缩的效果:nGPT 场景不用压缩要展开 106 秒,用了早期压缩只要 0.47 秒;RMSNorm-SwiGLU 场景,完成后去重跑两小时只得到 72 个不同候选,早期压缩 17 秒就得到 330 个候选。最多可以把展开状态数减少 2465 倍,效果非常显著。
回顾一下,提取阶段的两大关键技术——早期压缩解决了候选爆炸问题,子图组合解决了大图扩展问题,让相等饱和真正可以用到实际的、有规模的张量程序上,而不只是小算子演示。
六、实验评估:全场景性能验证与案例分析
实验在 NVIDIA A100 80GB PCIe 和 RTX 5090 两款 GPU 上运行,对比了 PyTorch eager、torch.compile、TVM、Mirage、Trinity、FlashAttention、FlashInfer、Neptune 等多个主流基线。
测试覆盖归一化、MLP、低秩适配、因果多头注意力等多种工作负载,批量大小包含 1、8、16 三种配置。每个配置的搜索和调优预算是 4 小时,输出结果和 PyTorch 的相对 L2 误差不超过 0.01,保证数值正确性。
6.1 基准测试整体表现
首先看通用张量程序基准的结果,一共 21 个配置,EqiForge 在其中 18 个配置上超过了当时最快的基线。整体几何平均加速比是 1.32 倍,单配置最高加速达到 2.74 倍。
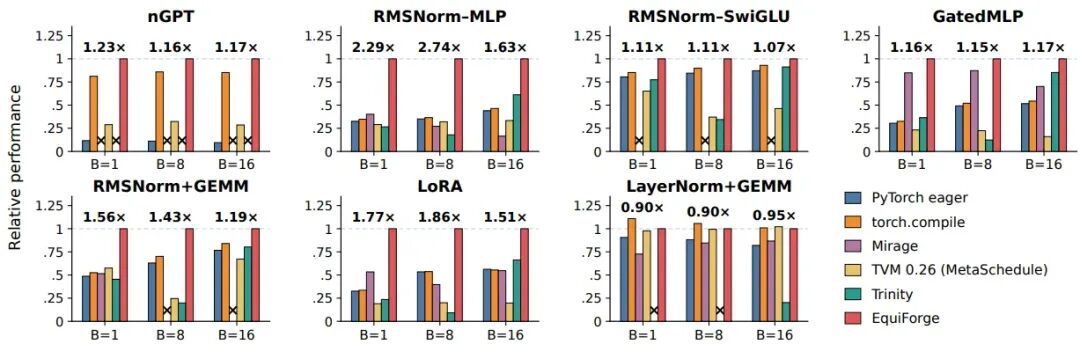
图 7:多样张量程序的性能(以 EquiForge 为基准归一化)。EquiForge 在 21 种配置中的 18 种上超越了最快基线,几何平均加速比达 1.32 倍,最高在 RMSNorm-MLP 场景下达到 2.74 倍。其性能优势主要来自代数重写与算子融合的联合优化。仅在 LayerNorm-GEMM 场景下略逊于基线。
举几个典型案例:
- RMSNorm-MLP 在批量 8 时,EqiForge 把逐行归一化因子移到两个投影之后,再把两个投影和最后的逐点乘积融合成一个内核,避免了中间写回全局显存,比 torch.compile 快 2.74 倍。
- LoRA 在批量 1 时,Trinity 选择单个内核,每个输出块都重算低秩投影;EqiForge 用两个内核,把部分低秩乘积存下来复用,反而比单内核实现快 1.28 倍。
- 唯一的例外是 LayerNorm+GEMM,EqiForge 比最快基线慢 6%-12%,因为选中的方案是先算归一化统计再做投影,多了内核启动和中间显存开销。
6.2 Attention 算子专项对比
Attention 是大模型里最核心也最吃性能的算子,也是优化竞争最激烈的领域。解码阶段,EqiForge 在三个批量配置下都超过所有对比基线,最高比 FlashAttention 快 1.87 倍。
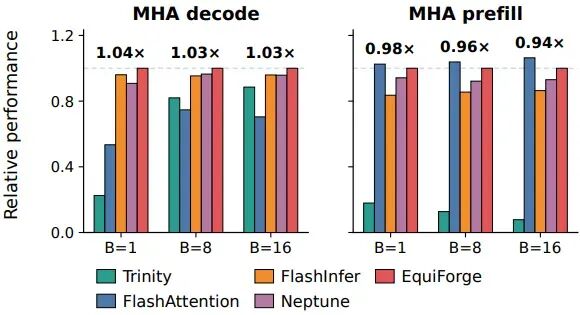
图 8:多头注意力在解码与预填充阶段的性能(以 EquiForge 为基准归一化)。解码阶段 EquiForge 全面超越所有基线,优势来自其通过通道分块与重复计算换并行的策略;预填充阶段 EquiForge 与 FlashAttention 性能接近,差距主要来自 Triton 代码生成的调度优化空间。
解码阶段批量 1 时,EqiForge 的实现把输出通道拆到每个头的两个块里,每个块都计算一遍分数和 softmax,但输出不同的部分,用少量重复计算换取更高的并行度,还不需要额外的合并内核。
预填充阶段,EqiForge 和 FlashAttention 的性能很接近,差距只有 3%-6%。论文分析这个差距主要来自 Triton 代码生成本身的调度和访存重叠问题,不是算法结构的问题。生成的内核同样采用分块矩阵乘法加在线 softmax 的结构,不需要存储完整的分数和概率矩阵。
更有价值的是,EqiForge 可以对整个 Transformer 层做全局优化,发现一些人类设计师都不一定能想到的实现方式,带来更大的性能提升。论文挑选了五个有代表性的 Transformer 层做案例分析,都是单查询 token 的解码场景。
| Transformer 层类型 |
相对于 torch.compile 加速比 |
| QK 归一化 MLA(批量 1,隐藏层 4096,历史 16K) |
3.16 倍 |
| mHC(批量 16,隐藏层 512,历史 1K) |
5.84 倍 |
| 滑动窗口 GQA(批量 1,隐藏层 4096,历史 16K) |
1.06 倍 |
| Attention Sinks(批量 1,隐藏层 1024,历史 32K) |
1.48 倍 |
| 差分注意力(批量 1,隐藏层 1024,历史 32K) |
1.51 倍 |
其中,两个最突出的案例:
- 第一个是 QK 归一化 MLA。EqiForge 把键投影移到查询路径上,值投影移到注意力之后,这样不用把历史的键和值都从隐状态缓存里展开,换成对单个查询和聚合上下文的操作。缓存的逆 RMS 因子也从展开的键移到注意力 logits 上,既保留了键归一化的效果,又大大减少了计算量。
- 第二个是 mHC。这个层有四个残支流,注意力和 MLP 周围有独立的连接。EqiForge 把第一个残差更新和下一个连接的归一化合到一个内核里,跨模型组件边界做融合,归一化直接复用内核里刚更新的残差,不用再读一次中间结果。整层实现比 torch.compile 快 5.84 倍。
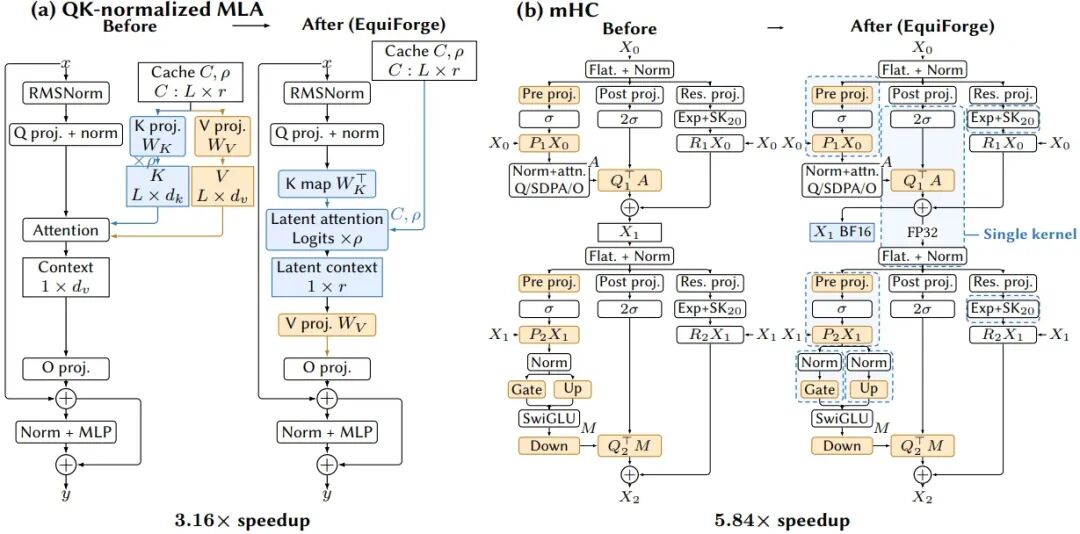
图 9:EquiForge 发现的层结构:(a) QK 归一化多头潜注意力,(b) 流形约束超连接层。QK 归一化 MLA 的优化侧重高层数学形式的重写;mHC 的优化侧重执行层面的跨边界融合。两个案例分别实现了 3.16 倍与 5.84 倍的加速。
这两个案例充分说明,EqiForge 的优化不止于单个算子,它可以跨组件、跨层地寻找融合和重写机会,发现人类设计师很难覆盖到的全局最优结构。
6.4 搜索开销分析
性能好固然重要,但搜索成本高不高,决定了超优化器能不能实际落地。下表给出了 B=16 时各工作负载的 e-graph 大小和饱和、提取时间。
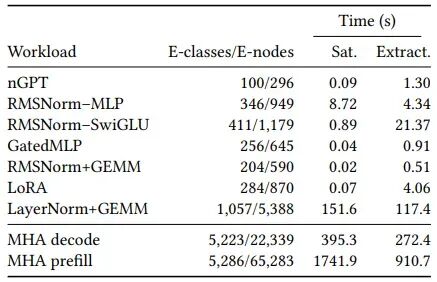
表 2:批量大小为 16 时 EquiForge 的 e-graph 规模与搜索开销。普通 MLP、归一化等简单工作负载的 e 节点数普遍低于 1200,搜索耗时在秒级;多头注意力工作负载的 e 节点数突破 2 万甚至 6.5 万,饱和耗时达数百至数千秒。
非注意力工作负载基本都在 1200 个 e-node 以内,饱和加提取几十秒就能完成。注意力负载相对大一些,解码阶段两万多 e-node,饱和加提取大概 11 分钟;预填充阶段六万多 e-node,大概 44 分钟。
这个开销看起来不低,但要注意这是超优化——一次性搜索出最优实现,之后可以反复使用。而且早期压缩已经把成本降低了几个数量级,如果没有早期压缩,很多场景根本跑不完。
整体来看,EqiForge 在绝大多数场景下都超过了当前最优的张量编译器和手工优化内核,并且能自动发现跨层的全局优化结构,用几小时的一次性搜索成本,换来了持续的推理性能收益。
七、总结与行业启示
这项工作把相等饱和技术在张量编译领域的应用推到了新的高度,第一次真正实现了代数重写和执行优化的联合相等搜索,并且解决了规模化落地的核心问题。它的核心贡献不只是一个更快的编译器,更是一套完整的方法论:统一 IR、可组合规则、早期压缩、子图组合,这套方法可以复用到很多其他的编译优化场景。
就目前 AI 编译现状,也带来了三点重要启示:
- 第一,张量编译还远没有到达性能天花板。过去行业普遍认为 FlashAttention 已经接近手工优化的极限,但 EqiForge 证明,通过系统化的联合搜索,还有很大的性能空间可以挖掘,尤其是跨层、跨组件的全局优化,还有很多红利没有释放。
- 第二,相等饱和技术的潜力还远没有释放完。过去相等饱和更多用在代数化简、指令选择等相对简单的场景,这篇工作把它扩展到了并行执行、内核融合、分块策略等更复杂的空间,打开了全新的研究方向。
- 第三,超优化不是只能停留在小算子阶段。通过早期压缩和子图组合,超优化的搜索成本可以得到有效控制,完全可以应用到实际的 Transformer 层甚至更大的模型结构,从实验室走向工业落地。
当然这项工作也还有可以继续完善的地方。比如预填充场景和 FlashAttention 还有一点性能差距,搜索时间对于在线编译来说还是太长,更适合离线部署前的超优化。未来可以结合引导式相等饱和、更精准的成本模型引导搜索等方向,进一步降低搜索成本,拓展适用场景。
总的来说,EqiForge 为张量程序超优化提供了一个非常有说服力的范式,用相等饱和打通代数与执行的壁垒,用系统的方法替代零散的手工优化,这很可能是未来张量编译的重要发展方向之一。这也是云栈社区持续关注张量编译前沿进展的原因所在。
 发表于 2 小时前
|
查看: 2|
回复: 0


