做过 SDIO、eMMC、HyperRAM 的人,多半写过这么一段代码:用 PLL 或 MMCM 对系统时钟分频,取其中一位 assign 到引脚,就当设备时钟使了。
它能跑。卡能读,数据能写,上板一次就通。
但这个做法有频率限制。同一根时钟既要在 400kHz 上慢慢起头,又要在 200MHz 上高速传数据,还要在两者之间干净地来回切换。到这时候,那个分频出来的时钟就开始不听话了。
一、分频直接输出,坑到底在哪?
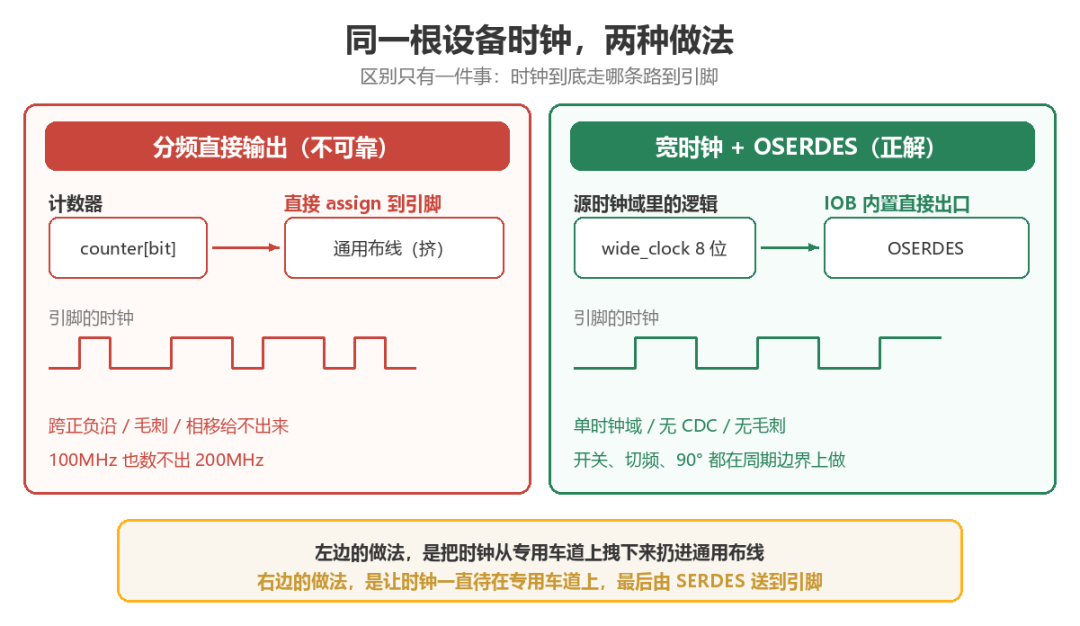
先把话说明白,这不是「分频不能用」。分频本身没问题,问题出在把时钟直接 assign 到引脚上。
第一个坑,时钟被当成了组合逻辑信号。 综合工具眼里它就是一个普通网线,走通用布线,路上随便一段组合逻辑都能给它添延迟,添出个毛刺来。
第二个坑,分频时钟经常被人顺手配上两种沿。 always @(posedge dev_clk) 之外,再写一个 always @(negedge dev_clk),DDR 采样那类场景特别容易这么干。这一下就把单时钟域的原则破掉了,两个沿之间的路径,工具没法替你兜底。
第三个坑,路径延迟不可预测。 同一个设计,综合前仿真和综合后仿真行为不一样,板子上再跑一遍又是另一个结果。这类问题最难受的地方不在于难修,在于难复现。
这些坑合起来其实只有一句话:分频分出来的那个时钟,看着像时钟,其实是个普通信号。
二、换个思路,把时钟当数据发
ZipCPU 的作者 Dan Gisselquist 给的解法,第一句话就有点反直觉:不要去做一个时钟产生电路,把时钟编码成数据发出去。
他给这个东西起名叫宽时钟,Wide Clock。做法是这样的。
一个系统时钟周期切成 4 个等长的时间段,从 3 数到 0。然后定义一个 N 位的信号,每一位代表对应的那段时间里,引脚上该是什么电平。
容易混的是这一点:4 段说的是相位划分,决定边沿能摆在哪几个位置;宽信号的位宽跟着 SERDES 档位走,8 倍串行就 8 位,4 倍串行就 4 位。
这个宽信号不直接接引脚,它被喂进 OSERDES。OSERDES 有 8 倍和 4 倍两档串行化,8 倍那一档一次推 8 位,4 倍那一档一次推 4 位。OSERDES 是 IOB 里自带的资源,专门干串行化这件事,它把宽信号一位一位推到引脚上,推的速度比系统时钟快好几倍。
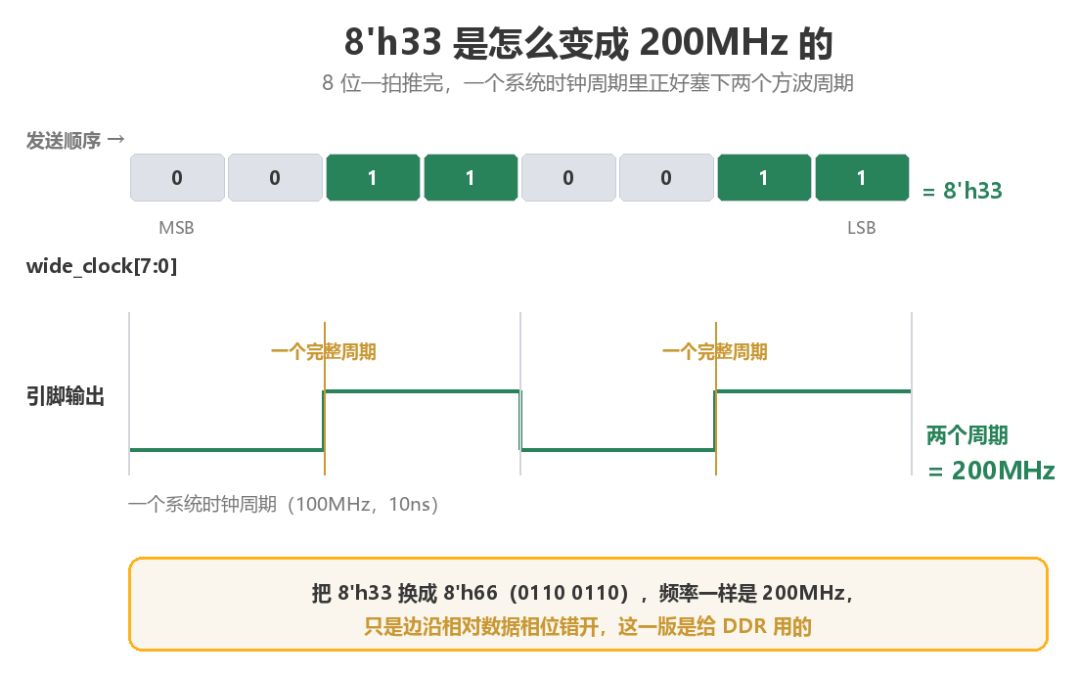
有意思的地方就在这里。用 8 倍串行那一档,100MHz 的系统时钟一个周期喂进去 8 位,这 8 位正好能塞下两个完整的方波周期,输出就是 200MHz。前面说的频率限制,就这么绕过去了。
更关键的是所有逻辑全都留在源时钟域里。你写的每一个 always 块,触发条件还是那个系统时钟。设备时钟线上发生的事,在你自己的逻辑里只是「一位一位被推出去的数据」。单时钟域,没有 CDC,也就不需要同步器。
节奏靠两个使能信号控制。一个叫 new_edge,标记新时钟周期的开始;一个叫 half_edge,标记半周期的位置,DDR 模式下的数据就是在这一刻换的。
时序上最要紧的一条是关断。停这根时钟,不是把输出直接拉低,而是等当前这个时钟周期走完,把一个完整脉冲走完,再把输出保持成 0。这样停干净了,下一次起来才不带毛刺。SDIO 这类协议要求时钟能随时暂停、随时恢复,靠的就是这个动作。
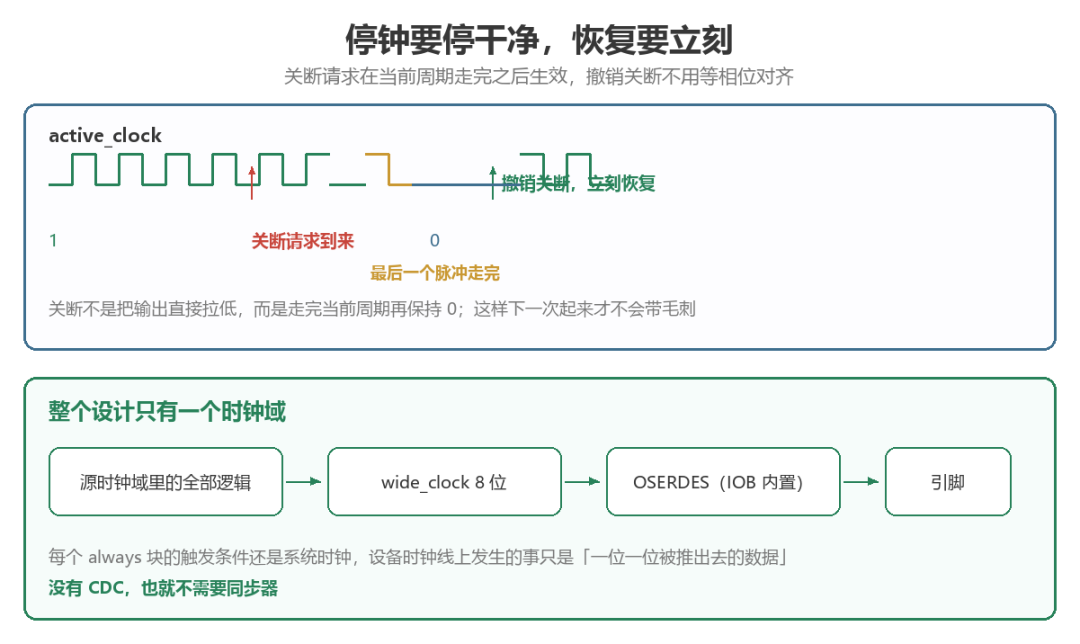
时钟不是被造出来的,是被送出去的。 这句话值得多念两遍。
三、能直接抄的编码表
原理说完,得给能抄的东西。
假设系统时钟 100MHz,用 8 倍串行的 OSERDES,宽信号取什么值,就决定了输出是什么时钟。这张表就是全部。
| 模式 |
宽信号值 wide_clock[7:0] |
输出频率 |
说明 |
| 最高速 SDR |
8'h33 |
200MHz |
每拍翻转,靠 8 倍串行做出的倍频档 |
| 最高速 DDR 90° |
8'h66 |
200MHz DDR |
边沿相对数据错开,给 DDR 用 |
| 半速 SDR |
8'h0f ↔ 8'hf0 交替 |
50MHz |
两个输出周期才翻转一次 |
| 半速 DDR 90° |
8'h3c |
100MHz DDR |
OSERDES 专用配置 |
| 1/4 速 SDR |
8'h00 两个周期 → 8'hff 两个周期 |
25MHz |
宽值保持两个时钟周期 |
| 关断 |
8'h00 |
0Hz |
干净停钟 |
如果用 4 倍串行的 OSERDES,或者 2 倍串行的 ODDR,思路一模一样:位宽折半、值等比缩小,最高速 SDR 就从 8'h33 变成 4'h3。位宽折半,同一档的输出频率也跟着降一档。
表里最值得盯一眼的是 8'h33 这一行。写成二进制是 00110011,四位一截,正好两个完整周期,8 位一拍推完,200MHz 就出来了。
代码骨架长这样,宽值和使能位一起提交:
reg [7:0] outgoing_clock;   // 宽时钟,喂给 OSERDES
reg       active_clock;     // 时钟使能

always @(posedge src_clk)
if (i_reset) begin
    outgoing_clock <= 8'h0;
    active_clock   <= 1'b0;
end else if ((S_VALID && S_READY) || (new_edge && active_clock)) begin
    outgoing_clock <= wide_clock;   // 提交新的一个时钟周期
    active_clock   <= 1'b1;
end else if (new_edge) begin
    outgoing_clock <= 8'h0;         // 没有数据要发,停钟
    active_clock   <= 1'b0;
end
ZipCPU 那个 sdspi 控制器里,这个模块叫 sdckgen.v,是这套方法的一个完整实现。
它的计数器分两段用。高两位管相位,从 3 走到 0;低八位只有当配置的分频系数大于等于 3 时才当分频计数器用。new_edge 在相位从 3 翻到 0 时拉起来,half_edge 在 3 到 0 或 1 到 0 时拉起来。速度配置分四档:写 0 是 200MHz,写 1 是 100MHz,写 2 是 50MHz,宽值在 8'h0f 和 8'hf0 之间交替,大于等于 3 就按 100 除以「配置值减 1」去分频。
关断那段代码值得单看一眼。请求关断之后,它把计数器直接置到相位 3 的位置,等当前周期走完,输出就停在那儿。撤销关断则立刻恢复,不用等相位对齐。一个走完再停,一个说到就到。
四、这套方法也有边界
先说一个容易忽略的点:这东西不是「跑起来就行」。
宽信号能取的值只有那几个:8'h33、8'h66、8'h0f、8'hf0、8'h3c、8'h00、8'hff。代码一旦拼出别的值,就意味着这根时钟已经有了你没打算要的形状。速度、相位、关断恢复这几类组合一交叉,穷举量很快就上去了,靠仿真盯波形盯不住。
所以这套设计要做形式验证。但这事儿没有想象中重,它有一个很轻的切法,叫接口属性分离。
把生成器和后面收数据的那部分之间定义成一份接口属性文件。证明生成器的时候,把对端的假设当成 assert,意思是我这边保证它成立;证明对端的时候,同一份文件里改成 assume,意思是先假定它成立。同一份属性,两边各证一次,最麻烦的一块就拆完了。
真正要证的其实不多,四条就够了:时钟的高电平低电平不能短于最快时钟的半个周期;频率切换只能发生在时钟周期之间;new_edge 和 half_edge 不会同时出现,最高速那一档除外;宽信号只取有效值。
再划两个边界。
一个是这套方法并非 ZipCPU 独创。Xilinx 的官方建议里就写着,输出时钟要用 ODDR 来转发;官方的支持记录也说过,这比把内部时钟直接驱动到 OBUF 可靠。这样内部时钟会一直停留在专用时钟网络上,直到 ODDR 才出去,不必走进通用布线。最常见的接法是 ODDR 的 D1 接 1、D2 接 0。
另一个是器件差异别忽略。7 系和 UltraScale 的 OSERDES,原语名字、位宽、级联方式都不一样。上面那些十六进制的值是特定位宽下的编码,换器件就要跟着换。动代码之前先翻自己那颗器件的手册。
最后是适用面。这套方法解决的是「要给外部器件送一根时钟」这一类问题,SDIO、eMMC、SPI、HyperRAM 这些接口都在里面。纯片内逻辑用不着它。这类 FPGA 高速接口的坑在云栈社区也经常被翻出来讨论,想深挖的可以去找找相关帖子。
 发表于 14 小时前
|
查看: 0|
回复: 0


