学习大模型,绕不开这 12 个词:Token、Embedding、Attention、Transformer、MoE、预训练、后训练、对齐、RAG、工具调用、推理、评测。
它们看起来像一串术语,实际对应的是模型从输入、计算、训练到使用和验证的完整链路:先把文本变成可计算的表示,再完成上下文建模;训练阶段让模型学到通用模式,并逐步学会按任务和偏好回答;需要外部知识和能力时,接入 RAG 与工具;最后再用推理和评测判断它能不能稳定解决问题。
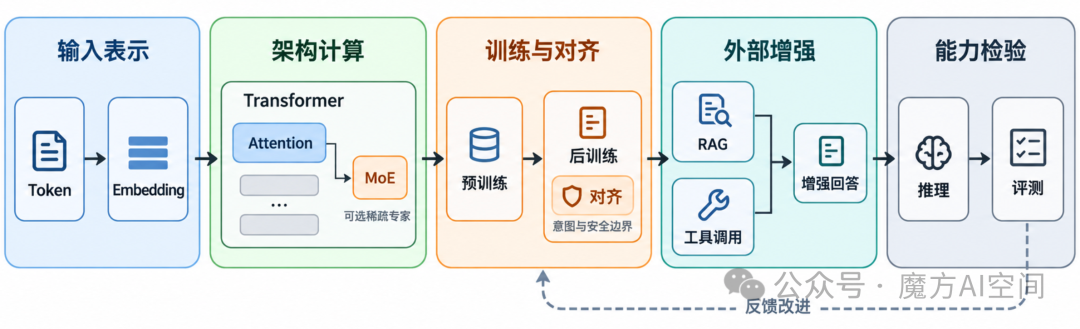
01 核心机制速览
表 1:大模型 12 个核心机制速查表。
| 机制 |
所在层级 |
解决的问题 |
常见误解 |
| Token |
输入表示 |
把文本切成模型可处理的单位 |
只是计费单位 |
| Embedding |
输入表示 |
把 Token 变成向量 |
只存在于向量数据库 |
| Attention |
上下文计算 |
判断当前内容该关注哪些上下文 |
等同于 Transformer |
| Transformer |
模型架构 |
组织注意力、前馈网络和残差结构 |
只是一个注意力公式 |
| MoE |
规模化架构 |
用稀疏专家提高容量与效率 |
多个模型简单拼接 |
| 预训练 |
能力来源 |
从海量数据学习通用模式 |
直接学会听话 |
| 后训练 |
行为调整 |
让模型更会遵循任务和偏好 |
等同于继续预训练 |
| 对齐 |
可靠输出 |
让模型输出更符合人类意图和安全边界 |
只是内容审查 |
| RAG |
外部知识 |
检索外部资料辅助生成 |
只是向量库 |
| 工具调用 |
外部动作 |
调用搜索、代码、数据库等工具 |
只有 Agent 才需要 |
| 推理 |
中间过程 |
分解问题、规划步骤、验证答案 |
输出越长越会推理 |
| 评测 |
能力验证 |
判断模型在任务中的真实表现 |
只看榜单分数 |
02 Token:大模型先把文字切成什么
自然语言不能直接进入神经网络。模型看到的不是完整句子,而是一串 Token。
Token 是模型处理文本的基本单位。它可以是一个字、一个词、一个子词,也可以是标点、空格、代码片段。具体怎么切,由模型的分词器决定。同一句话,在不同模型里可能对应不同数量的 Token。
所以 Token 不只是计费单位。它会影响上下文长度、API 成本、长文档处理效率,也会影响中文、英文、代码和多语言输入的压缩效率。尤其是在模型 API 接入与成本估算场景里,Token 切分方式直接决定了请求价格和上下文窗口能不能装下目标内容。
常见分词方式可以粗略分成三类:按词切、按字符切、按子词切。词级方法语义完整,但词表容易变大;字符级方法覆盖面强,但序列会变长;子词方法介于两者之间,把高频片段合并,把低频词拆开,也是现代大模型更常见的选择。BPE 和 SentencePiece 都是理解现代分词器的重要参考。
03 Embedding:Token 怎样变成向量
Token 本身只是离散编号。编号不能表示语义,也不能直接参与神经网络计算。
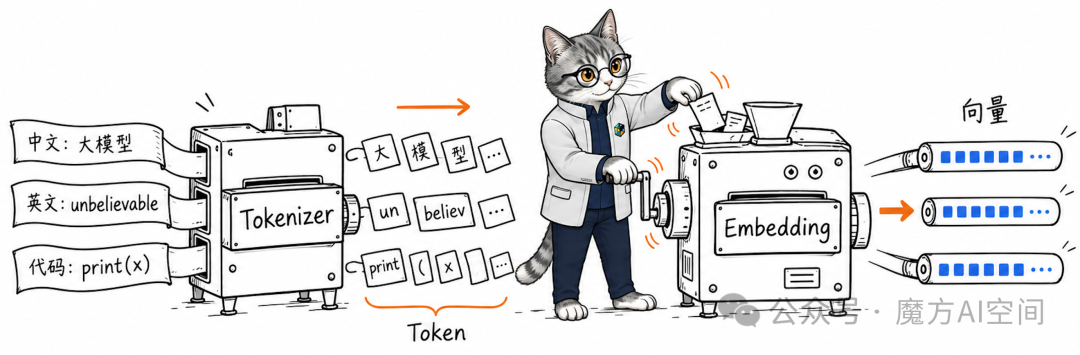
Embedding 的作用,是把 Token 映射成连续向量。向量里编码的是模型学到的语义、位置和上下文线索,后面的注意力计算、语义关联、上下文建模,都是在这些向量表示上完成的。
这里要区分两种常见说法。
表 2:模型内部 Embedding 与检索 Embedding 的区别。
| 类型 |
位置 |
作用 |
| 模型内部 Embedding |
大模型输入层 |
把 Token ID 变成 Transformer 能处理的向量 |
| 检索 Embedding |
RAG / 向量搜索系统 |
把问题和文档片段变成向量,用于相似度匹配 |
很多人说 Embedding 时,想到的是向量数据库。这个理解没错,但不完整。大模型内部也有 Embedding:Token 进入 Transformer 之前,先要变成向量。RAG 里的检索 Embedding 则更强调“相似内容在向量空间里距离更近”,用来把问题和文档片段匹配起来。
04 Attention:上下文信息怎样流动
有了向量之后,模型要解决一个问题:当前 Token 更新自己的表示时,应该从上下文里取哪些信息?
这就是 Attention 要做的事。
《Attention Is All You Need》让 Attention 成为现代大模型的核心模块。它的基本计算可以用 Query、Key、Value 来理解:
- Query:当前 Token 在问什么;
- Key:上下文 Token 能提供什么线索;
- Value:真正被取走的信息。
Self-Attention 会让每个 Token 都和其他 Token 建立关系。Multi-Head Attention 则让模型从多个角度看同一段上下文:语法关系、指代关系、位置关系、代码依赖,都可能由不同注意力头捕捉。
Attention 不是智能的全部来源,但它解决了上下文信息如何流动的问题。
Attention 是模块,Transformer 是结构。
一个典型 Transformer Block 通常包括 Attention、前馈网络、残差连接、LayerNorm 和位置信息。把这样的 Block 堆叠很多层,就形成了大模型的主干。
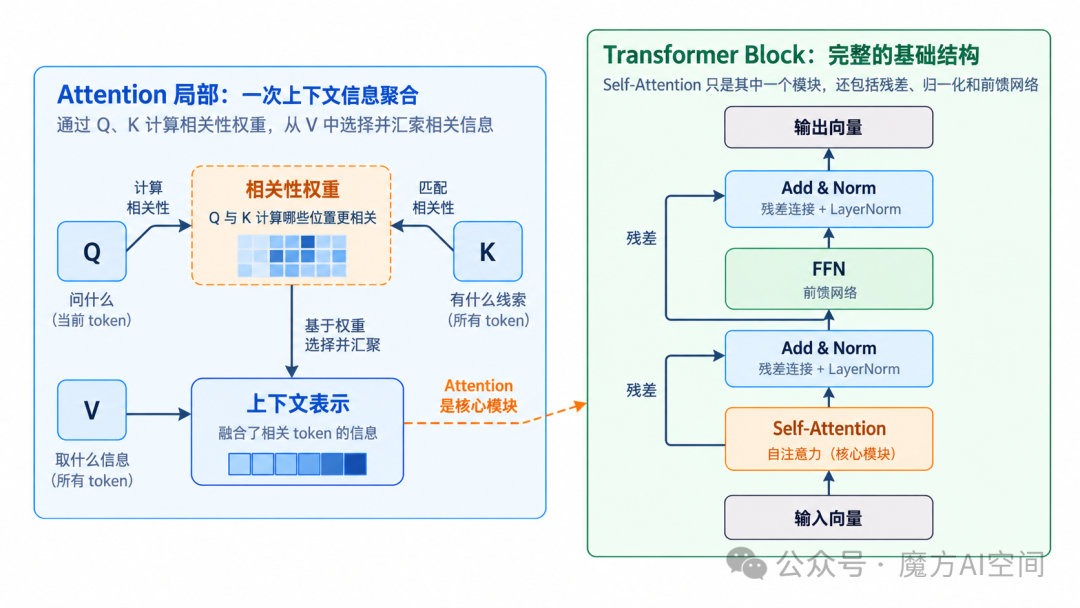
现代大语言模型多采用 decoder-only Transformer,通过自回归方式一步步预测下一个 Token。它的重点不只是“用了注意力”,还包括可并行训练、可扩展堆叠,以及把不同模态统一成序列来处理的能力。
输入向量
  ↓
Self-Attention:计算上下文关系
  ↓
Feed Forward Network:做非线性变换
  ↓
输出向量
文本、图像 patch、音频 token、视频 token,最后都可以被组织成序列。这也是为什么 Transformer 后来不只用于语言模型,也成为多模态模型的基础结构之一。
表 3:Attention 与 Transformer 的区别。
| 概念 |
更准确的理解 |
| Attention |
Transformer 里的核心计算模块 |
| Transformer |
由 Attention、前馈网络、残差连接、归一化等组成的网络结构 |
06 MoE:不是所有参数都要同时工作
模型越来越大之后,参数规模和计算成本之间的矛盾会越来越明显。
MoE,也就是 Mixture of Experts,给出了一种“高参数、低激活”的折中:模型可以拥有很多专家参数,但每个 Token 只激活其中少数专家。
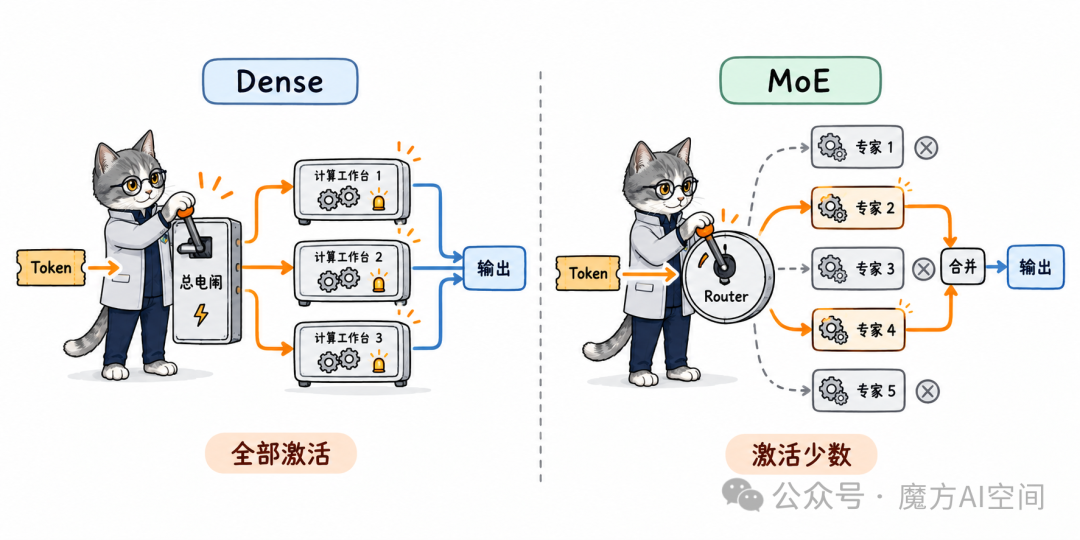
以 Switch Transformers 为代表的稀疏模型路线,重点不在“多个模型投票”,而在模型内部加入 Router,由它决定当前 Token 该送到哪些 Expert:
输入 Token 表示
  ↓
Router 选择专家
  ↓
激活少数 Expert
  ↓
合并专家输出
MoE 的收益,是让模型总参数变大,但单次计算量不必按总参数线性增长。换句话说,模型容量可以继续扩展,实际参与一次计算的参数仍然保持在可控范围内。
它的难点也很现实:路由负载均衡、专家利用率、多卡通信、训练稳定性和推理部署都会更复杂。
表 4:Dense 模型与 MoE 模型的差异。
| 类型 |
计算方式 |
主要特点 |
| Dense 模型 |
每次通常激活全部参数 |
结构简单,计算成本随模型变大持续上升 |
| MoE 模型 |
每个 Token 只激活部分专家 |
总容量更大,但路由和部署更复杂 |
07 预训练:模型能力从哪里来
如果说 Token 和 Embedding 是输入,Transformer 是结构,那么预训练就是模型能力的来源。
预训练通常使用自监督目标,不需要人工给每条数据标注答案。GPT 类模型常见做法是预测下一个 Token;BERT 代表的路线则通过预测被遮盖的词来学习上下文表示。GPT-3 则把自回归语言模型的规模化能力推到更显眼的位置。
预训练让模型从大规模文本、代码、图文对或多模态数据中学习语言结构、知识关联、代码模式和世界常识的统计关系。
规模为什么重要?Scaling Laws 讨论了模型参数、数据量和计算量之间的关系。Chinchilla 进一步提醒:不是只把模型做大就够,数据量和计算分配同样关键。
预训练后的模型会续写,但不一定会稳定回答问题。它可能知道很多东西,却未必知道用户想要什么样的回答。
08 后训练与对齐:从会续写,到更会回答
要让预训练模型进入真实产品,还需要后训练。
后训练是一个方法集合,常见包括 SFT、RLHF、DPO、RLVR 等。平时说的指令微调、偏好优化、强化学习训练,基本都可以沿着这条线理解。对齐则是后训练的重要目标之一:让模型更符合人类意图、任务要求和安全边界。
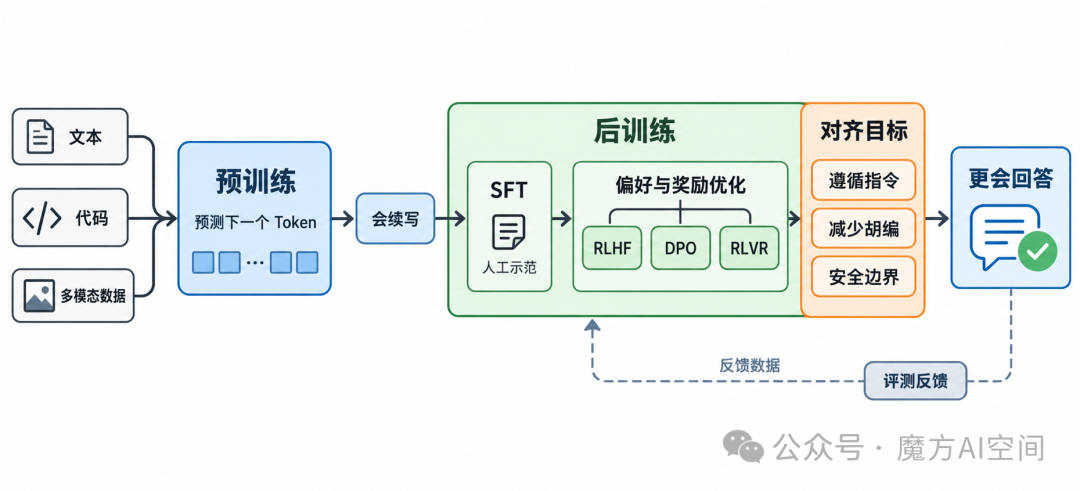
InstructGPT 是理解指令微调和 RLHF 的经典入口。它大致包含三步:
SFT:用人工示范教模型怎么回答
  ↓
Reward Model:用人类偏好训练奖励模型
  ↓
RLHF:用奖励信号继续优化模型行为
后来 DPO 这类方法尝试更直接地使用偏好数据,减少强化学习流程的复杂度。
对齐不只是安全过滤。它会影响模型是否遵循指令、是否拒绝不合适请求、是否减少胡编、是否保持格式稳定,以及是否在不确定时承认边界。一个模型“会说”,不等于已经适合真实交互;后训练和对齐解决的正是这段距离。
09 RAG:大模型如何接入外部知识
预训练再大,也会遇到三个限制:知识会过时,私有资料进不了训练集,长文档也不可能全部塞进上下文。
RAG,Retrieval-Augmented Generation,就是把检索和生成结合起来。RAG 原始论文提出的方向,是让模型生成时能利用外部知识。如果你关注 RAG 的落地细节,会发现它远不止“接一个向量库”这么简单。
典型 RAG 可以拆成三段:先建立索引,再检索相关内容,最后把检索结果交给模型生成回答。
文档收集 → 切分 chunk → Embedding 向量化 → 建立索引
      → 检索相关片段 → 重排和拼接上下文
      → 大模型生成回答 → 返回答案和引用
RAG 的价值,是把模型回答锚定到外部资料上,让答案更容易追溯,也让企业知识库、论文问答、项目文档检索这类场景变得可做。
它的难点不只在向量库。chunk 怎么切、query 怎么改写、召回是否足够、上下文会不会塞错、引用能不能支撑答案,都会影响最终效果。真正上线时,还需要配合 技术文档 里的索引设计、评价指标和避坑经验一起看。
10 工具调用:大模型开始连接外部动作
RAG 主要解决“从哪里取知识”。工具调用解决的是“能不能做动作”。
工具可以是搜索引擎、代码解释器、数据库、日历、邮件、浏览器、企业 API,也可以是图像生成、语音合成、文件转换这类多模态工具。
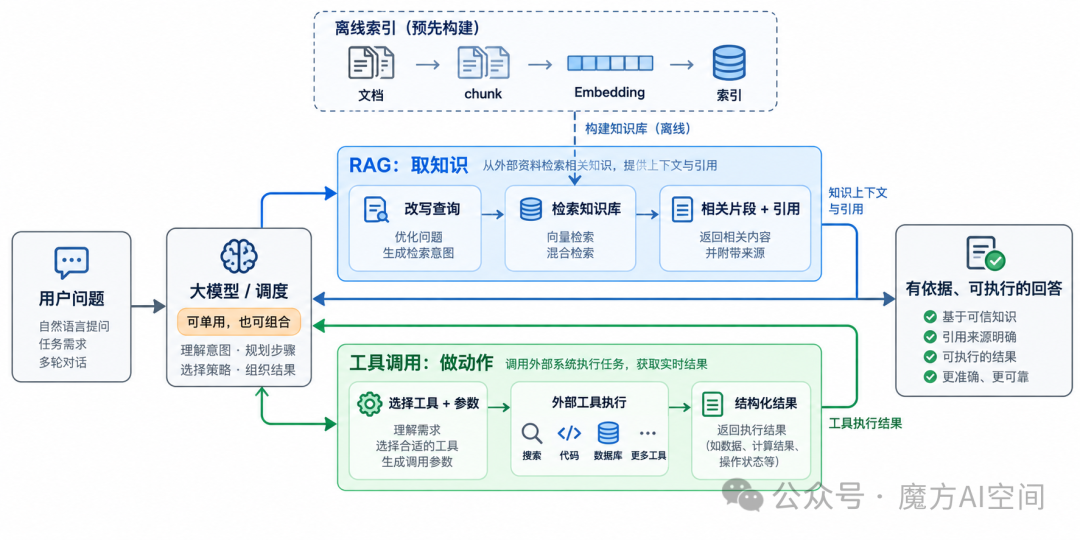
Toolformer 讨论了语言模型如何学习调用工具。ReAct 则把 reasoning 和 acting 放在一起:模型一边推理,一边决定是否要使用工具。
所以工具调用也是 Agent 系统的底层能力之一。没有工具调用,模型大多只能停留在回答问题;有了工具调用,它才可能查询实时信息、运行代码、操作文件,或者把任务交给外部系统完成。
工具调用的一般流程是:
用户提出任务
  ↓
模型判断是否需要工具
  ↓
选择工具并生成结构化参数
  ↓
工具执行并返回结果
  ↓
模型读取结果,继续推理或输出答案
工具调用不是简单把 API 接上就完事。参数错了会执行错,权限过大有安全风险,工具结果本身也可能不可靠,多步任务还会遇到失败恢复、状态记忆和成本延迟问题。
11 推理:模型为什么要分步骤想问题?
推理不是回答更长,也不是把过程写得更像人。
它更关心几件事:模型能不能把复杂问题拆开,能不能维护中间状态,能不能比较不同路径,能不能在必要时检查答案。
Chain-of-Thought Prompting 让大家看到一个现象:在数学、常识、多步问答等任务中,让模型显式写出中间步骤,往往能提升表现。
后来的推理路线继续分化:从 prompt 诱导,到训练中强化推理过程,再到结合搜索、验证器和工具调用。
这里也要有边界:推理链写得长,不代表答案更可靠。模型可能生成看似合理但错误的推理过程。很多任务还需要检索、计算器、代码执行或外部工具一起完成。
12 评测:为什么榜单分数高,不等于真实好用?
模型机制讲完,最后要回到评测。
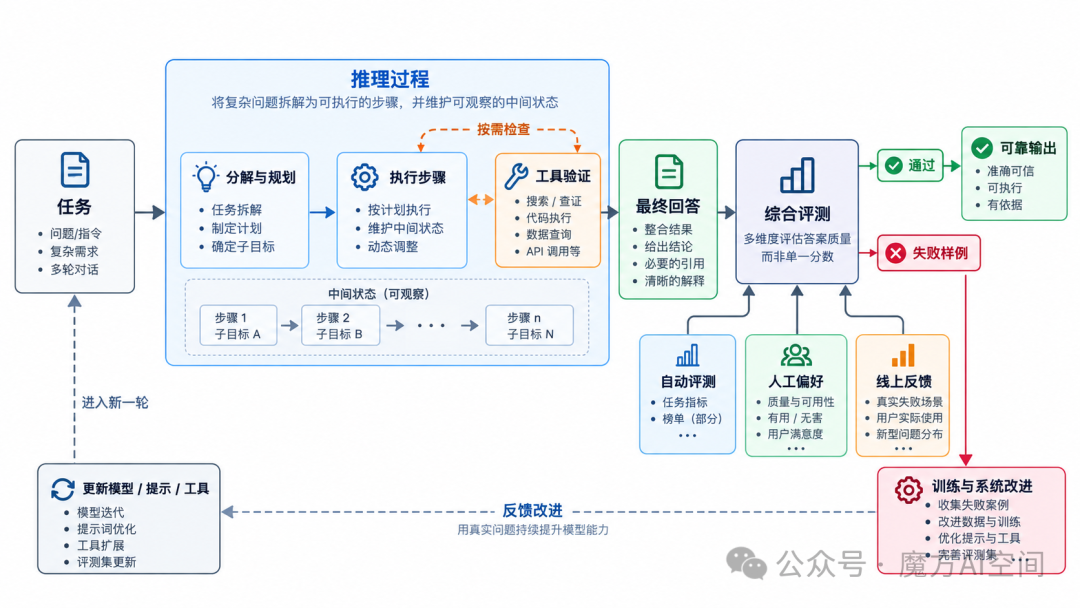
因为模型最终不是拿来欣赏结构,而是要在任务里稳定解决问题。
常见评测可以分成几类:
表 5:大模型常见评测方向。
| 评测方向 |
代表问题 |
| 知识问答 |
是否掌握基础知识和专业知识 |
| 数学推理 |
是否能完成多步计算和逻辑推导 |
| 代码生成 |
是否能写出可运行、可测试的代码 |
| 长上下文 |
是否能处理长文档和跨段落信息 |
| 指令遵循 |
是否按用户要求输出 |
| 工具调用 |
是否能正确选择工具、填写参数、读取结果 |
| 多轮稳定性 |
是否能在长对话中保持状态 |
| 事实性与安全性 |
是否减少胡编、偏见和风险输出 |
| 成本与延迟 |
是否适合真实产品部署 |
MMLU 代表多任务知识评测,HumanEval 常用于代码生成评测,HELM 则尝试从更整体的角度评估语言模型。
榜单有价值,但不能替代真实任务测试。benchmark 可能被污染,模型可能针对题型过拟合,平均分可能掩盖关键失败场景,单轮问答也不能代表长期交互。
13 最后
理解大模型,不适合只背术语。
更稳的方式,是看每个机制在链路里的位置:
Token 决定模型怎样切分输入;
Embedding 把离散符号变成可计算向量;
Attention 和 Transformer 负责上下文建模;
MoE 让模型容量和计算成本之间有新的折中;
预训练给模型通用能力;
后训练和对齐让模型更适合真实交互;
RAG 和工具调用让模型连接外部知识与动作;
推理和评测决定它能不能可靠地解决问题。
把这条线看清楚,再看 RAG、Agent、推理模型、MoE 架构、多模态大模型,就不会只看到一个个热词。
也更容易判断:一个新技术到底是在改输入、改架构、改训练、改外部系统,还是改评测方式。
参考链接:
- 项目地址:https://ai-mzq.github.io/From-Zero-to-AGI/
- BPE:https://arxiv.org/abs/1508.07909
- SentencePiece:https://arxiv.org/abs/1808.06226
- Attention Is All You Need:https://arxiv.org/abs/1706.03762
- Switch Transformers:https://arxiv.org/abs/2101.03961
- BERT:https://arxiv.org/abs/1810.04805
- GPT-3:https://arxiv.org/abs/2005.14165
- Scaling Laws:https://arxiv.org/abs/2001.08361
- Chinchilla:https://arxiv.org/abs/2203.15556
- InstructGPT:https://arxiv.org/abs/2203.02155
- DPO:https://arxiv.org/abs/2305.18290
- RAG 原始论文:https://arxiv.org/abs/2005.11401
- Toolformer:https://arxiv.org/abs/2302.04761
- ReAct:https://arxiv.org/abs/2210.03629
- Chain-of-Thought Prompting:https://arxiv.org/abs/2201.11903
- MMLU:https://arxiv.org/abs/2009.03300
- HumanEval:https://arxiv.org/abs/2107.03374
- HELM:https://arxiv.org/abs/2211.09110
 发表于 7 天前
|
查看: 0|
回复: 0


