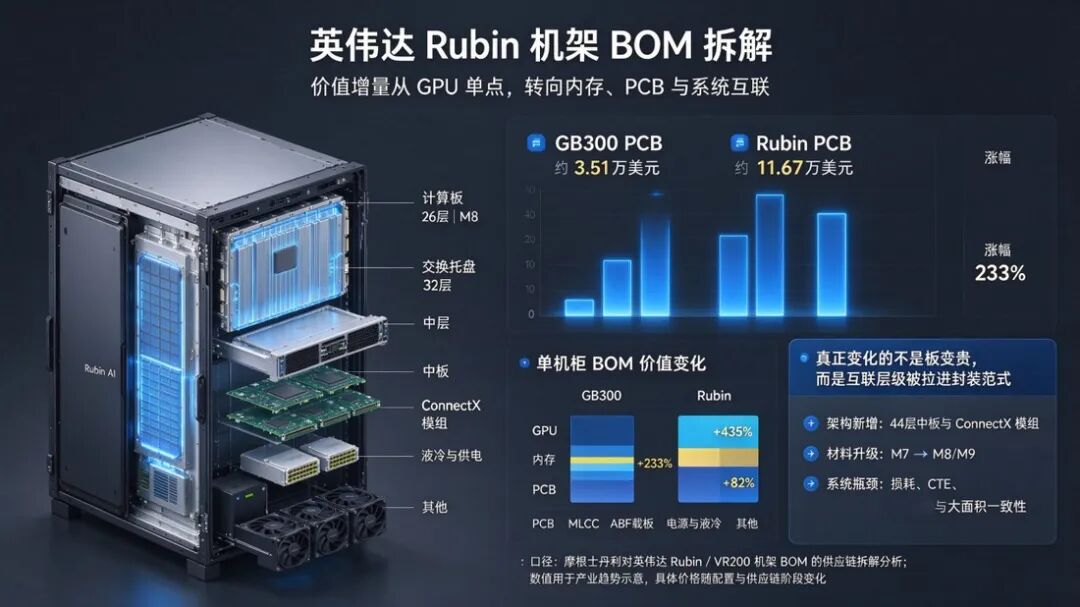
摩根士丹利 2026 年 5 月对英伟达 Rubin 机架的 BOM 拆解里,有一个被反复引用的数字:单机柜 PCB 价值从 GB300 的约 3.51 万美元升到约 11.67 万美元,涨幅 233%。同一张表上,GPU 是 57%,ABF 载板是 82%。一台售价近 780 万美元的机器里,涨得最凶的不是那颗最大的芯片,而是一块板。
如果只把这理解为“AI 拉动 PCB 需求”,就错过了真正的信号。
它说明的是:决定系统性能的互联密度,正在把原本被产业分工切开的两件事——先进封装与 PCB——重新压回同一套物理约束里。
边界是怎么消失的
旧的尺度分工相当清楚:硅中介层做到 1-2μm 线宽,管芯片之间的最高密度互联;ABF 载板 5-8μm,把芯片的微凸点扇出到 BGA;PCB 在 50μm 以上,管板间、系统与供电。三层各管一段,界面清楚,谁也不必为对方的良率负责。
两个事件打破了这个分层。
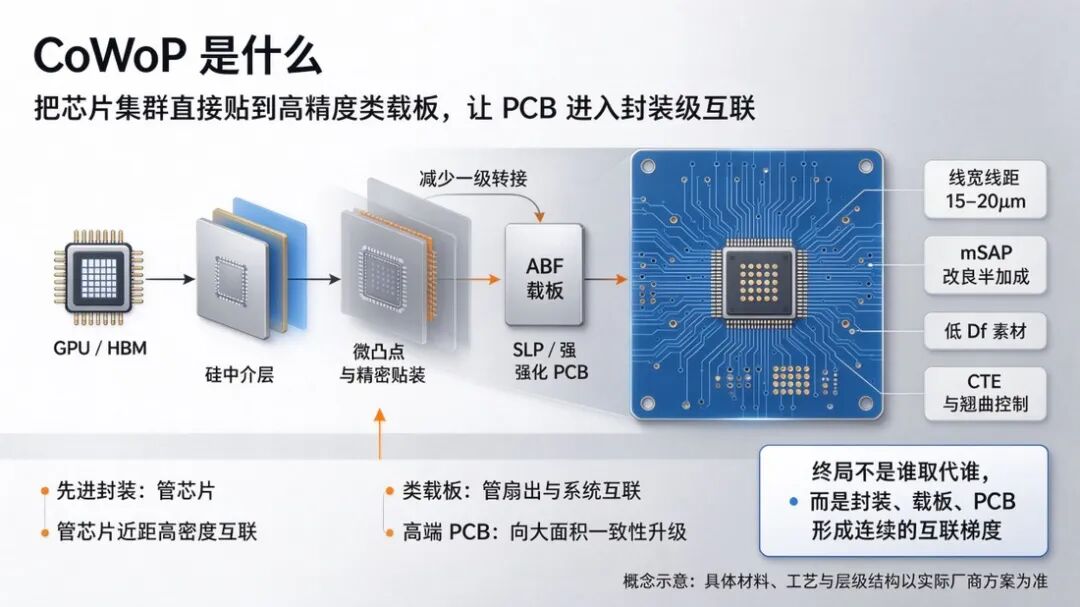
一是 CoWoP。它把 ABF 载板和 BGA 焊球一起拿掉,让硅中介层与 GPU/HBM 模组直接贴到高精度类载板(SLP)上。原本属于“一级封装”的功能,被交给了一块板。单颗 GPU 对应的 PCB 价值随之从 GB200 的约 200 美元升到约 600 美元。不是因为板变贵了,是因为板开始干过去载板干的活。
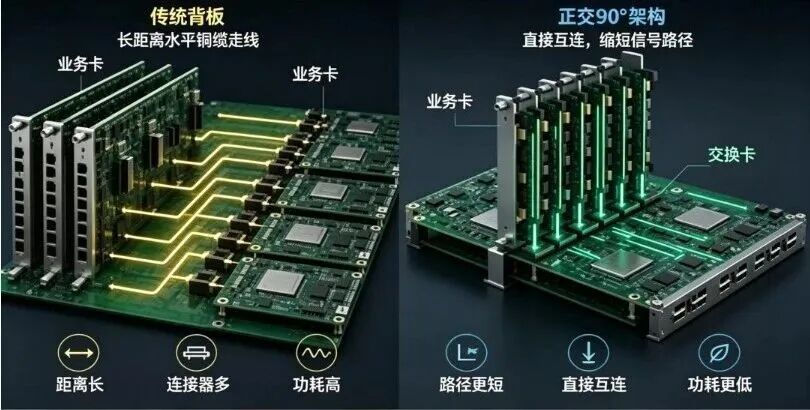
二是正交背板。Rubin Ultra 的 Kyber 机柜用一块约 1 平方米、78 层的 M9 级背板,替代超过 2 万根铜缆,直接完成 576 颗 GPU 与 NVSwitch 的全互联。这块板的层数、长径比(1-2cm 板厚对 0.2mm 孔径,超过 100:1)和阻抗公差(±5%),已经不是“PCB 的难度”,而是“中介层的难度”。
一句话概括:不是 PCB 努力向上爬,是“封装”这个词的定义在被拉长——从“把芯片包起来”,拉成“把芯片的互联一路推到系统”。梯度向外延伸,PCB 就站到了封装的最外一圈,被拉进同一个范式。
门槛不是线宽,是面积乘以精度
这里有个反直觉的地方,值得停下来看。
CoWoP 要求 PCB 做到 15-20μm 线宽/线距,而 ABF 载板早就在 5-8μm。看起来是 PCB 在“降级承接”。但难度并没有降低,只是换了一个维度。
半导体制造的逻辑是:小面积、极高精度、单片价值高、可以逐片筛选。PCB 的逻辑是:大面积、中等精度、成本敏感、靠面板摊薄。CoWoP 把两者压在同一块基底上——15-20μm 的精度要铺到 450×450mm 面板上(面积约是 300mm 晶圆的三倍),底下还叠着有机树脂、玻纤复合与多层金属的混合体系,反射率不均、厚度不一;焊完芯片之后,没有返修空间。
于是难度从“能不能做细”转移成了“能不能在大面积上一直细”。这是完全不同的工程命题:它考的不是光刻分辨率,而是整块板的一致性——层间对位、压合均匀、翘曲、CTE 匹配、缺陷密度。
同一套材料与工艺语言
CoWoP 是架构上的越界,材料与工艺的同源则是更安静、也更彻底的那一层。224G PAM4 把损耗预算压到极限:Rubin 计算板由 M7 进 M8,交换托盘用 M8U,中板与 CPX、正交背板全面进 M9,Rubin Ultra 背板的门槛是 Dk≤3.0、Df≤0.0007、CTE≤7ppm/℃。增强材料换成石英布,铜箔换成 HVLP4/5,树脂换成低损耗碳氢体系。行业试过 M9 加 PTFE:Df 更低,但 CTE 高达 112-125ppm/℃,与多层结构严重失配,良率长期只有四五成,最终退守关键信号层。
这套“低损耗、低 CTE、高平整”的选材逻辑,与 ABF 载板是同一套。M9 覆铜板单张超过 400 美元、约为 M7 的四倍——它卖的不是板,是介质性能。工艺端同理:mSAP 靠 PVD 加化学镀的薄种子层与深紫外光刻(分辨率从 30μm 提到 10μm),把线宽/线距从减成法的 50μm 以上压到 15-25μm,偏差控制在 ±1μm。这套设备与良率结构本是载板厂的语言;当 PCB 厂开始装 DUV、谈 ±1μm,两个行业就不再是两个行业,而是同一工艺谱系上的两个位置。
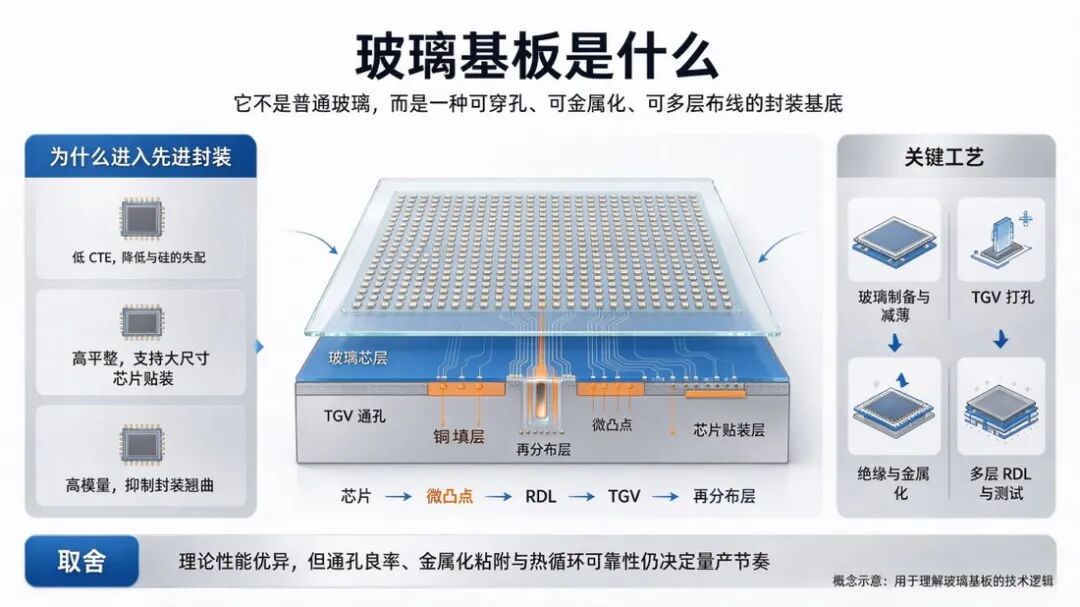
材料端的收敛更明显:玻璃用 TGV 通孔、填铜、双面积层,既解载板的翘曲与 CTE,也指向背板与光互连。玻璃、M9 体系、陶瓷三条路线看似竞争,实为分工——被同一组指标推着走:更低的 Df、更小的 CTE、更大的面积、更高的平整度。
价值在转移,风险也在转移
价值转移的方向已经清楚:ABF 载板 +82%,PCB +233%。PCB 拿走的,正是载板让出的那一段。
但承接封装功能,就要承接封装的责任。
认证从“打样几个月”变成 18-24 个月,Rubin 级认证单是流程就超过一年;新线从建成到稳定量产要 12-18 个月,初期良率低于 60% 是常态。难的不在标准本身,而在过程必须可审计:UL、IPC-6012、IATF 16949 考的是一致性有没有被记录、被追溯,而不只是最后一片板过没过检。一旦芯片直接键合在板上,良率就从成本问题变成生死问题——没有返修,一片报废就是一颗 GPU 连同若干 HBM 一起报废。
这也解释了为什么扩产凶猛而有效产能稀缺。2025 至 2026 年行业资本开支同比增长约 58%,2026 年预计再增 42%,但这笔钱买到的是厂房与设备,不是认证与良率曲线。PCB 扩产只要 6-12 个月,ABF 载板要两年——快,是本轮最大的进攻性,也可能是下一轮最脆的负债。
终局是一条梯度,不是一场替代
把上面几层收拢,判断是:PCB 不会变成载板,载板也不会被 PCB 吃掉。真正发生的是,“封装”从一个盒子,变成一条连续的梯度。
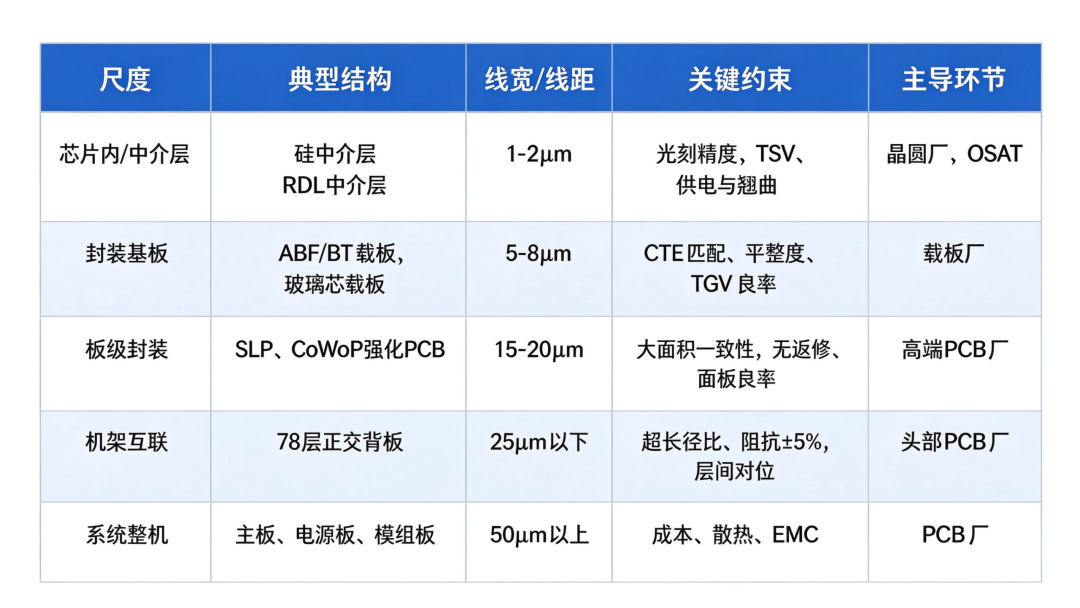
五种尺度:从芯片内到系统整机的结构、线宽与主导环节。
这条梯度上,每一格的物理约束是同一组:损耗预算、CTE 匹配、翘曲控制、良率乘以面积。变的只是尺度。所以在 5-8μm 以下、超高密度小面积的场景,硅中介层与 ABF 载板依然是主场;在 15-25μm、超大面板、要同时兼顾成本与散热的场景,SLP/CoWoP 与正交背板开始接管。这不是谁取代谁,而是同一条曲线上取不同的解。
三个风险值得记下来。一是产能潮:高端产能集中在 2026 年下半年到 2028 年释放,若 AI 资本开支增速放缓,稀缺性会被稀释。二是路线跳变:硅光与 CPO 若加速落地,今天为铜互连建的重资产,长期价值需要重估。三是时间墙:玻璃基板的时间表一再右移,提醒所有参与者——从“材料性能更好”到“能稳定交付”,中间隔着一条以年计的路。
塔尖之下,方法论正在下沉
78 层、M9、15-25μm 这些数字属于塔尖。全球能稳定交付这类板的工厂,两只手数得过来。
但绝大多数硬件团队的真实处境是另一种:一年几十个品种,每个品种几十到几百片,层数 1-36 层,材料做到 M8 及以下,HDI 到 3 阶。他们不在塔尖,却承担着同一种成本结构——一次打样失败,损失的不是一块板,是两周的窗口和一轮产品节奏。
这才是“终局”对产业更普遍的影响:塔尖抬高规格的同时,把一套方法论向下渗透——把可制造性判断从“做完再测”前移到“画之前就判”。
这件事在工程上是可以量化的。
一块板能不能做,取决于一组硬边界:外层阻抗公差 ±10%、内层 ±7%,层间对准 5mil,BGA 焊盘最小 7mil,机械孔最小 0.15mm,厚径比上限 18:1,背钻残桩 ≤10mil,压合最多 3 次,激光盲孔最小 0.1mm。这些参数过去散落在资深 CAM 工程师的经验里,靠人眼在出图前扫一遍;现在它们可以被写成规则,被工具逐条判掉。
从制造端看,这套规则不再只停留在资深 CAM 工程师的经验里。设计端的工艺窗口可以直接转化为制造端的排产参数,而不必靠邮件和电话反复确认。多品种、小批量、交期稳定,和塔尖的良率曲线,本质上是同一件事的两面:把不确定性关进流程里。
所以“PCB 的终局像先进封装”,不是一句比喻。
它说的是竞争单位变了:过去比谁的板便宜、交期快;现在比谁能把工艺窗口算清楚,把不确定性关进流程。塔尖做到封装级的一致性,腰部做到多品种的确定性,用的是同一种能力——材料、工艺、仿真、追溯,四件事同时到位。能过这一关的,不再只是“板厂”:塔尖是基底制造商,腰部是把工艺判断系统化的智造基地。这样的讨论在云栈社区里一直没有停过。
 发表于 半小时前
|
查看: 5|
回复: 0
 /1


