FPGA 代码越写越多,手边的 9K 资源逐渐不够用了,于是入手了一块 20K:
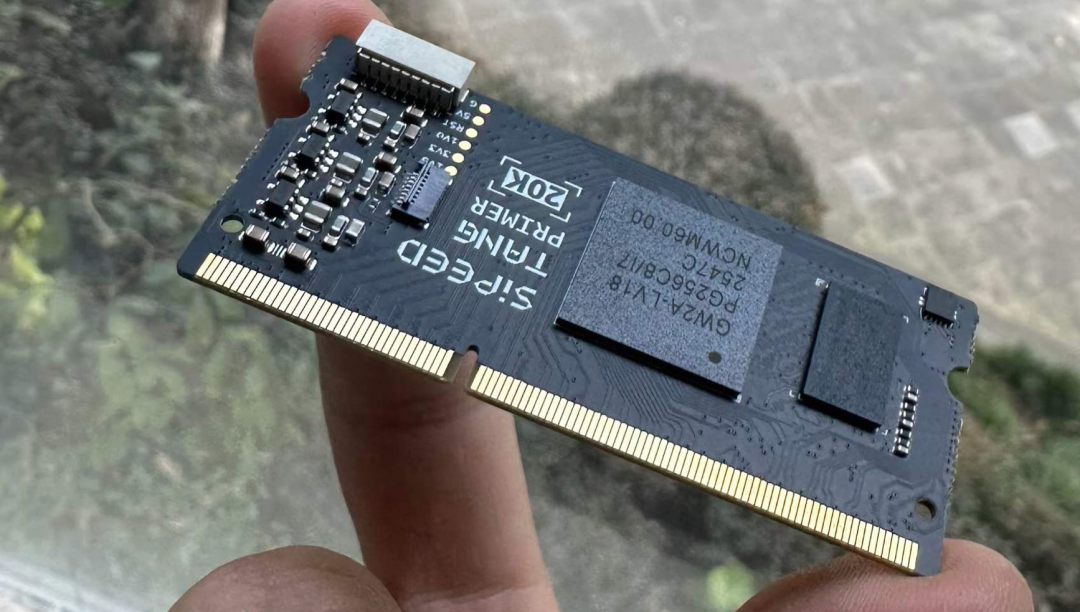
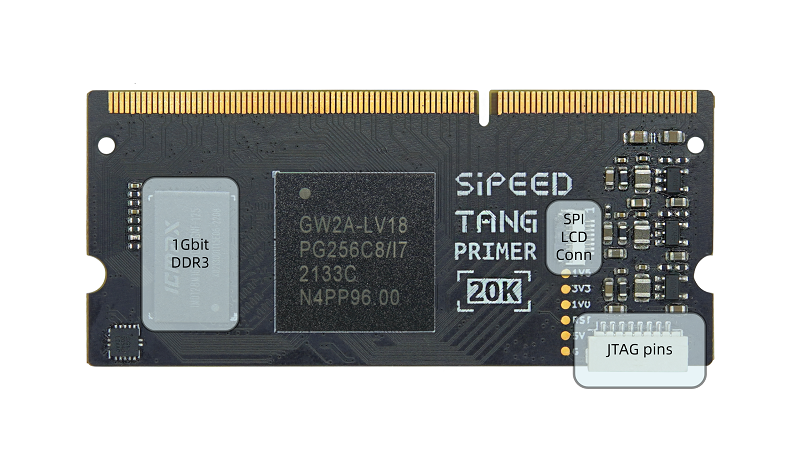
不过别看到 1Gbit 就以为是 1GB 的存储空间,实际是 128MB,算商家的障眼法吧。
其实做数据采集时,逻辑并不太难,主要因为 ADC 数据是流式的,这条链路上各个生产者与消费者的速度经常对不上。内部 BSRAM 太金贵,小 FIFO 又扛不住大抖动,所以只能上 DDR 这种大容量存储器。当然用 PSRAM 也行,只是这块板子上恰好带的是 DDR,有啥用啥,主打一个不挑食。
测试环境
我买的是带全功能底板的版本:
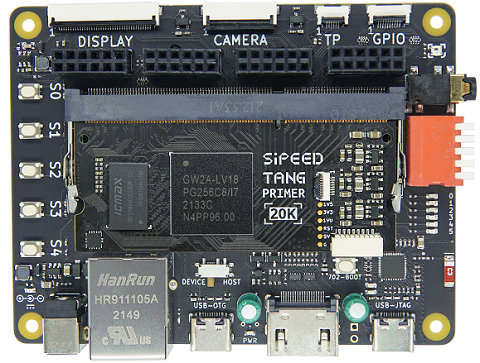
可以借助 USB 快速读取数据,调试也方便不少。
FPGA:Gowin GW2A-LV18PG256C8/I7,JTAG 识别为 GW2A(R)-18(C);
输入时钟:27 MHz;
Gowin 工具:V1.9.11.03 Education。
我使用的是官方 DDR 测试工程,另外 DDR 很复杂,使用了官方的 IP,关键配置如下:
| 参数 |
数值 |
| 物理 DDR 时钟 |
400 MHz |
| 数据传输率 |
DDR-800 / 800 MT/s |
| 外部数据宽度 |
16 bit |
用户接口时钟 clk_x1 |
100 MHz |
| 用户数据宽度 |
128 bit |
| 用户地址宽度 |
IP 端口 28 bit,示例有效使用 27 bit |
| 最大用户突发计数 |
6 bit,最多 64 个 128-bit 拍 |
| 当前测试突发 |
8 个 128-bit 拍 |
| ECC |
关闭 |
DDR3 的基本层级:Bank、Row 和 Column
DDR 内部并不是一条完全扁平的字节数组,存储单元按 Bank、Row、Column 三级组织:
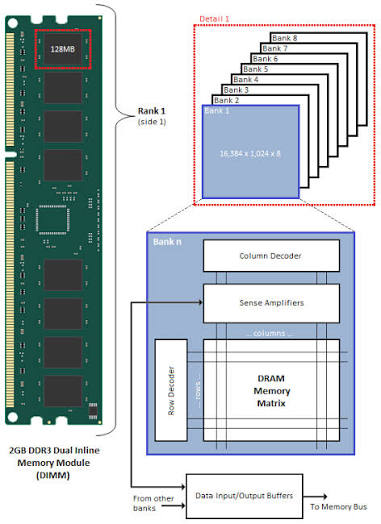
Bank:选择一组相对独立的存储阵列;
Row:选中 Bank 中的一整行,并把该行打开到 Sense Amplifier / Row Buffer;
Column:从已打开的行中选出要传输的具体位置。
一次典型读/写在物理层需要经历:ACTIVATE(bank, row) 打开整行到 Row Buffer,READ/WRITE(bank, column) 通过 DQ/DQS 完成突发传输,必要时 PRECHARGE 关闭当前 Row。
如果连续访问同一 Bank 中的同一 Row,只改变 Column,就属于 Row Hit,效率最高;如果同一 Bank 需要切换到另一 Row,就要先 PRECHARGE 再 ACTIVATE,延迟明显变大。控制器还可以交错访问不同 Bank,把激活、预充电、刷新带来的等待时间掩盖掉。
以上这些底层命令都由 Gowin DDR3 IP 处理,上层逻辑不需要自行去发 ACTIVATE、PRECHARGE 或者 REFRESH。
地址重排
操作之前,需要把线性地址转换成 DDR IP 所需的 Bank、Row、Column 排列:
assign app_addr = {
    int_app_addr[12:10],  // Bank
    int_app_addr[26:13],  // Row
    int_app_addr[9:0]     // Column
};
地址单位是 16 bit,即 2 字节:
- 地址 +1 = 前进 2 字节
- 地址 +8 = 前进 16 字节
- 地址 +64 = 前进 128 字节
上层只需要维护递增的线性地址,或者环形缓冲的读写指针即可。
以 3 bit Bank、14 bit Row、10 bit Column、16 bit 数据宽度计算:8 Bank × 16384 Row × 1024 Column × 16 bit = 2 Gbit = 256 MiB。
本次实机自动检测到 1 Gbit,也就是 128 MiB。对于未实现的最高地址线访问时,地址会发生镜像,官方测试正是利用这个现象来区分 1 Gbit 与 2 Gbit 器件。
CK、DQ、DQS 和 DM
信号分工
DDR 都属于源同步接口,发送端会把时钟一并发过去。
| 信号 |
当前宽度 |
方向 |
作用 |
CK/CK_N |
1 组差分 |
FPGA→DDR |
全局 DDR 时钟,命令与地址的时序基准 |
DQ[15:0] |
16 bit |
双向 |
真实读写数据 |
DQS[1:0] / DQS_N[1:0] |
2 组差分 |
双向 |
每个 Byte Lane 的数据选通 |
DM[1:0] |
2 bit |
FPGA→DDR |
写数据字节掩码 |
16 根 DQ 分为两个 Byte Lane:
- Lane 0:DQ[7:0] + DQS0/DQS0_N + DM0
- Lane 1:DQ[15:8] + DQS1/DQS1_N + DM1
DQS 是 Source-Synchronous Strobe:谁发送数据,谁就同时发送 DQS。
- 写 DDR:FPGA 驱动 DQ 和 DQS,DDR 接收
- 读 DDR:DDR 驱动 DQ 和 DQS,FPGA 接收
DQ 与 DQS 在 RTL 端都表现为双向端口。空闲期间 DQS 并非持续运行的时钟,而是会进入高阻或终止状态;传输前后还有 Preamble 和 Postamble。
DDR-800 的时间尺度
DDR-800 表示每秒完成 8 亿次数据传输:
UI = 1 / 800 MHz = 1.25 ns
CK 周期 = 1 / 400 MHz = 2.50 ns
DQS 的上升沿和下降沿都承载数据,因此一个 2.5 ns 周期内包含两个 1.25 ns 的数据 UI。
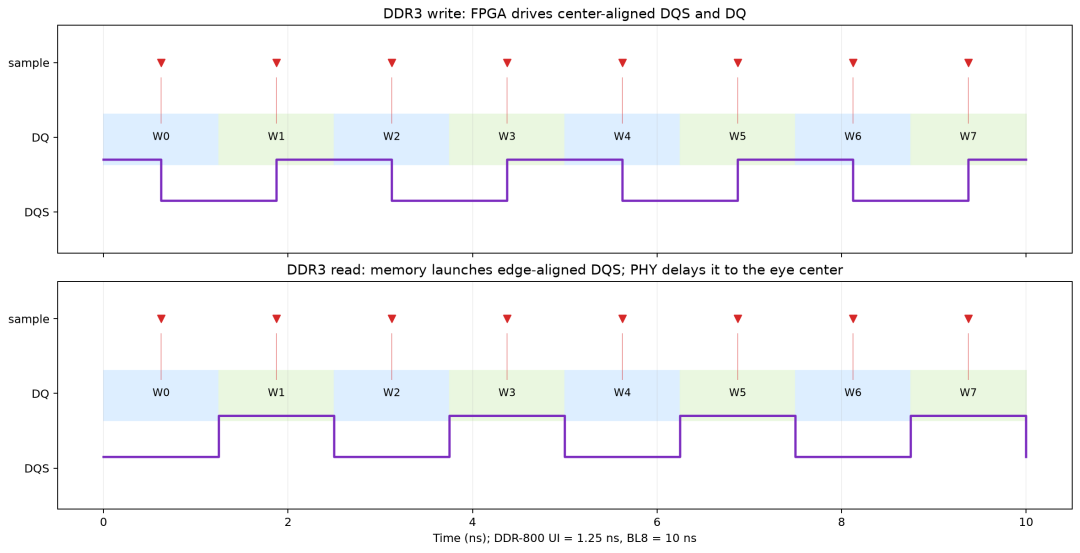
写方向
写入时,FPGA 同时产生 DQ 和 DQS。DQS 的边沿应当落在 DQ 稳定窗口的正中心:
DQ:  |====== W0 ======|====== W1 ======|====== W2 ======|
DQS:         ↑                 ↓                 ↑
              DDR采样           DDR采样           DDR采样
DQS 来得太早,DQ 的建立时间就不够;来得太晚,保持时间又不够。DDR PHY 需要调整输出延迟,让两侧都留出充足余量。
读方向
读取时,DDR3 器件发送 DQ 与 DQS。DDR 输出的 DQS 边沿通常贴近 DQ 数据边界,FPGA 内部 PHY 会对 DQS 或数据路径增加延迟,把实际采样点搬到数据眼中心:
DQ数据边界: |----W0----|----W1----|----W2----|
原始DQS:     ↑          ↓          ↑
PHY采样点:        ↑          ↓          ↑
因为两个 Byte Lane 的走线与内部路径不同,DQS0 和 DQS1 往往需要不同的延迟 Tap;支持细粒度 Deskew 的 PHY 还可能逐 DQ 位调整。
BL8 与 128-bit 用户数据
DDR3 的 BL8 包含 8 个 DQS 有效边沿,每个边沿传输 16 bit:8 边沿 × 16 bit = 128 bit = 16 字节。
因此 Gowin 用户接口的一拍 app_data[127:0] 正好对应一次物理 BL8 传输。测试器再把 8 个 128-bit 用户拍组合成一个 128 字节事务。
DDR 天然适合突发传输,因为不需要每次都重新发送地址,直接连续干活就行。
DDR 需要校准
校准的目的是在上电时自动寻找可靠的高速采样时序。DDR-800 每个 UI 只有 1.25 ns,而 FPGA 内部延迟、封装、PCB 走线、DDR 封装、温度、电压以及工艺差异,都会改变 DQ、DQS 与 CK 的到达时间。一旦采用固定延迟,采样边沿很可能贴近数据跳变点。
典型的初始化与训练流程包括:等待 PLL 锁定;按 JEDEC 时序释放 DDR 复位与 CKE;配置 DDR 模式寄存器;执行阻抗/ZQ 相关初始化;寻找读 DQS 门控窗口;扫描输入延迟并寻找有效读窗口;调整写方向 DQ/DQS 相位;必要时执行 Write Leveling 或 Byte Lane 校准;选择有效窗口中间的 Tap;最终拉高 init_calib_complete。
本工程的 Gowin DDR 控制器源码是加密的,不清楚具体怎么校准,但应用逻辑只有在 init_calib_complete=1 之后才能安全发出读写命令。
所谓的训练,其实可以理解为一维数字眼图扫描:做一次遍历,校准成功只代表找到了一个可用窗口。
实测结果
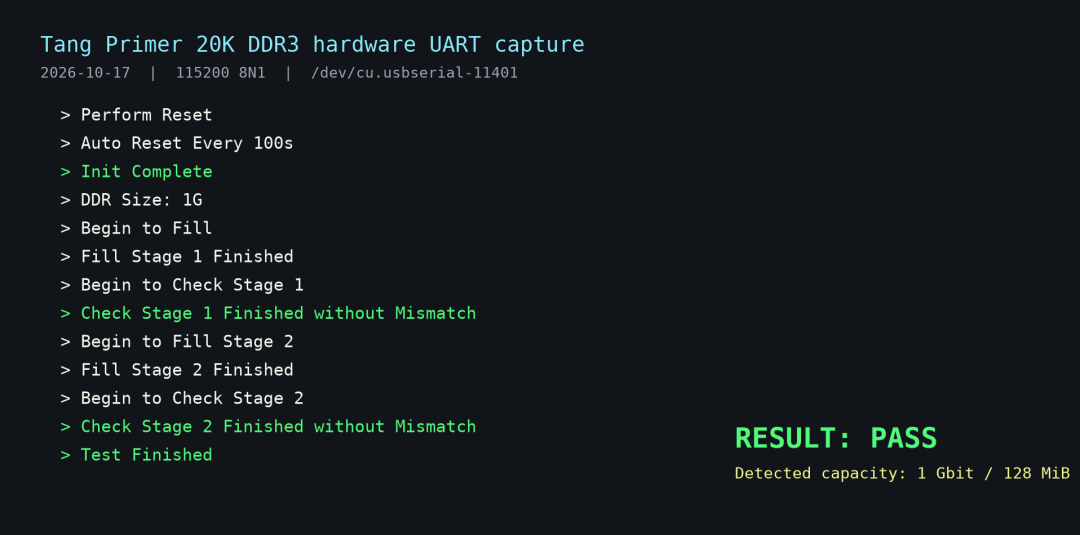
DDR PHY 初始化与校准成功;板载 DDR 容量为 1 Gbit,即 128 MiB;第一轮全地址范围写入读回无 Mismatch;第二轮依然无 Mismatch;测试最终进入 Test Finished。
实际布局布线与 STA 结果
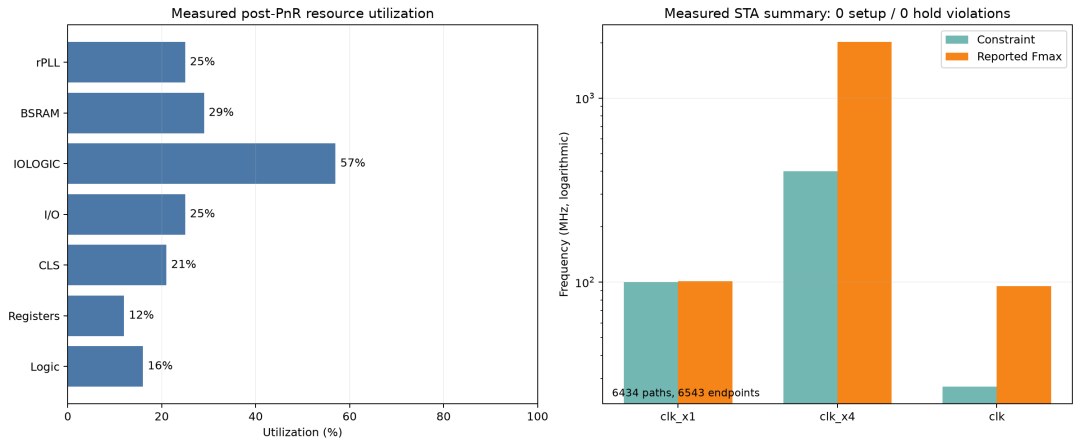
以上数据来自 Gowin 报告。
资源
| 资源 |
使用量 |
总量 |
利用率 |
| Logic |
3313 |
20736 |
16% |
| Register |
1918 |
16173 |
12% |
| CLS |
2164 |
10368 |
21% |
| I/O Port |
50 |
207 |
25% |
| IOLOGIC |
118 |
207 |
57% |
| BSRAM |
13 |
46 |
29% |
| rPLL |
1 |
4 |
25% |
DDR PHY 使用到的资源:IDES8_MEM:16;OSER8:23;OSER8_MEM:20;IODELAY:39;DQS 资源:2/9;DLL:1/4。
这些资源正是并串转换、输入采样以及 DQS/DQ 延迟校准的硬件基础。
时序
STA 分析结果:
| 项目 |
结果 |
| 分析路径 |
6434 |
| 分析端点 |
6543 |
| Setup 违例端点 |
0 |
| Hold 违例端点 |
0 |
| 时钟 |
约束 |
报告 Fmax |
clk_x1 |
100.000 MHz |
100.858 MHz |
clk_x4 |
400.000 MHz |
2016.128 MHz* |
clk |
27.000 MHz |
95.172 MHz |
什么是 DDR 眼图?
眼图是把大量高速数据波形按一个或两个 UI 折叠叠加。不同数据模式、抖动、噪声、反射和码间串扰,会共同形成一个类似眼睛的空白区域。我个人觉得最直观的理解方式就是下面这张图——本质上是把大量单次采样的结果叠加在一起,用来研究高速系统的性能。
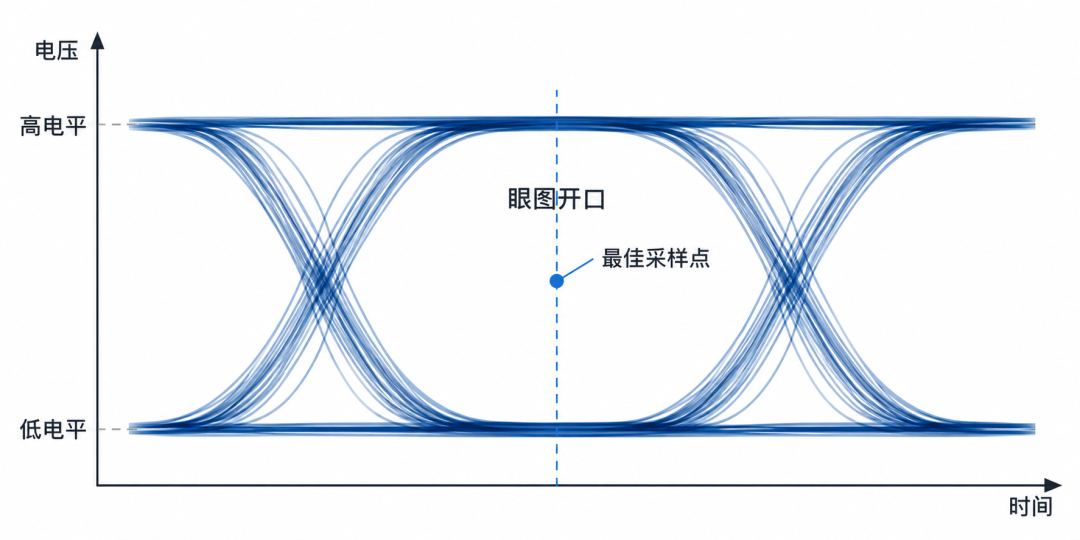
高低电平之间必然存在一个最稳定的采样点,这个图形就是眼图。主要指标包括:
眼宽:可用采样时间裕量;
眼高:电压和噪声裕量;
交叉点扩散:时间抖动;
上下轨迹扩散:电压噪声;
多条不同斜率轨迹:码间串扰和模式相关效应;
过冲/下冲:阻抗不连续、反射或驱动过强;
眼闭合:采样可靠性下降。
对 DDR-800 来说,一个 UI 只有 1.25 ns,最佳采样点通常靠近眼图中心。校准的作用,就是在有限延迟 Tap 中寻找可用窗口,并尽可能把采样边沿放到中央位置。
Python 眼图模拟
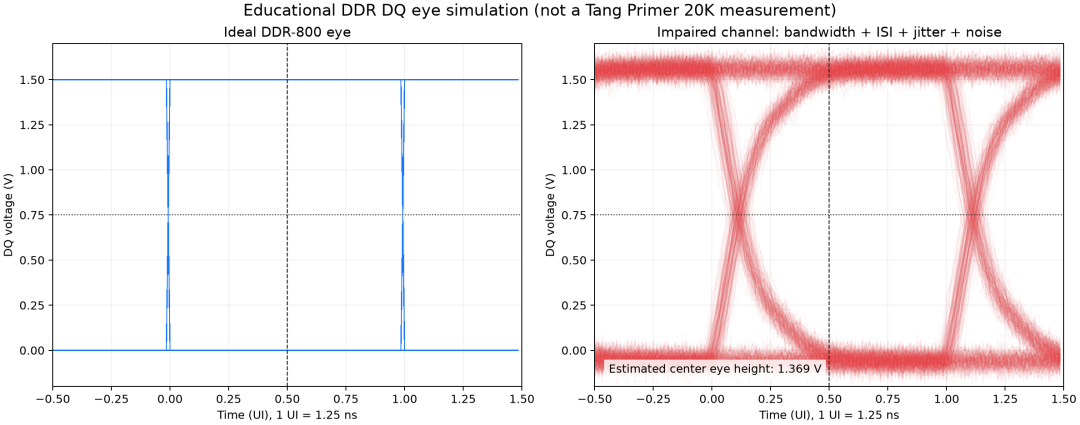
左图为理想 DDR-800 NRZ 信号,右图为加入通道损伤后的模型。仿真参数如下:
| 参数 |
数值 |
| 数据速率 |
800 MT/s |
| UI |
1.250 ns |
| VDDQ 模型 |
1.5 V |
| 随机比特 |
5000 |
| 每 UI 采样点 |
64 |
| 叠加轨迹 |
900 |
| 随机抖动标准差 |
22 ps RMS |
| 周期抖动峰值 |
18 ps |
| 通道一阶时间常数 |
105 ps |
| 延迟反射 |
0.30 UI,幅度 8% |
| 周期干扰 |
25 mV |
| 随机电压噪声 |
35 mV RMS |
| 随机种子 |
7768 |
模型搭建步骤:产生随机 NRZ 比特;为每个比特边界添加高斯随机抖动;叠加低频周期抖动;用两级近似低通通道限制边沿速度;加入延迟反射,模拟阻抗不连续造成的 ISI;加入周期性电源相关干扰;加入随机电压噪声;把波形折叠为两 UI 窗口并叠加;在 0.5 UI 中心计算低电平 99 百分位与高电平 1 百分位的差值。
小结
DDR 是便宜量大的内存方案,在速度、容量和可操作性之间取得了不错的平衡,但最大的问题就是线多。实际使用时并不需要精确处理物理地址结构,只需关注:当前写指针;当前读指针;缓冲区是否满或空;每次突发包含多少数据;后端是否已经消费这些数据。所以整体并不麻烦。
对上层应用而言,DDR 基本可以抽象成一个容量为 128 MiB、每次推荐读写 128 字节的大型环形 FIFO。
另外也简单聊了下眼图。高速接口的评估本质上就是这样:用相同的输入叠加大量输出采样结果,来评估传输性能到底如何。
 发表于 2 小时前
|
查看: 3|
回复: 0


